vLLM 0.32.0 升级实测:DeepSeek-V4.1-Flash 在八卡 H20-3e 上快了多少¶
DeepSeek-V4.1-Flash 是采用混合专家与 Engram 条件记忆的开放权重多模态模型。此前的八卡部署文章使用模型发布时的固定支持构建。本次保持原版模型权重,比较那个构建与 vLLM 0.32.0,回答一个实际运维问题:看过新版性能提升的讨论之后,现有 H20-3e 服务是否值得升级?
本轮同机串行完成 60 轮、1,968 个正式请求。8K 输入、并发 8 的输出吞吐提高约 123%,单并发长输出基本持平;旧版和新版分别有 6/984、11/984 个请求未返回有效文本。新版的收益主要出现在长输入和较高并发,完整输出检查仍是升级验收的一部分。
1. 为什么做这次升级实验¶
最近围绕 vLLM 新版的公众号和公开文章讨论很多,这次实验从这些讨论出发,技术依据回到原始资料。vLLM 团队在 2026 年 10 月 7 日的官方文章中报告了 AgentX 场景的显著提升,摘要给出低并发 1.9 倍、150 TPS 约束下吞吐 5.3 倍的结果。这篇文章早于 0.32.0 发布,比较的是其特定优化配置与官方 Day 0 实现,不能理解成任何机器升级到 0.32.0 都能获得同样倍数。官方性能文章
0.32.0 于 10 月 18 日发布,发布说明包含 Hopper/SM90 优先选择 Humming 的默认变化,并锁定 humming-kernels==0.1.17。0.32.0 Release
因此实验不做“最新版与任意旧版”的比较,而是恢复此前文章的具体镜像,再换成固定 0.32.0 镜像。没有使用滚动 nightly,也没有更换为 DeepSeek-V4.1-Flash-1017。
2. 哪些条件相同,哪些条件随升级变化¶
| 条件 | 本轮配置 |
|---|---|
| 模型 | deepseek-ai/DeepSeek-V4.1-Flash,快照 fb2764a5cf321eaa5070ca8f9e892818f477c16d |
| GPU | 单节点 8×H20-3e;每卡报告 143,771 MiB;GPU 两两 NV18 |
| 驱动 | 580.126.20 |
| 并行 | Tensor Parallelism,张量并行 TP8;启用 Expert Parallelism,专家并行 EP |
| CPU / 内存 | 请求 64 CPU、512 GiB;上限 128 CPU、1,024 GiB;共享内存 64 GiB |
| 服务上限 | 上下文 32,768;运行序列 32;批处理 Token 上限 8,192;显存利用比例 0.85 |
| 权重与缓存 | 同一只读共享存储;Engram 保留在 GPU;文本前缀缓存关闭;未配置 DSpark 推测解码 |
| 客户端 | 同一个固定客户端镜像、Tokenizer、严格流式适配器及逐轮随机种子 |
| 请求接口 | /v1/completions;固定输入与输出长度,温度 0,--ignore-eos |
| 软件 | 原文章构建 | vLLM 0.32.0 |
|---|---|---|
| 实际 vLLM 版本 | 0.1.dev1+g79a7108d9 |
0.32.0 |
| 源码提交 | 79a7108d9aea27ddab99ce1779290d300b17fc23 |
5df63a7203cdb9328d824a27b682e77c7b9928be |
| Torch | 2.13.0+cu130 | 2.13.0+cu130 |
| Transformers | 5.17.0 | 5.19.0 |
| FlashInfer | 0.6.18 | 0.7.0.post1 |
| 已安装 Humming | 0.1.12 | 0.1.17 |
| 镜像 Digest | sha256:11d2c94063827768882b3a9ba2deca6c6e4fd9492753b651517c87f1fea916cb |
sha256:6ee133356d49ed24cee03dd0cda3d3980279a11c107ce3e752c89e76540f41c9 |
相同命令不等于相同执行路径¶
两版使用以下相同的显式启动参数,/model 代表挂载后的模型目录:
vllm serve /model \
  --served-model-name deepseek-v41-flash \
  --tensor-parallel-size 8 \
  --enable-expert-parallel \
  --max-model-len 32768 \
  --max-num-seqs 32 \
  --max-num-batched-tokens 8192 \
  --gpu-memory-utilization 0.85 \
  --tokenizer-mode deepseek_v41 \
  --reasoning-parser deepseek_v41 \
  --tool-call-parser deepseek_v41 \
  --enable-auto-tool-choice \
  --engram-config '{"cpu_offload":false}' \
  --no-enable-prefix-caching \
  --host 0.0.0.0 --port 30000
检查实际日志后,发现新版默认启用了 SWA bounded replay,即滑动窗口注意力的有界重放。旧构建源码中没有 swa_bounded_replay 配置项;新版日志明确说明,eager Prefill 中第 20 层为全部 Token 写入 KV,其余相关计算与第 21–39 层只处理每个请求末尾 128 个 Token。关闭前缀缓存并不会自动关闭这条 decoder 优化路径。
新版还实际记录了 HummingMxfp8LinearKernel 与 HummingGroupedExperts 的选择。因此,这次测量的是镜像、依赖和默认执行策略一起升级后的效果,不能把某个提升百分比全部归给 Humming。若要分离 SWA bounded replay 的贡献,需要另做开关对照;这不在本轮两组实验中。官方也说明 bounded replay 并非逐位精确重算,性能收益之外仍需业务质量回归。有界重放的实现说明
3. 怎么测,失败怎么计算¶
本轮包含 10 个“输入长度×输出长度×并发”场景,每个版本各做 3 轮正式测量。C1、C8、C32 每轮分别发 8、16、64 个请求,场景预热单列。所有正式请求的输入指纹逐轮配对一致。
输出吞吐来自成功返回的输出 Token 数除以该轮测量时间。TTFT 为 Time to First Token,本文客户端具体测量首段非空文本的等待;TPOT 为 Time per Output Token;E2E 为端到端耗时。表格先在每轮计算 P95,再取三轮中位数,不是把所有请求拼起来计算一次 P95。
成功条件包括 HTTP 200、流式结束标志、非空文本、有效 usage 及指定输出长度。失败保留在原请求分母中;含失败的场景仍列出观测吞吐,但不进入无失败场景的升级收益图。
空文本失败没有有效的首内容延迟,因此延迟分位数只覆盖有效响应;失败数与原请求分母另外展示。吞吐保留该轮完整测量时间,不因失败删掉一段耗时。
首批执行曾因编排器把预热错误算入正式失败保护,提前停止部分新版场景。补测修复计数逻辑后,每个场景独立完成三轮。原节点已经被其他任务使用,因此本轮两版均在另一台同规格节点重新配对,不把不同节点的轮次拼成一个中位数。阶段超时、服务失联、CUDA/NCCL/OOM 与跨节点独立看护负责终止和清理;编排成功与请求成功分别统计。
4. 吞吐:长输入收益明显,单并发长输出接近持平¶
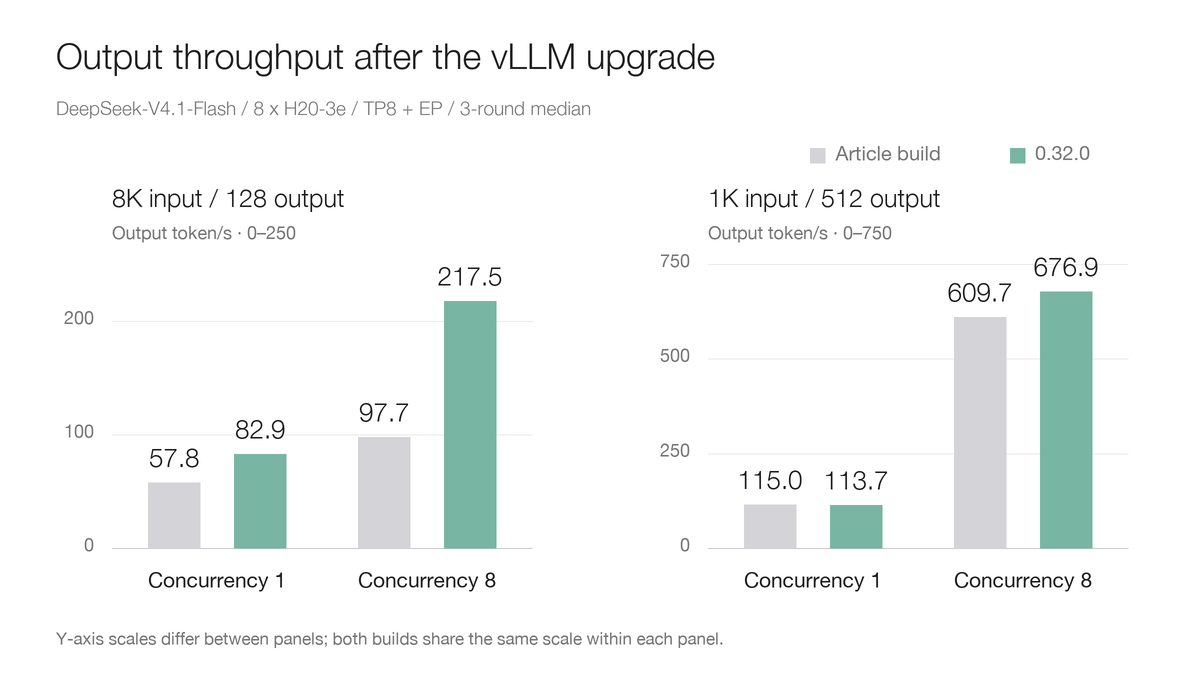
左右面板分别展示长输入和长输出,纵轴刻度不同;每个面板内两版使用相同刻度。柱高为三轮中位数,各轮数值保留在公开数据文件中。
单位为输出 Token/s。† 表示该版本的三轮中至少一轮包含失败请求,吞吐只是原分母下的观测值;此类场景不列升级增幅。
| 输入→输出 / 并发 | 原文构建 | 0.32.0 | 无失败场景增幅 | 原文成功请求 | 新版成功请求 |
|---|---|---|---|---|---|
| 1,024→128 / C32 | 615.73† | 1,015.77† | — | 191/192 | 190/192 |
| 8,192→128 / C1 | 57.76 | 82.94 | +43.6% | 24/24 | 24/24 |
| 8,192→128 / C8 | 97.69 | 217.46 | +122.6% | 48/48 | 48/48 |
| 8,192→128 / C32 | 106.52† | 263.14† | — | 190/192 | 190/192 |
| 1,024→512 / C1 | 115.00 | 113.69 | −1.1% | 24/24 | 24/24 |
| 1,024→512 / C8 | 609.73 | 676.93 | +11.0% | 48/48 | 48/48 |
| 1,024→512 / C32 | 1,222.29 | 1,576.39† | — | 192/192 | 190/192 |
| 24,576→128 / C1 | 27.74† | 52.25† | — | 23/24 | 23/24 |
| 24,576→128 / C8 | 35.10 | 87.57† | — | 48/48 | 47/48 |
| 24,576→128 / C32 | 35.78† | 94.78† | — | 190/192 | 189/192 |
8K/C8 的新版吞吐为原来的 2.23 倍,对应“提高 122.6%”,不是“提高 2.23 倍”。相反,1K→512/C1 从 115.00 变为 113.69 Token/s,约下降 1.1%;三个短时重复不足以把这个小差异认定为稳定回退。
固定长度请求的吞吐同时受 Prefill 等待与 Decode 速度影响。新版更快地处理长输入,能减少首内容等待,也能更快把后续请求送进解码;这不意味着每个请求生成下一个 Token 都按同样比例变快。
延迟也要按请求形状看¶
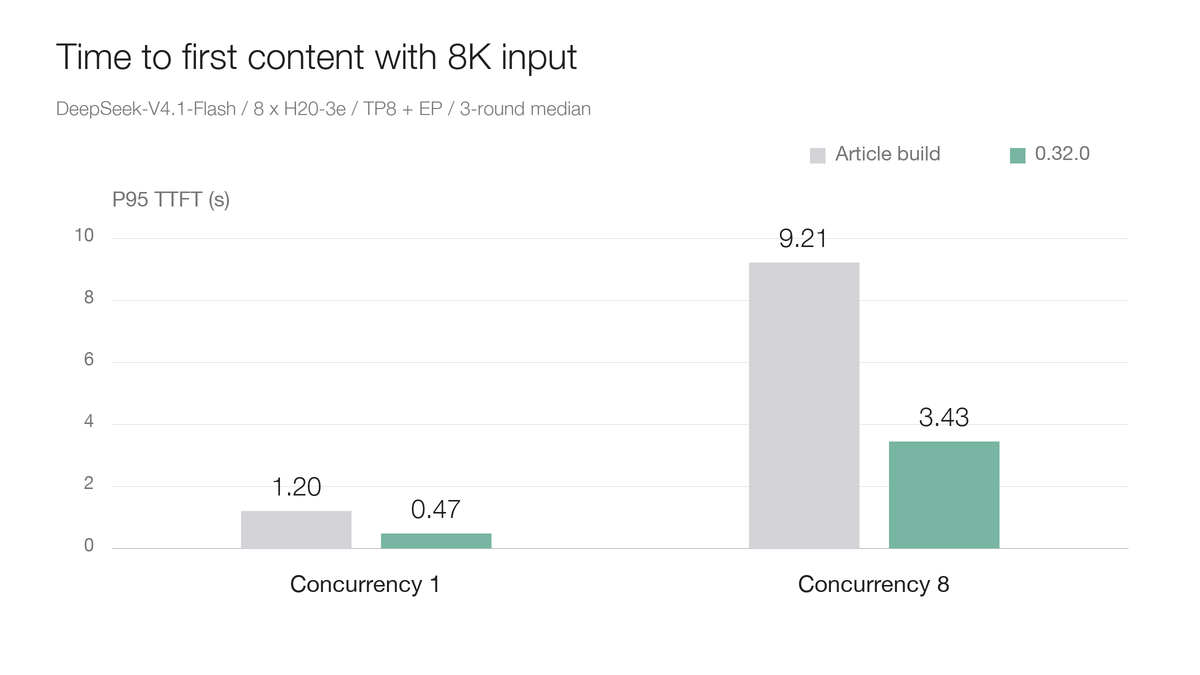
| 场景 | 原文 P95 TTFT 秒 | 新版 P95 TTFT 秒 | 原文 P95 TPOT 毫秒 | 新版 P95 TPOT 毫秒 |
|---|---|---|---|---|
| 8K→128 / C1 | 1.197 | 0.472 | 8.098 | 8.456 |
| 8K→128 / C8 | 9.206 | 3.429 | 72.662 | 32.852 |
| 1K→512 / C1 | 0.196 | 0.165 | 8.342 | 8.520 |
| 1K→512 / C8 | 1.177 | 0.564 | 12.606 | 11.430 |
8K/C8 的 P95 首内容等待缩短约 62.8%。单并发长输出的 TPOT 却没有同步改善,说明长输入服务和低并发持续生成应分别评估。
首批已完成的配对结果¶
下面三个场景来自前一批同机 A/B 测量,各有三个完整正式轮次;与本轮使用不同的物理节点,单独保留,不合并成同一轮统计。
| 输入→输出 / 并发 | 原文输出 Token/s | 新版输出 Token/s | 增幅 | 每版成功请求 |
|---|---|---|---|---|
| 1,024→128 / C1 | 102.53 | 103.80 | +1.2% | 24/24 |
| 1,024→128 / C8 | 400.88 | 535.18 | +33.5% | 48/48 |
| 4,096→128 / C32 | 203.22 | 463.20 | +127.9% | 384/384 |
4K/C32 使用每轮 128 请求;P95 TTFT 的三轮中位数为 15.271→5.826 秒,P95 TPOT 为 142.979→63.282 毫秒。这一组支持“中等输入、高并发有收益”的观察,但不是跨节点横向排名。
5. 速度提高了,为什么还有失败¶
| 本轮正式统计 | 原文构建 | 0.32.0 |
|---|---|---|
| 执行轮数 | 30/30 | 30/30 |
| 全部请求成功的轮数 | 25 | 21 |
| 包含失败请求的轮数 | 5 | 9 |
| 成功请求 | 978/984 | 973/984 |
| 失败请求 | 6/984,0.61% | 11/984,1.12% |
这 17 个失败请求都返回了 HTTP 200、[DONE] 和正数 completion_tokens,但所有 choices[].text 始终为空。比如一条失败流的关键字段如下,已省略 ID 和时间戳:
HTTP 200
data: {"choices":[{"text":""}]}
...
data: {"usage":{"prompt_tokens":1024,"completion_tokens":128,"total_tokens":1152}}
data: [DONE]
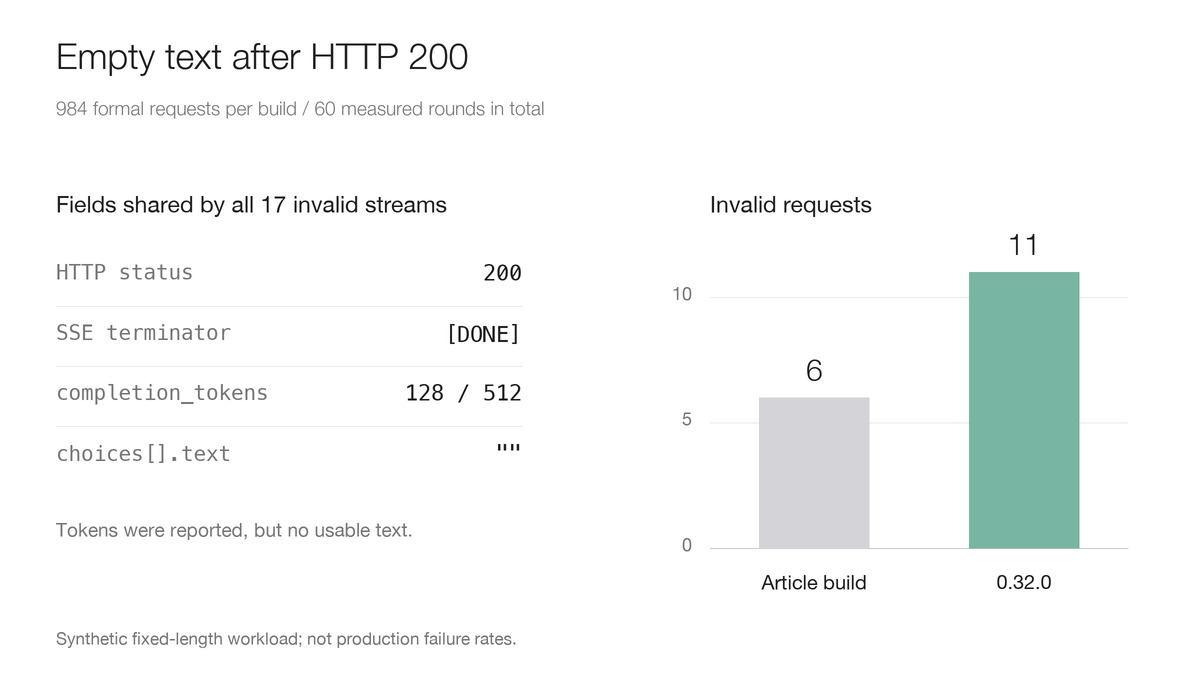
因此,vllm bench 子进程退出码为 0、服务健康检查成功,都不足以证明这轮业务输出成功。严格客户端将这些请求判失败,没有把 usage 中的 128 或 512 个 Token 直接当成用户收到的有效文本。
两版均能出现该现象。目前证据定位到合成固定长度 Prompt 的生成、特殊 Token、解码与流式输出这条路径,尚未分离根因;不能据此认定 GPU 崩溃、Humming 错误或单一版本回归。0.61% 与 1.12% 也是本轮合成负载的观察比例,不是生产故障率或统计显著性结论。
进一步排查应固定失败输入,保留 token IDs,比较非流式与流式、Token 解码前后,以及自然语言 Prompt 对照;再分别切换相关优化。不要同时换模型、Prompt 和采样参数后用一次成功覆盖原失败。
首批开放到达率 0.300 req/s 的三轮也出现失败请求,触发保护;0.480 和 0.660 两档保留为未执行,没有据此给出 SLO 容量上限。SLO 为 Service Level Objective,服务等级目标;本轮主要回答版本对比,不提供正式生产容量承诺。
6. 实际监控中发生了什么¶
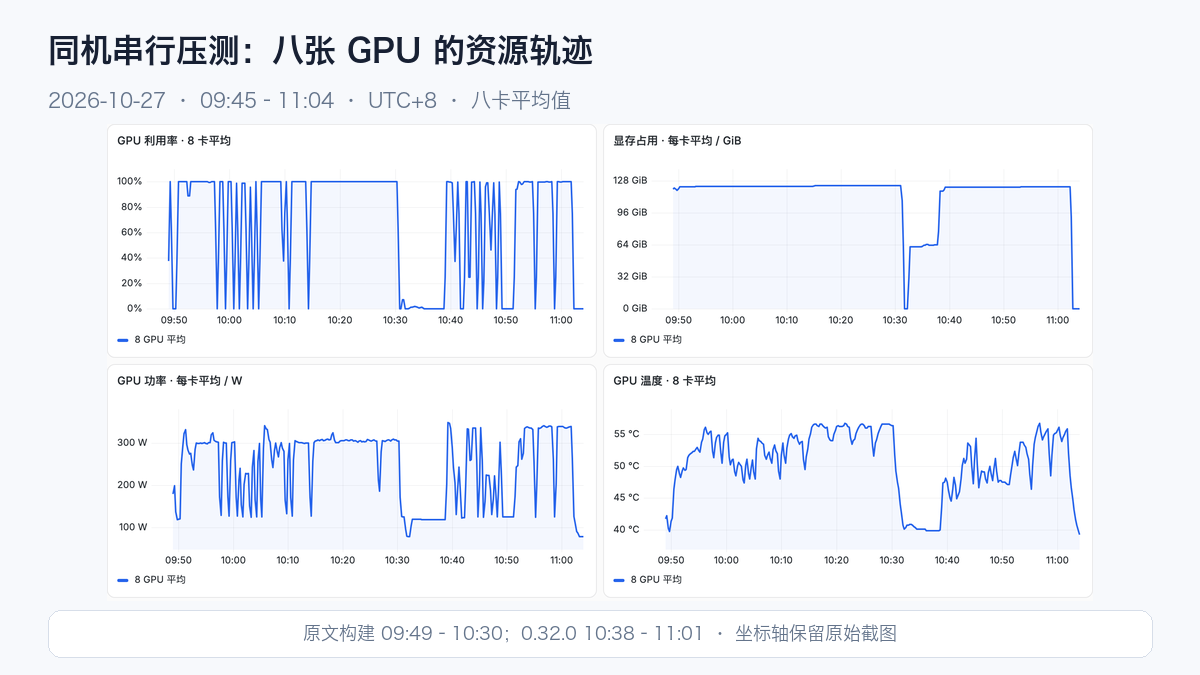
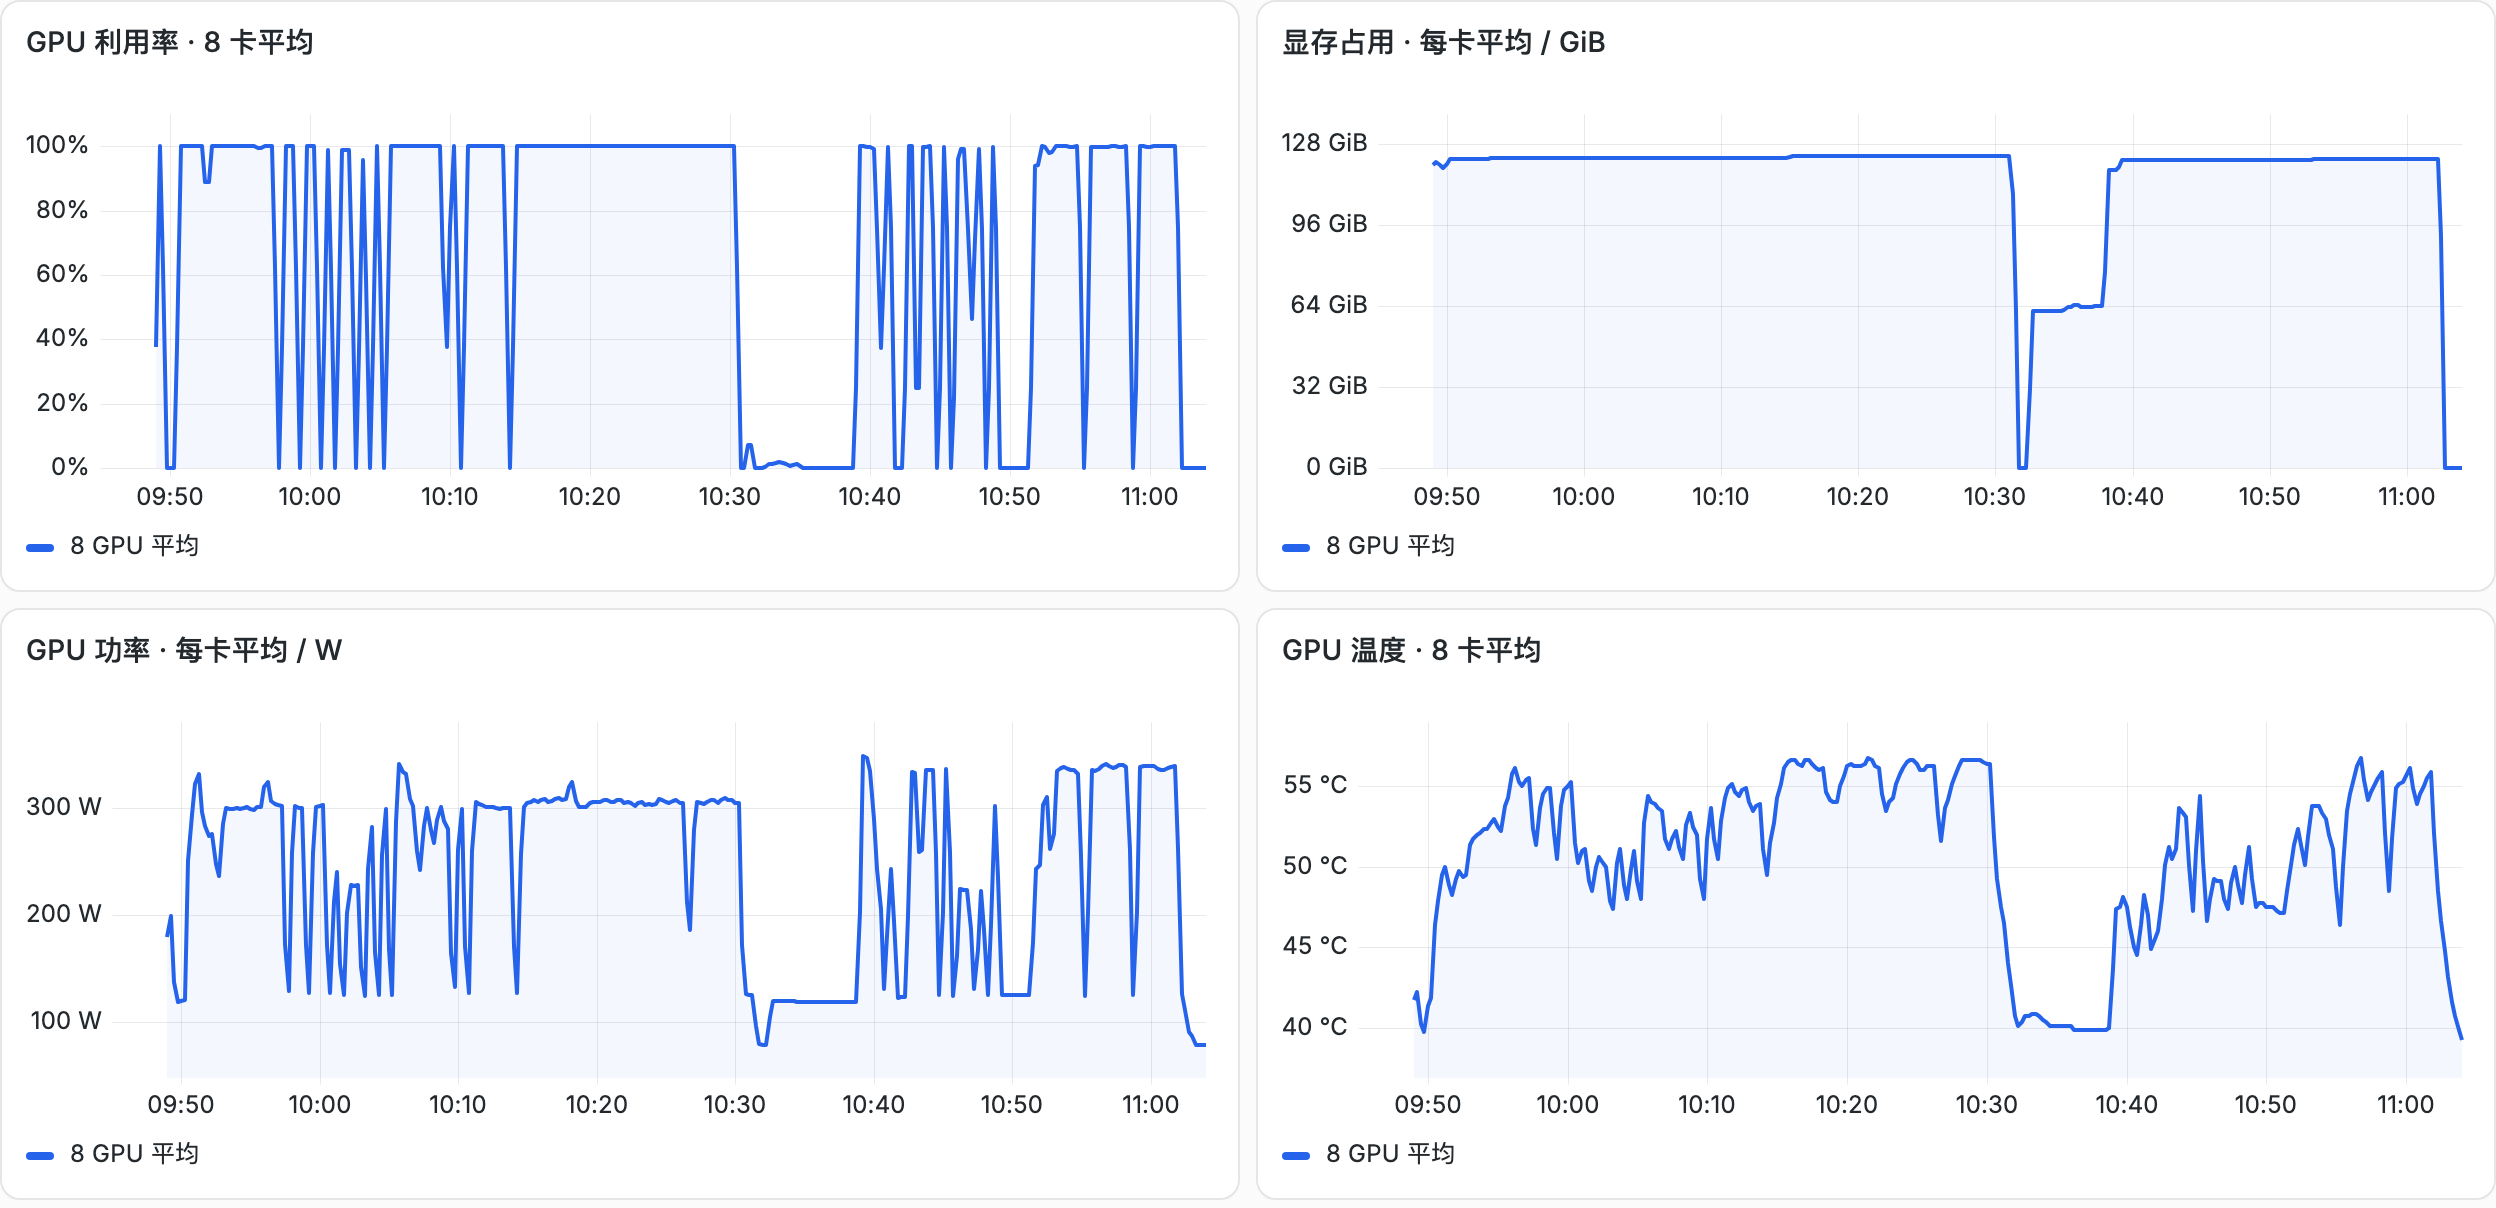
图中时间为 2026-10-27 09:45–11:04,UTC+8。原文版本正式场景约在 09:49–10:30,新版约在 10:38–11:01。中间的显存下降与重新上升对应版本切换、权重加载和初始化,不能解读成模型持续运行时的显存抖动。资源图取八卡平均;更短的测试区间也不自动等于精确节电比例。
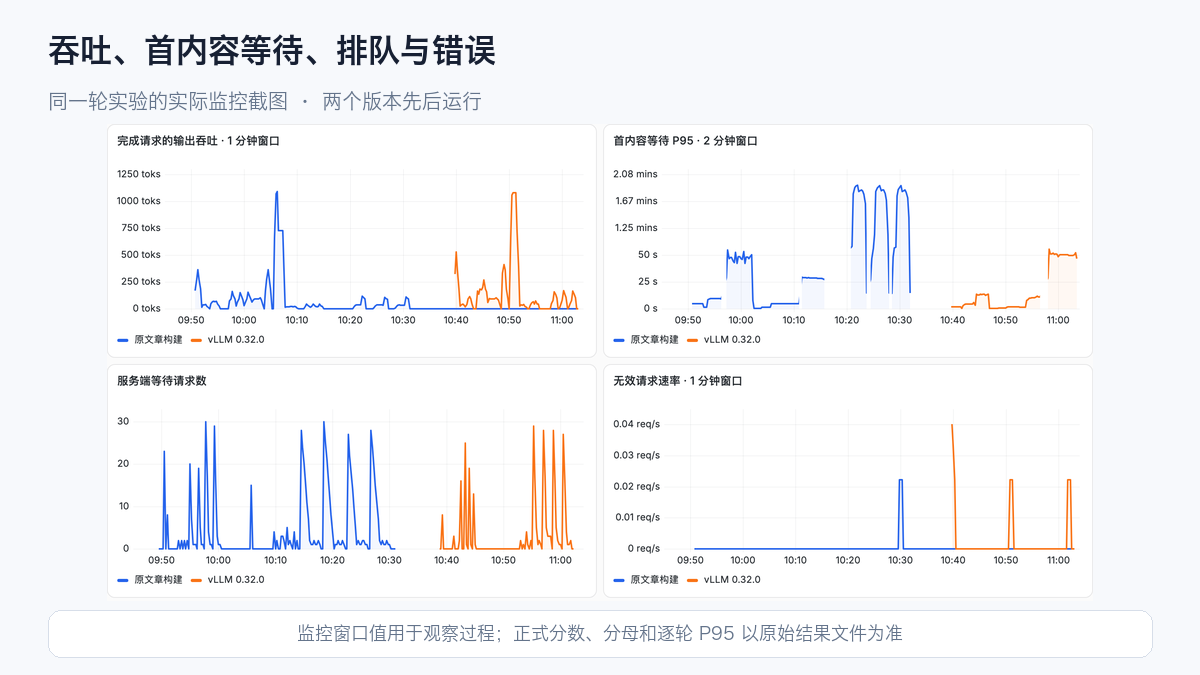
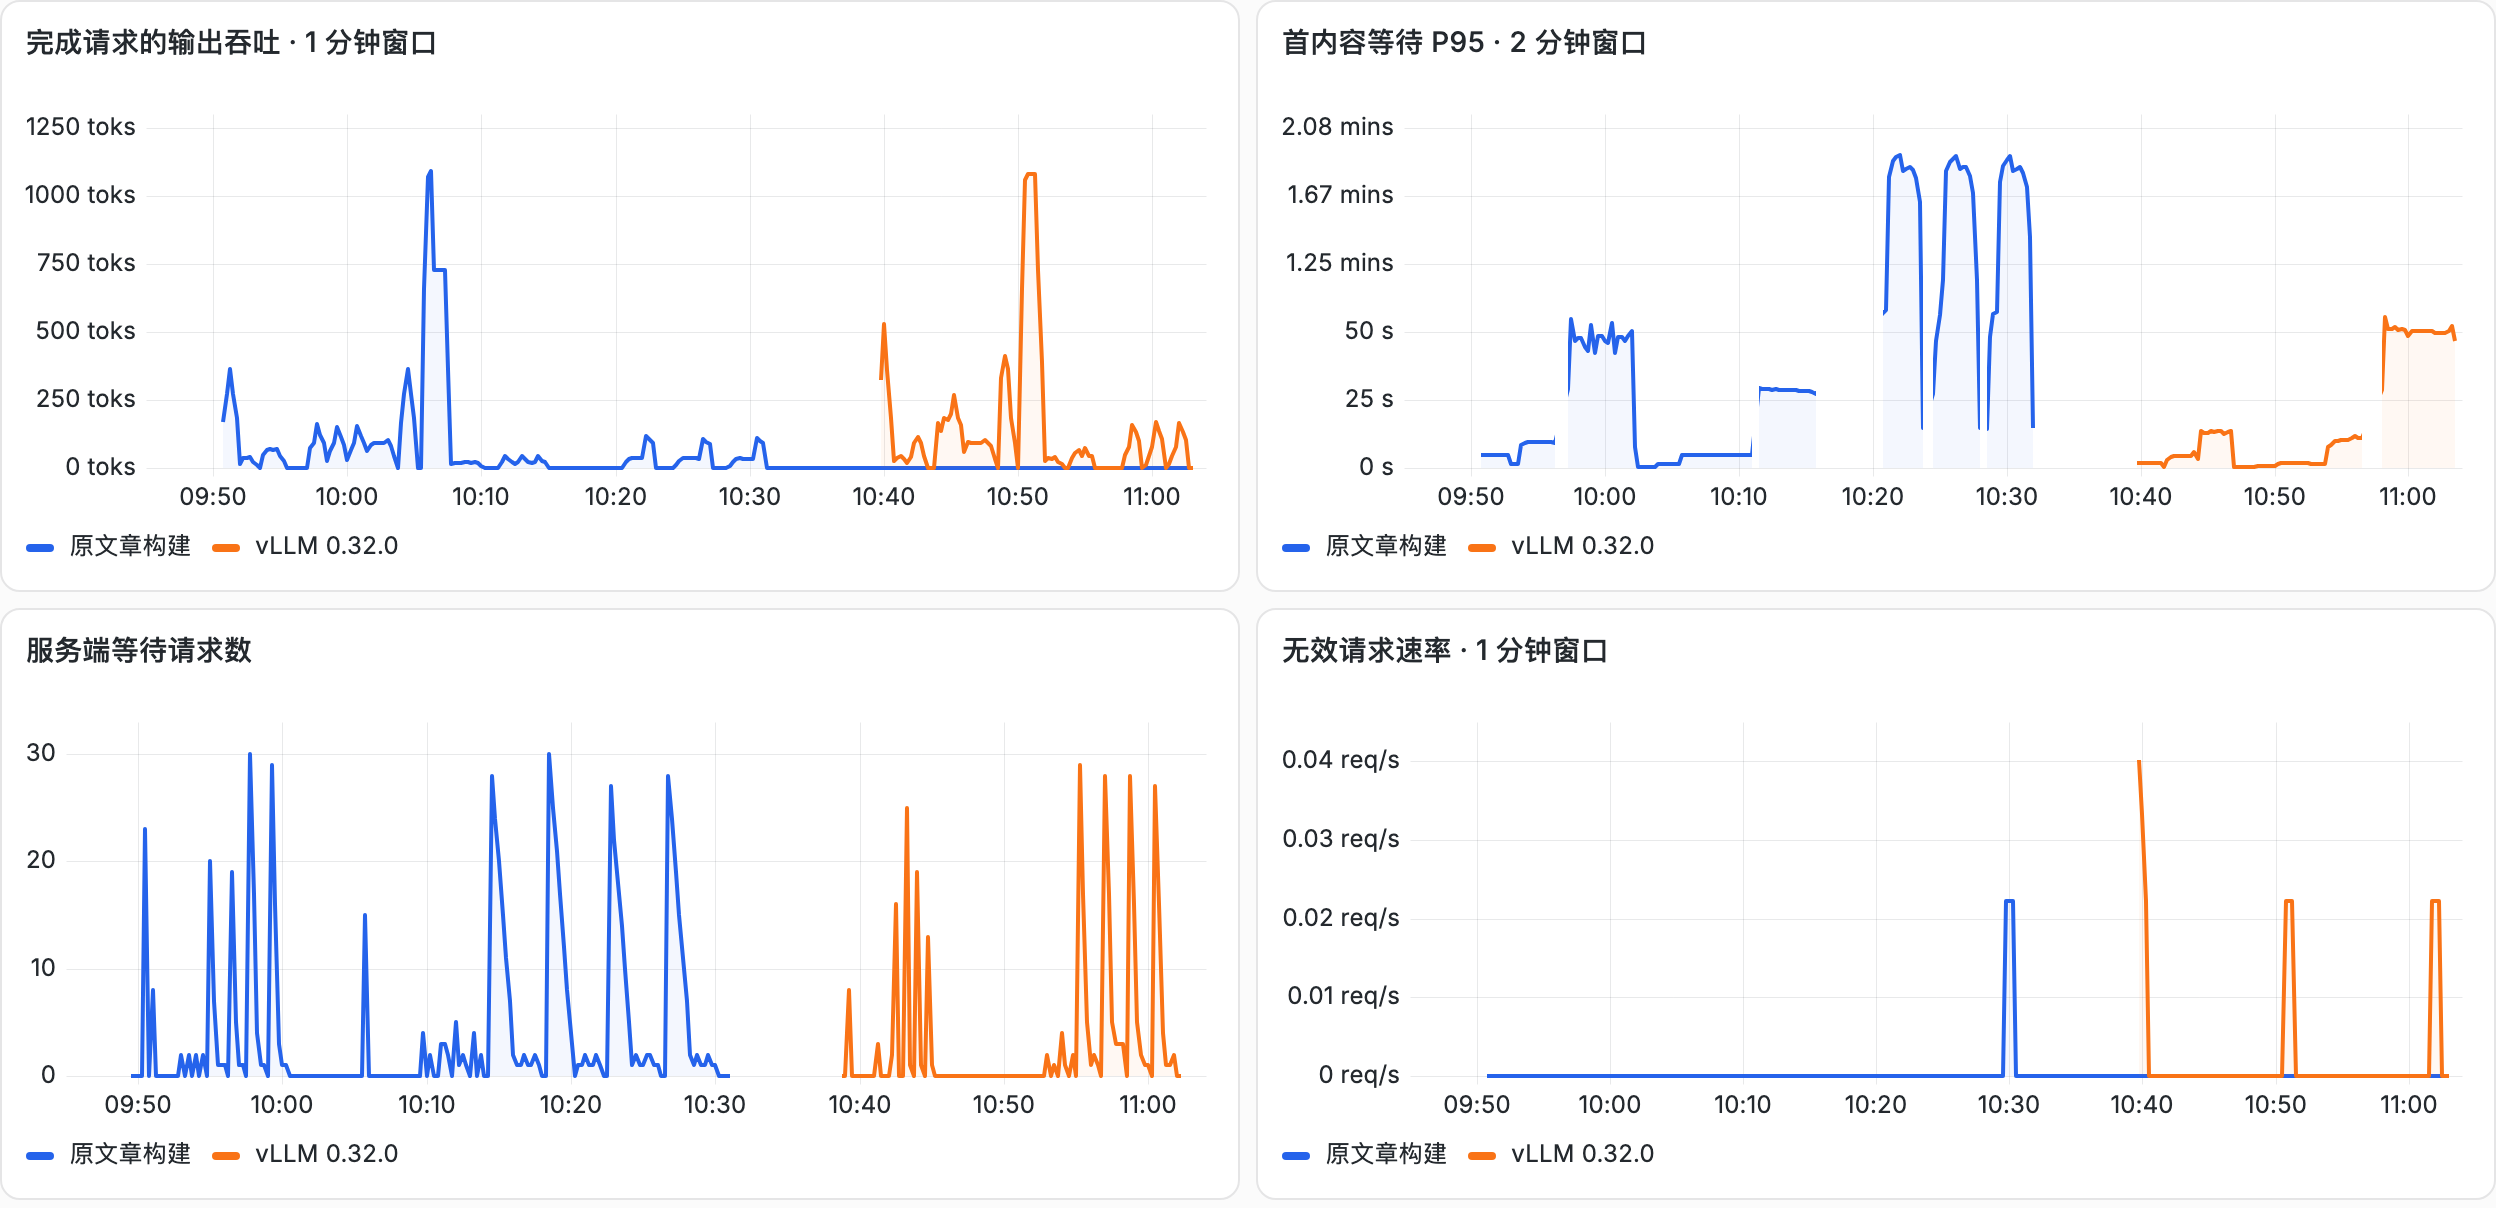
蓝色为原文构建,橙色为 0.32.0,两者串行运行。两组按相同场景顺序执行,但每个场景耗时不同,因此不能拿同一个横坐标时刻直接比较。窗口吞吐会受请求集中完成影响;监控 P95 来自直方图窗口,与表格的逐轮精确 P95 口径不同。错误速率还受采样与计数器生命周期影响,正式失败数以请求文件为准。
截图来自本轮独立实验 Grafana 的历史数据,保留实际曲线;展示层只做布局与图例整理,未修改指标值。没有公开集群名、IP、内部域名或认证信息。
7. 功能检查与无人值守过程中学到的事¶
本轮两版的基础文本与完整流硬门槛、工具调用解析、单图蔬菜识别及交换顺序的双图样例均通过。视觉使用原始 2,048 Token 预算,新版没有触发额外 4,096 Token 诊断。首批新版曾在一条双图顺序问题中耗尽推理预算,本轮通过说明它能完成这些样例,不能把一次通过当作多模态准确率评测。
无人值守的关键是分清失败层级。预热失败不计入正式连续失败计数;一个输入长度与并发场景失败,不阻止其他健康场景继续运行;服务失联或 GPU 运行时故障才终止整组。正式失败保留分母、代码哈希和原始流,诊断单独编号。阶段期限和独立看护负责资源清理,最终仍要逐项审核实验成绩。
本轮没有执行 1M 上下文、CPU Engram、DSpark、长期稳定性或质量基准,也没有把本机的短时结果换算为线上每卡业务容量。测试材料和原始环境配置保留在私有目录;公开的逐轮脱敏结果包含全部 60 轮的分母、失败数、吞吐、延迟及源文件哈希。
8. 怎么决定是否升级¶
对 8K 以上输入、检索增强生成或 Agent 历史较长的服务,0.32.0 值得安排灰度。优先观察真实业务的首内容等待、排队、有效输出比例,以及代表性任务质量。长输入收益明显,但 bounded replay 的默认变化需要作为质量回归条件记录。
对 单用户、短输入、长时间连续生成的服务,不应预期升级后 Decode 速度翻倍。本轮 1K→512/C1 接近持平,目标如果是降低逐 Token 延迟,应单独测试对应模式。
对 高并发服务,先解决空输出定位与验收,再增加压力。升级时固定镜像 Digest、模型快照与依赖清单,保留旧镜像和回滚路径;容量结论应基于真实 Prompt、错误预算和延迟目标重新建立。
这次实测给出的判断是:0.32.0 在这套八卡 H20-3e 配置上确有明显的长输入收益,收益分布与请求形状有关;同时,完整流校验暴露的问题依然需要在上线前定位。