大规模 Kubernetes 调度器优化:从队列积压到并行调度架构
大集群里出现大量 Pending Pod,第一反应往往是给 kube-scheduler 增加 CPU、调高客户端请求额度,或者再部署几个副本。这些动作能解决部分问题,但也可能放大重试、API Server 写入和抢占压力。
调度优化要同时回答两个问题:Pod 能否及时找到位置,以及找到的位置是否值得。 前者关注排队、吞吐和尾延迟,后者关注资源碎片、故障域、租户公平性和作业整体成功率。只提高每秒绑定的 Pod 数,可能把训练任务更快地分散到无法组成完整作业的节点上。
本文结合上游机制、阿里与字节的公开材料,给出一套生产评估和调整方法。配置示例以 Kubernetes v1.30.4 为基线;涉及新版功能时单独说明版本。社区案例保留其原始环境边界,本文没有把它们改写成本地万节点压测成绩。
1. 先把“启动慢”拆成四段
从提交工作负载到容器 Ready,至少经过四段:
| 阶段 | 起点与终点 | 常见瓶颈 |
|---|---|---|
| 工作负载生成 Pod | 提交 Job/Deployment → Pod 创建 | 控制器积压、准入 Webhook、API 请求限流 |
| 调度排队与决策 | Pod 进入队列 → 找到节点 | 资源不足、队列重试、Filter/Score 插件开销 |
| 绑定与相关准备 | 选中节点 → 绑定完成 | Permit 等待、卷绑定、API 写入、外部扩展服务 |
| 节点执行 | Pod 已绑定 → Ready | 镜像拉取、挂盘、网络、设备分配、应用初始化 |
这里的 Filter 是节点可行性过滤,Score 是可行节点打分,Permit 是允许继续绑定或等待的扩展点。Pod 已经有 spec.nodeName,却仍处于 Pending,通常要转向 kubelet、存储或设备链路,继续调 scheduler 参数很难奏效。
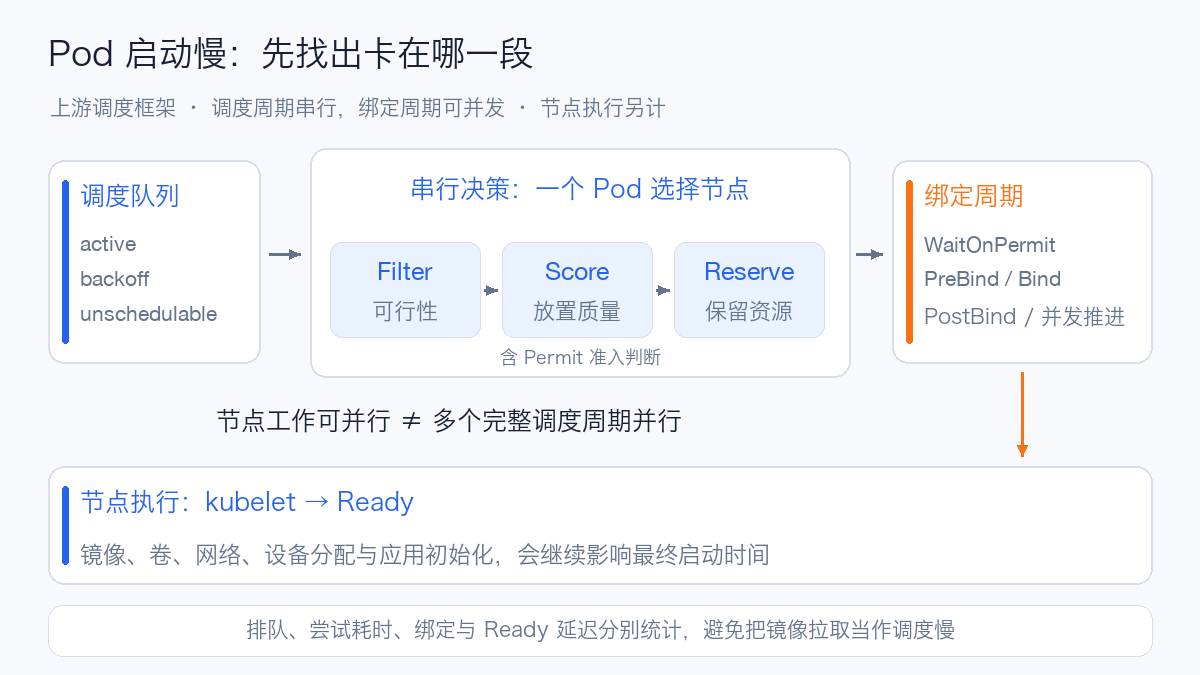
上游调度框架中,调度周期串行运行,绑定周期可以并发运行。节点级 Filter/Score 工作可以并行,但不等于多个 Pod 的完整调度周期同时执行。同一份领导者选举配置下,多副本提供的是高可用,只有领导者负责调度;一个进程中的多个 profile 也不是多个独立调度执行器。Kubernetes 调度框架、调度器多 Profile
一个便于评估的模型是:
例如,假设串行阶段平均耗时 20 ms,即使绑定可以并发,串行阶段的量级也只有约 50 次/秒。这是解释瓶颈的算术示例,不是 kube-scheduler 的固定性能上限。若一半尝试都因资源不足失败,再增加 CPU 也不会自动产生新的可用节点。
2. 建立能解释原因的调度看板
我会先把队列、尝试结果、扩展点耗时和后端 API 放在同一个时间轴上,再看 CPU。否则容易把“资源不足反复重试”误判为“调度器算得太慢”。
以下名称与标签已按 Kubernetes v1.30.4 调度器指标源码 核对;插件相关 Alpha 指标和后续版本的标签仍应以实际 /metrics 为准。
| 指标 | 观察什么 | 容易误读的地方 |
|---|---|---|
scheduler_pending_pods{queue=...} |
active、backoff、unschedulable、gated 队列 | gated 是尚未放行,不等于节点筛选失败 |
scheduler_schedule_attempts_total{result,profile} |
成功、不可调度、内部错误的速率 | 尝试次数不是唯一 Pod 数,失败重试也计数 |
scheduler_scheduling_attempt_duration_seconds |
单次尝试耗时,包含算法和绑定 | 不包含一个 Pod 的全部排队等待 |
scheduler_pod_scheduling_sli_duration_seconds |
Pod 进入调度队列后的调度延迟 | 只在完成调度后形成观测,长期卡住的 Pod 不能靠它反映 |
scheduler_framework_extension_point_duration_seconds |
Filter、Score、PreBind 等阶段耗时 | 各阶段分位数不能直接相加成为总 P99 |
scheduler_plugin_execution_duration_seconds |
具体插件耗时 | 1.30 的标签不含 profile;可能采样,先看实际观测频率 |
scheduler_queue_incoming_pods_total{queue,event} |
哪类事件导致大量重新入队 | 要与对象更新和失败插件一起判断 |
scheduler_preemption_attempts_total |
抢占尝试速率 | 尝试抢占不保证最终能运行 |
scheduler_unschedulable_pods{plugin,profile} |
各插件拒绝的 Pod | 一个 Pod 可以被多个插件计入,不可直接求和当总数 |
scheduler_pod_scheduling_duration_seconds 在这个版本已经标记弃用,新看板应优先用 SLI 指标。SLI 是 Service Level Indicator,即服务水平指标;如果业务目标是“提交后 30 秒内 Ready”,仍需从提交、Pod 创建和 Ready 时间构建端到端指标,不能直接拿 scheduler 的直方图替代。
典型查询如下。多集群应保留 cluster,并按自己的采集标签增加 job/实例过滤。
# 成功调度吞吐:Pod/s
sum by (cluster, profile) (
  rate(scheduler_schedule_attempts_total{result="scheduled"}[5m])
)

# 队列构成
sum by (cluster, queue) (scheduler_pending_pods)

# 单次成功尝试 P99:秒
histogram_quantile(0.99,
  sum by (cluster, profile, le) (
    rate(scheduler_scheduling_attempt_duration_seconds_bucket{
      result="scheduled"
    }[5m])
  )
)

# 分阶段 P99:秒
histogram_quantile(0.99,
  sum by (cluster, profile, extension_point, le) (
    rate(scheduler_framework_extension_point_duration_seconds_bucket[5m])
  )
)
不能把各实例的 P99 再平均。直方图需要先按同一口径汇总 bucket,再计算分位数。还要显示观测次数;五分钟只有两次调度时,P99 的解释能力很有限。
| 同时出现的现象 | 优先检查 |
|---|---|
| active 持续增长、Filter/Score 升高、CPU 忙 | 节点搜索范围、插件算法、锁竞争、CPU 配额 |
| unschedulable 多、CPU 不高 | requests、GPU 类型、亲和性、污点、卷、配额 |
| backoff 与重新入队速率暴涨 | 无效事件唤醒、失败重试、控制器批量更新 |
| PreBind/Bind 慢、API 429/延迟升高 | 卷控制器、API Priority and Fairness(API 优先级与公平性,APF)、准入、etcd |
| 领导者切换后队列突然增长 | 选举时间、缓存同步、LIST/WATCH 与绑定恢复 |
| Pod 很快绑定、训练迟迟没开始 | Gang 完整性、设备拓扑、镜像、网络、模型加载 |
3. 节点搜索:少找一些,但要找到足够好的位置
percentageOfNodesToScore 是最常讨论、也最容易解释错的参数。它控制的是找到多少个可行节点后可以停止搜索,不是“无论如何只检查全体节点的 10%”。
自动值随规模变化:官方文档给出的量级是 100 节点约 50%、5000 节点约 10%,自动比例下限 5%,同时存在最少可行节点数的限制。显式配置 0 表示使用自动策略。节点很少时,调低比例通常收益不大。Scheduler Performance Tuning
假设集群有 10000 个节点,但只有 30 个节点满足某种 GPU、网络和本地盘要求。即使阈值是 10%,也找不到 1000 个可行节点,搜索仍可能遍历大量节点。低比例无法直接解决候选节点稀疏的问题。
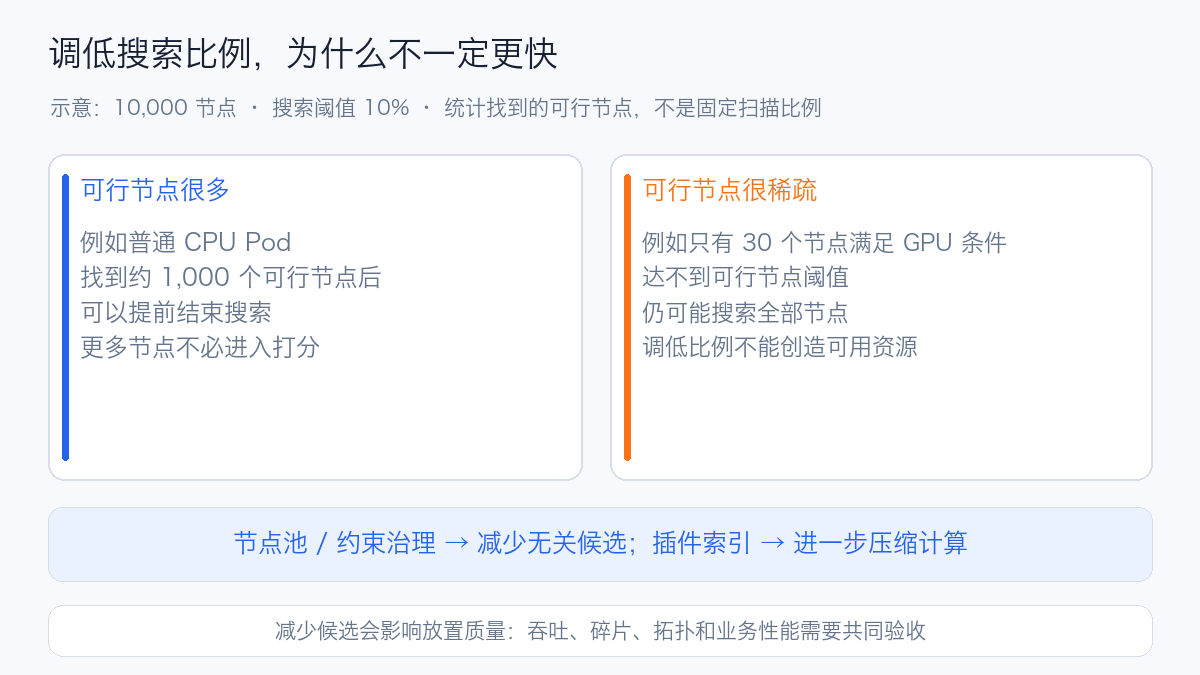
调整时可以比较自动值、10%、20% 和 50%,但同一轮必须同时记录:
- Filter/Score 时间、成功 Pod/s 和排队 P99;
- CPU、内存、GPU 的剩余碎片;
- 跨可用区、跨 NUMA 和网络拓扑分布;
- 调度后的应用延迟、训练通信效率和抢占量。
NUMA 是 Non-Uniform Memory Access,即非统一内存访问架构。GPU 作业即使满足“有四张空卡”,也可能被放到跨 NUMA 或互联较弱的组合中。放得快和跑得快需要分别验收。
节点池、稳定的型号标签和简洁的硬约束可以减少无关候选。实现了候选集合索引的插件还能提前收敛节点;但上游 nodeSelector 并不保证完全跳过全量节点迭代,不能把标签治理宣传成固定的十倍加速。
4. parallelism、CPU 与客户端 QPS:分别解决不同问题
以 v1.30.4 为例,上游默认 parallelism 为 16,scheduler 客户端默认 QPS 为 50、burst 为 100。v1.30.4 配置默认值
下面用于明确基线,本身没有做性能提升:
apiVersion: kubescheduler.config.k8s.io/v1
kind: KubeSchedulerConfiguration
parallelism: 16
percentageOfNodesToScore: 0
clientConnection:
  qps: 50
  burst: 100
profiles:
  - schedulerName: default-scheduler
生产中保留现有 leaderElection、插件、证书和 kubeconfig 等配置,只调整经过验证的字段。不要用这份最小示例覆盖已有配置。
| 调整项 | 可能有效的条件 | 增大后的代价 |
|---|---|---|
| CPU request / CPU 配额 | CPU 饱和或 CFS 配额限制导致节流 | 主机竞争、预算增加;算法低效仍存在 |
parallelism |
节点级计算有足够并行工作和 CPU | 内存分配、锁竞争、上下文切换增加 |
客户端 qps / burst |
证实 client-go 限流拖慢写入 | 更大 API 突发、APF 排队、etcd 压力 |
| 调度副本数 | 需要领导者故障恢复 | 更多进程与缓存开销,不直接增加有效吞吐 |
QPS 是 Queries/Requests Per Second,这里表示客户端每秒请求额度。先区分 client-go 自身限流、API Server 返回 429、网络延迟和 etcd 提交慢,再决定增加哪一侧容量。把 qps 从 50 调到 500,不能修复一个执行 300 ms 的 Filter 插件。
生产 Profile 要用 Go 的性能剖析工具 pprof 区分:计算热点、锁阻塞、垃圾回收、内存分配和等待远端服务。剖析端点限制在运维网络,短时间采样;不要把调试接口直接暴露给所有租户。
5. 插件优化:把重复计算移出逐节点路径
大集群中,一个插件单次增加几十微秒,乘上几千节点、多个插件和持续重试,就会变成明显成本。
我会按以下顺序审查扩展实现:
- 优先使用 informer/lister 缓存。 不在每个 Pod、每个节点的 Filter 调用中实时 GET/LIST API Server。
- 把共享计算放到 PreFilter / PreScore。 同一 Pod 的需求、标签选择器和拓扑计数一次计算,通过 CycleState 复用。
- 失败尽早返回。 已经确定节点不可能满足硬条件,不继续执行昂贵逻辑;涉及插件顺序时确认没有改变诊断和状态语义。
- 减少临时对象和大锁。 CPU Profile 之外同时检查 heap、mutex、block Profile,避免所有节点 worker 争用一个互斥锁。
- 给外部 Extender 明确延迟和故障语义。 HTTP 调用设置超时,判断失败是放行还是拒绝;不能悄悄降级 GPU 拓扑和安全约束。
调度框架插件是编译到 scheduler 进程中的扩展;Extender 则是外部接口。两者的缓存、网络成本和升级方式不同。Scheduling Framework 设计、Scheduler Extender 配置
Pod 间亲和性、反亲和性在大集群中尤其要谨慎。跨大量命名空间的复杂选择器、高 Pod 密度和频繁变动会增加计算负担。优先把需求说明白:必须同节点、只需同可用区,还是希望尽量分散?可以表达为简单拓扑分布的需求,不必全部写成复杂的 Pod 间关系;转换前必须验证语义一致。Pod 间亲和性与规模限制
5.1 GPU 碎片治理:给打分一个可检验的目标
训练资源池可以评估 NodeResourcesFit 的装箱打分。例如,把 GPU 纳入 MostAllocated,倾向于在满足 requests 的节点中使用已经分配较多资源的节点,尽量保留完整空闲节点。Kubernetes Resource Bin Packing
下面是 profile 内的一段候选配置,权重用于展示写法,不是推荐所有环境使用 4:
pluginConfig:
  - name: NodeResourcesFit
    args:
      scoringStrategy:
        type: MostAllocated
        resources:
          - name: cpu
            weight: 1
          - name: memory
            weight: 1
          - name: nvidia.com/gpu
            weight: 4
节点资源打分基于请求与可分配资源,不等于 GPU 实际利用率;其他 Score 插件的权重仍会影响最终结果。这个配置也不了解卡间 NVLink、PCIe 与 NUMA 组合,不能代替设备拓扑插件或节点侧分配校验。
灰度时比较一组真实作业:同样的四卡、八卡请求,优化前后有多少完整八卡节点仍可用、多少作业因碎片等待、通信性能是否下降,以及故障域是否过度集中。CPU 微服务常需要分散部署,不能把训练池的装箱策略不加区分地应用到全部在线服务。
6. 重试治理:不要让无解的 Pod 消耗全部调度能力
假设某个租户提交 10000 个需要特定 GPU 的 Pod,资源只能容纳 1000 个。如果剩余 Pod 被频繁节点更新唤醒,调度器就会持续重复证明同一件事:资源不够。
应先在作业准入和队列层限制进入调度器的需求。Kubernetes 的 schedulingGates 可以把尚不具备条件的 Pod 留在 gated 状态;配合 Kueue 等作业准入组件,先判断配额和资源,再移除 gate。Gate 本身不会分配资源,也不会自动完成 Gang 调度。Pod Scheduling Readiness、Kueue 工作机制
重试侧还可以利用 QueueingHint:根据上次失败的插件,判断某个事件是否可能让 Pod 变得可调度。它在 v1.32 默认启用,在 v1.34 成为稳定功能。早期实现曾因内存问题关闭过默认开关,因此旧集群不能直接照抄新版 feature gate。v1.32 QueueingHint 说明、v1.34 QueueingHint 状态
实践中的目标是减少无效尝试,而不是一味延长 backoff。Backoff 是失败后的退避;过长会让资源释放后本应立即运行的 Pod 继续等待,过短又会形成重试风暴。调整要同时观察重新入队事件和资源释放后的恢复延迟。
抢占也要算进这本账。高优先级 Pod 不一定能通过抢占满足硬亲和性、拓扑或卷条件;大量重复抢占会制造驱逐、重建和 Event。PDB 是 Pod Disruption Budget,即 Pod 中断预算,上游抢占对它的保护是尽力而为,不能承诺绝不违反。优先约束高优先级的使用范围,给长训练作业配合可恢复 checkpoint。Pod Priority and Preemption
7. 阿里的实践:吞吐之外还要解决配额与作业完整性
阿里 2019 年万节点控制面分享把 10000 Node、200000 Pod 和百万对象作为测试画像,发现存储、控制器恢复和调度同时受到压力。它的价值在于把 scheduler 放回整个控制循环:后端 API 慢、缓存冷启动和对象风暴会一起拖慢调度。文章年代较早,其中改进不能直接当作当前版本仍缺失的功能。阿里巴巴万级规模控制面优化
阿里工程师在 Kubernetes 调度扩展分享中进一步讨论 Capacity Scheduling 和批作业调度。对应的生产问题是:一个租户是否长期占住闲置额度,以及多进程作业能否一起拿到资源。阿里:扩展 Kubernetes 调度器支持 AI 和大数据作业
Koordinator 的 ElasticQuota(弹性配额)支持层级额度及借用/归还,Coscheduling 支持 Gang,也就是一组 Pod 满足最低就绪条件后一起推进。这些能力可以改善共享资源池的使用方式,但增加了 quota、PodGroup、Reservation 等对象和状态管理,仍需测量插件耗时与失败恢复。Koordinator v1.6 弹性配额、Koordinator 组件与调度插件
对于一个八进程训练作业,我更关心“八个进程全部可运行用了多久”,而不是第一个 Pod 多快绑定。否则容易出现四个作业各拿到两张卡,GPU 都被占用,却没有一个作业能开始。
这类问题适合在作业层解决:先准入,再 Gang/预留,最后进行节点与设备放置。给默认 scheduler 增加 CPU 不能替代这层资源管理。
8. 字节的实践:从单领导者优化走向并行架构
字节 2024 年公开 Gödel Scheduler 时报告:其内部定制环境下,单分片超过 2000 Pod/s,多分片超过 5000 Pod/s,最大生产集群超过 20000 节点、100 万 Pod。这些数字来自字节的公开案例,不是本文复测,也不能与一个简单空 Pod 测试直接比较。字节发布 Gödel Scheduler
Gödel 把并行节点匹配、乐观并发和 Unit/Pod 两层批调度语义引入架构。要点是把多个调度决策的并发能力和冲突处理一起设计,而不是多开几个互不协调的 kube-scheduler。并行化之后,资源预占冲突、回滚和重新调度也必须成为验收项目。Gödel 项目架构
还有一个现实边界:检索时,该仓库 Quick Start 明确列出的 Kubernetes 兼容范围是 1.21.4–1.24.6。这不证明新版本必然不能适配,但对 1.30 集群不能承诺拿来即用;需要确认分支、API、插件和维护策略。
对这类架构,我会设置三个采用条件:
- 已经用真实画像证明单领导者的串行决策路径是主要瓶颈;
- 参数、插件和重试治理之后仍无法满足需求;
- 团队能维护兼容性、冲突恢复、故障测试和上游升级。
如果主要问题只是训练配额和 Gang 完整性,先引入相应作业管理能力通常更直接,不必立刻替换整个调度体系。
9. 如何压测,才能说明优化有效
上游有 scheduler_perf 集成性能测试,适合比较版本、插件和配置开销;Kubemark 能模拟更大规模控制面。两者都不能自动代替 GPU、卷和真实训练启动验收。scheduler_perf、Kubemark
我会准备以下几类画像,并保持同一组 Pod、节点快照、顺序分布和资源占用:
| 场景 | 目的 | 除吞吐外的验收 |
|---|---|---|
| 大量小 CPU Pod | 测量基础串行路径 | 排队 P99、API bind 速率 |
| Pod 密集且含亲和性 | 放大关系计算 | Filter 插件、锁、内存 |
| GPU / RDMA / 拓扑约束 | 测量稀疏候选和放置质量 | 可用整机数量、跨拓扑通信 |
| 部分请求确定不可调度 | 验证重试治理 | 无效尝试比例、在线 Pod 是否饥饿 |
| PVC 与延迟绑定 | 验证存储链路 | PreBind、卷就绪与超时 |
| 大批 Job 同时提交 | 验证准入和 Gang | 整个作业启动时间、半占用资源 |
| scheduler 切主、节点批量变化 | 验证故障恢复 | 缓存同步、重试、重复/冲突绑定 |
RDMA 是 Remote Direct Memory Access,即远程直接内存访问;PVC 是 PersistentVolumeClaim,即持久卷声明。这里列的是评估场景,不是本文已经执行的压测结果。
每次只改一类变量。例如先固定插件与资源,比较搜索比例;再固定比例,比较 parallelism;最后才测客户端 QPS。发布量应同时覆盖稳态和突发,记录所有创建 Pod 的分母,不把超时和失败样本从报表中删掉。
看板中至少放两类延迟:成功样本的直方图和仍在等待的 Pod 年龄。后者可以通过 Pod 创建时间、PodScheduled condition 与 Watch 记录计算,不要虚构一个在当前版本并不存在的“队列最老年龄”指标。
10. 灰度、回滚与故障恢复
建议采用“离线重放 → 隔离节点池 → 小比例工作负载 → 扩大覆盖”的顺序。第二个 scheduler 使用独立 schedulerName,让试验 Pod 明确选择它;节点池用双方都遵守的选择约束与污点隔离,不能只给新 scheduler 增加一条单向亲和性。
两个独立调度器同时向相同节点放 Pod,各自的 assumed cache 不共享。API Server 不负责原子检查所有资源是否够用,因此不能把“绑定 API 成功”当成没有资源竞争。若要共享池,应评估协调/预留机制和失败恢复,而不是简单启动双活。
上线前把以下证据放在同一份变更记录中:
| 项目 | 要保留的内容 |
|---|---|
| 基线 | 版本、镜像 digest、完整配置、插件与节点画像 |
| 调整 | 单项变化、理由、Profile 与 Pod 范围 |
| 性能 | 有效 Pod/s、排队与尝试延迟、失败分母 |
| 放置质量 | 碎片、作业完整性、跨拓扑比例、业务延迟 |
| 后端影响 | API 429、绑定延迟、etcd、Event、Informer 重连 |
| 恢复 | 主实例故障、Permit 超时、绑定失败、预留回收 |
| 回滚 | 恢复配置的方法,以及已创建 Pod 如何转交 |
schedulerName 不是可以随时修改的迁移开关。灰度回滚要有控制器层的重建或接管方案,不能只把新 scheduler 缩到零,让已经归它负责的 Pod 永久 Pending。
我选择优化路线时,通常遵循这个顺序:先消除无解需求和无效重试,再压缩候选与插件成本,随后校正 CPU 和 API 额度,最后评估并行调度架构。每一步都要求有效吞吐提升,同时没有把资源碎片、在线业务干扰或恢复时间推到更差的位置。