多机多卡训练框架与故障恢复:从 DDP、FSDP 到 DeepSpeed、Megatron 和 Ray
多机多卡训练把一次训练拆成许多相互依赖的进程。每个进程通常对应一个 Rank,Rank 之间通过 NCCL、Gloo、MPI 或 XLA Collective 同步梯度、参数或激活值。它带来了更大的模型容量和更高的吞吐,也把单机故障放大成整个训练组的故障。
先给出本文最重要的结论:同步训练中的一台机器掉线后,默认恢复单位通常是整个 Worker Group,而不是单独替换故障 Rank。 原 Collective 通信组已经失效,健康 Rank 即使还活着,也可能停在 All-Reduce、All-Gather 或 Send/Recv 上。生产恢复一般要终止旧进程组、排除故障节点、重新获得完整资源、建立新 World,再从最近一次完整 Checkpoint 继续。
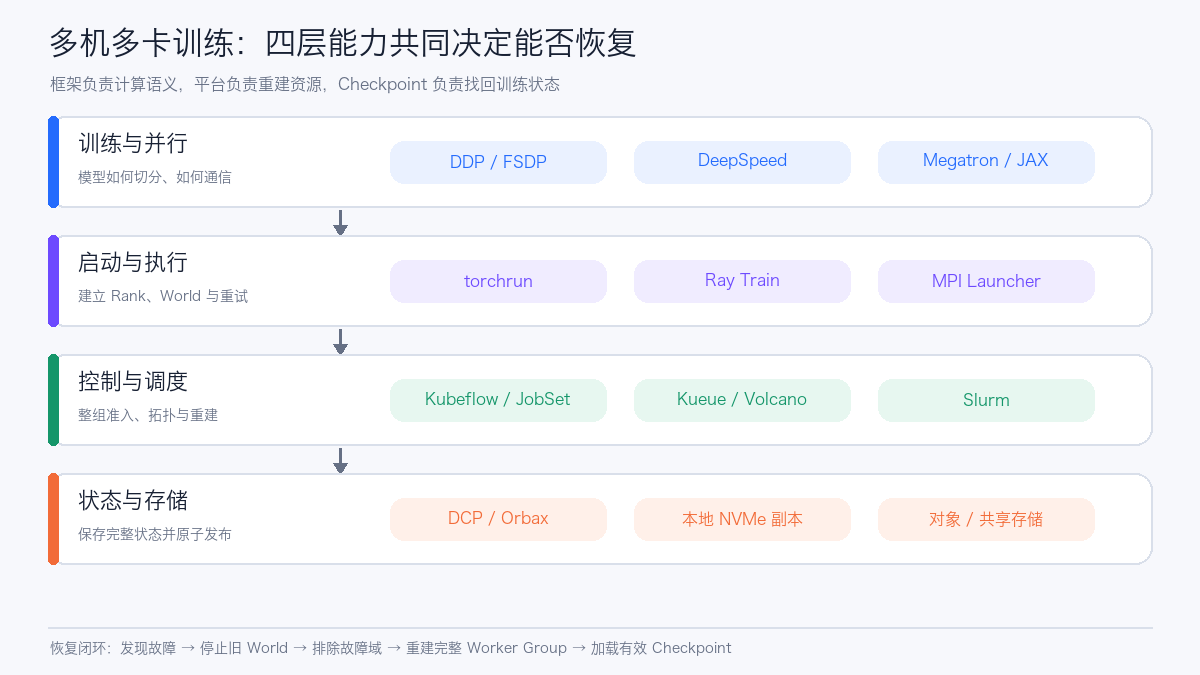
所谓训练容错,至少要同时具备四层能力:
- 训练框架能保存并恢复完整状态;
- Launcher 能发现 Rank 失败并重启进程组;
- 调度与控制器能重新获得一整组合适的 GPU;
- Checkpoint 位于故障节点之外,并且能证明完整可读。
1. 先分清“框架”和“平台”
业界常把 DeepSpeed、Ray、Kubeflow Trainer 和 Kueue 都称为训练框架,实际职责完全不同。
| 层次 | 代表项目 | 主要职责 | 不负责什么 |
|---|---|---|---|
| 算法与并行运行时 | PyTorch DDP/FSDP、DeepSpeed、Megatron Core、JAX/XLA、Colossal-AI、Horovod | 前反向计算、参数分片、Collective、混合精度、并行策略 | 集群配额、故障节点维修 |
| 易用封装 | Hugging Face Accelerate、Transformers Trainer、Lightning Fabric | 用统一接口接入 DDP、FSDP、DeepSpeed 等后端 | 替代底层通信和 Checkpoint 语义 |
| 分布式执行与启动 | torchrun、Ray Train、MPI Launcher |
建立 Worker Group、Rank/World Size、Rendezvous、进程重启 | 自动保证训练状态完整 |
| Kubernetes 训练控制器 | Kubeflow Trainer、JobSet、KubeRay、Volcano Job | 创建 Leader/Worker、观察状态、执行失败策略 | 决定模型如何切分 |
| 队列与调度 | Kueue、Volcano、Slurm、KAI Scheduler | 配额、优先级、Gang、拓扑与抢占 | 保存优化器和数据游标 |
| 状态与制品 | PyTorch DCP、Megatron Distributed Checkpoint、DeepSpeed Checkpoint、Orbax、对象存储 | 保存模型、优化器和训练进度 | 自动判断节点是否健康 |
选择框架时必须把这些层组合起来。只配置 Kubernetes restartPolicy: OnFailure,最多能重启一个容器;它不知道其他 Rank 已经失去同步,也不知道新进程该从哪个训练 Step 恢复。
2. 主流多机多卡训练框架
2.1 PyTorch DDP 与 torchrun:默认基线
DistributedDataParallel(DDP)在每个 Rank 保存一份完整模型,通过 Collective 同步梯度。它概念清晰、生态成熟,适合模型能够放进单卡显存,或经过 LoRA、Activation Checkpoint 等手段后仍能放入单卡的训练。
torchrun 负责启动和监控进程。Elastic 模式可以在进程失败或成员变化后重新建立 Worker Group,并重新执行训练入口;训练脚本仍必须在入口处加载 Checkpoint。PyTorch 官方的故障容错教程也明确说明,失败后会重启全部进程,并从最近的 Snapshot 继续。
适合: 通用 CV/NLP、多机数据并行、希望保持原生 PyTorch 的团队。
恢复重点: 保存模型、Optimizer、Scheduler、GradScaler、Step、Sampler 和随机状态;让所有 Rank 在相同逻辑 Step 重新开始。
参考:Fault-tolerant Distributed Training with torchrun
2.2 PyTorch FSDP + DCP:原生参数分片
Fully Sharded Data Parallel(FSDP)进一步把参数、梯度和优化器状态分片到多个 Rank,降低单卡显存占用。它适合模型无法由每张卡各保存一份完整副本的场景,也是原生 PyTorch 大模型训练的重要路线。
故障恢复不应让 Rank 0 汇总出一个巨大的完整 State Dict 再保存。PyTorch Distributed Checkpoint(DCP)支持多个 Rank 并行保存 Shard,并能在加载时重分片。这样可以降低单点内存与 I/O 压力,也给 World Size 调整留下空间。
适合: 希望留在 PyTorch 原生栈、需要全分片训练、愿意自己管理训练循环和并行策略的团队。
恢复重点: 使用 Sharded State Dict/DCP;恢复前先按新拓扑初始化模型,再让 DCP 把全局状态映射到新的 Shard。
参考:PyTorch Distributed Checkpoint、FSDP
2.3 DeepSpeed:ZeRO 与 3D 并行
DeepSpeed 最广泛的能力是 ZeRO,它按不同 Stage 分片优化器状态、梯度和参数,并可组合 Tensor Parallel、Pipeline Parallel、CPU/NVMe Offload。它适合希望较少改动 Hugging Face/PyTorch 代码,同时获得大模型显存优化的团队。
普通 ZeRO Checkpoint 与保存时的分片布局有关。DeepSpeed Universal Checkpoint 用统一格式解决不同 DP、TP、PP 配置之间的恢复问题,但官方文档仍把相关能力标记为持续发展中的功能;采用前要针对目标模型、优化器和并行组合实际验证。ZeRO-3 旧的 elastic checkpoint 选项已经不再支持,官方建议转向 Universal Checkpoint。
适合: Hugging Face 生态、ZeRO、Offload,以及中大型模型训练。
恢复重点: 所有 Rank 共同参与 save_checkpoint;不能只保存 Rank 0;跨并行度恢复前验证 Universal 转换和优化器状态兼容性。
参考:DeepSpeed Model Checkpointing、Universal Checkpointing
2.4 Megatron Core / NeMo:大规模 Transformer 并行
Megatron Core 面向大规模 Transformer,系统实现 Tensor、Pipeline、Context、Expert 与 Data Parallel,常与 NeMo、Transformer Engine 和 NVIDIA Resiliency Extension 组合。它更接近大模型预训练底座,而不是一个简单的 Trainer 包装器。
Megatron Distributed Checkpoint 能让多个 Rank 并行保存分片,并支持在不同并行配置之间加载。优化器 Checkpoint 还区分偏性能的 dp_reshardable 和可跨更多模型并行维度恢复的 fully_reshardable,两者不能只凭名字互换。异步保存、局部 Checkpoint、跨节点副本、Hang/Straggler 检测能进一步降低恢复成本,但部分自动容错能力与 Slurm 或特定 NVIDIA 组件绑定,部署到 Kubernetes 前要逐项确认边界。
适合: 数十到数千 GPU 的 Transformer/MoE 预训练,已有明确并行拓扑与性能工程能力的团队。
恢复重点: 保存并行拓扑和优化器格式;区分快速本地 Checkpoint 与持久 Checkpoint;升级 Megatron Core 时验证旧优化器状态的兼容性。
参考:Megatron Core Distributed Checkpoint、Megatron Bridge Resiliency
2.5 JAX/XLA + Orbax:多 Host 的数组分片路线
JAX 使用 XLA 和全局数组 Sharding 描述设备布局,适合 GPU、TPU 和大规模 SPMD 训练。多 Host 环境要求每个进程加载正确的数据 Shard;数据放错设备有时不会直接报错,却可能让训练结果错误。
Orbax 是 JAX 生态的 Checkpoint 组件,支持多进程、异步保存、原子性选项、保留策略和拓扑无关加载。所有 Host 都需要按协议参与保存和恢复,不能把它当成只有主进程写文件的普通序列化工具。
适合: JAX/Flax、TPU、以 XLA/SPMD 为核心的团队。
恢复重点: 保存完整 PyTree 与 Sharding 元数据;验证多 Host barrier、临时目录清理、预占通知和新拓扑恢复。
参考:JAX Distributed Data Loading、Orbax CheckpointManager
2.6 Hugging Face Accelerate:统一入口,不是新通信框架
Accelerate 可以用相对统一的配置切换 DDP、FSDP、DeepSpeed 等后端,并提供 save_state/load_state 保存模型、优化器、Scaler、随机状态和已注册对象。它降低了使用门槛,但最终的分片、Collective 和拓扑兼容性仍取决于底层后端。
官方文档提醒,save_state 更适合同一训练环境的续跑。需要跨 World Size、跨后端或跨模型代码版本恢复时,不能只看到目录中存在文件就认定可用。
适合: Hugging Face Trainer、自研 PyTorch 脚本、需要在多种后端间保持相似代码的团队。
参考:Accelerate Accelerator API、Accelerate FSDP Checkpoint
2.7 Colossal-AI:Booster 与异构并行
Colossal-AI 提供 Booster、混合并行、Gemini/ZeRO 类内存管理和分片 Checkpoint。Booster 可以分别保存模型、优化器和 LR Scheduler,也支持 Shard 与异步保存。它适合愿意采用其训练抽象并针对目标模型验证兼容性的团队。
它的社区规模、模型 Recipe、版本兼容矩阵与大型生产案例少于 PyTorch 原生、DeepSpeed 和 Megatron 路线。选型时应把“样例能跑”与“目标规模故障恢复通过”分开验收。
参考:Colossal-AI Booster Checkpoint
2.8 Horovod Elastic:成熟 All-Reduce 与成员变化
Horovod 曾是 TensorFlow/PyTorch 通用 All-Reduce 的主流方案。Elastic Horovod 可以在 Worker 增减时同步状态,并通过 state.commit() 保存内存中的一致点。它适合已有 Horovod 代码、Spot/弹性 Worker,以及不需要复杂模型并行的训练。
内存 Commit 解决的是当前存活 Worker 之间的快速回滚,不能代替远端持久 Checkpoint;整个作业或存储节点消失时,仍需要从外部存储恢复。Worker 数变化还会改变全局 Batch、数据分区和学习率语义。
2.9 Ray Train:训练编排层,不是训练 Kernel
Ray Train 可以启动 PyTorch、TensorFlow 等 Worker Group,协调资源、Checkpoint 与重试。Worker 或节点失败后,Ray Train 通常停止整个 Worker Group,等待资源,再把最新 Checkpoint 提供给新 Worker。默认是否重试以及 API 语义会随 Ray Train 版本变化;当前 Train V2 通过 FailureConfig 配置失败与抢占重试。
Ray 的价值在于把数据处理、训练、Tune、批推理和后训练 Actor 放进统一 Python 分布式运行时。固定拓扑的大规模预训练如果已经由 torchrun、Megatron Launcher、Kubeflow Trainer 或 Slurm 稳定承载,不必只为“弹性”额外引入 Ray。
参考:Ray Train Failure Handling、Ray Train Checkpoints
3. 怎么选
| 场景 | 优先评估 | 原因 | 需要额外验证 |
|---|---|---|---|
| 模型可放进单卡,以吞吐扩展为主 | DDP + torchrun | 简单、稳定、生态完整 | Snapshot 与数据游标 |
| 模型需要参数全分片 | FSDP + DCP | PyTorch 原生、可并行保存和重分片 | 目标模型算子、DCP 后端与恢复耗时 |
| Hugging Face + 大模型显存优化 | Accelerate + DeepSpeed/FSDP | 代码改动小、Recipe 多 | 底层 Checkpoint 才是真实边界 |
| 大规模 Transformer/MoE 预训练 | Megatron Core/NeMo | 并行维度和 Kernel 优化完整 | 版本矩阵、拓扑、优化器状态兼容 |
| JAX/TPU/SPMD | JAX/XLA + Orbax | 全局数组 Sharding 与多 Host 能力 | 数据 Shard、Barrier 和存储原子性 |
| 动态 Python 工作流、Tune、后训练 | Ray Train + PyTorch/DeepSpeed | 执行和资源编排灵活 | Head/Driver、Worker、Checkpoint 分层容错 |
| 既有通用 All-Reduce 项目 | Horovod Elastic | 跨框架、成员变化语义成熟 | 全局 Batch、数据重分区、持久恢复 |
| 希望尝试另一套混合并行抽象 | Colossal-AI | Booster 和内存优化能力丰富 | 目标规模社区成熟度与灾难恢复 |
没有一种框架能替代真实故障演练。最重要的选型证据不是官方支持列表,而是目标模型、目标并行度、目标存储和目标调度器下的恢复结果。
4. 机器故障究竟破坏了什么
| 故障 | 常见现象 | 自动动作 | 是否应换节点 |
|---|---|---|---|
| 单个训练进程退出 | 某 Rank 抛异常,其他 Rank Collective 超时 | 终止并重建 Worker Group | 视错误原因 |
| GPU XID / ECC | CUDA/NCCL 异常,GPU 可能不可继续使用 | 隔离 GPU 或节点,限制自动重试 | 通常是 |
| 节点宕机或 NotReady | 多个 Rank 同时消失 | 释放旧 Gang,重新排队 | 是 |
| RDMA/NIC/交换网络异常 | NCCL Hang、吞吐骤降、重试 | 超时中止,收集通信诊断 | 有条件 |
| Spot/抢占 | 收到终止信号或 Pod Evicted | 尝试保存,随后完整恢复 | 是 |
| 本地盘故障 | 最新本地 Checkpoint 丢失 | 回退远端持久版本 | 是 |
| 共享存储超时 | 保存卡住或只写出部分 Shard | 本次 Checkpoint 作废 | 不一定 |
| OOM、数据损坏、代码异常 | 每次在相同步骤失败 | 快速失败并保留证据 | 否,先修配置/数据 |
| Loss NaN/Inf | 进程可能仍在运行 | 停止自动重试,回滚并分析 | 视硬件证据 |
基础设施故障适合有限重试;确定性的用户代码错误不应消耗更多 GPU 重复执行。NCCL 超时既可能来自机器故障,也可能来自某个 Rank 先 OOM 或读取数据卡死,所以要优先定位第一个失败 Rank,而不是只看最后一条通信超时。
5. Checkpoint 必须保存哪些状态
“保存了模型权重”只够推理或重新微调,不等于能精确续训。完整训练 Checkpoint 至少包含:
- 模型参数与 Buffer;
- Optimizer 状态,例如 Adam 的一阶、二阶矩;
- LR Scheduler、GradScaler 和梯度累积位置;
- 全局 Step、已处理 Token、Epoch;
- Python、NumPy、CPU/GPU RNG 状态;
- DataLoader/Sampler 状态、数据 Shard 与消费 Watermark;
- DP、TP、PP、CP、EP 等并行拓扑元数据;
- 数据集 Snapshot、Tokenizer、训练配置、代码 Commit 和镜像 Digest;
- Checkpoint 格式版本、Shard 清单、大小与校验和。
少了 Optimizer,恢复后的 Loss 轨迹可能改变;少了数据游标,会重复或跳过样本;少了 RNG,Dropout 和采样不能复现;少了拓扑元数据,分片文件即使都在也未必能装入新 World。
6. 一个可恢复的保存协议
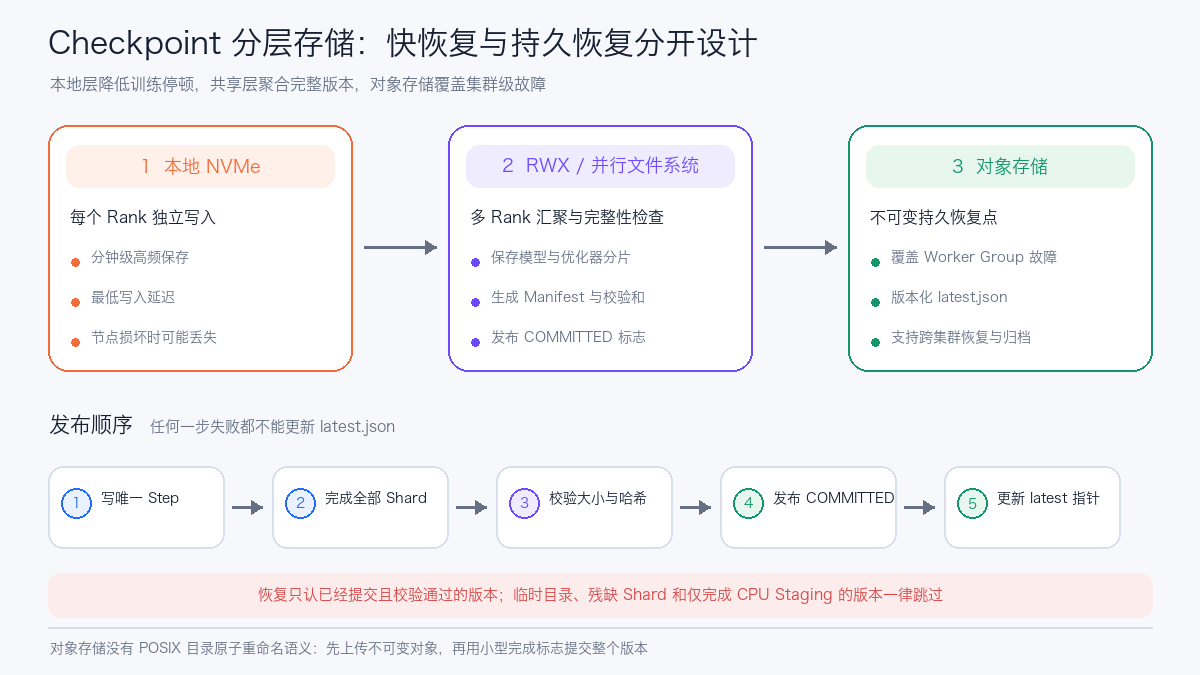
大模型 Checkpoint 往往由多个 Rank 并行写出。只要一个 Shard 缺失,整份 Checkpoint 就可能无效。建议采用如下发布协议:
- 为本次 Step 创建唯一临时目录,例如
step-12000.tmp-<run-id>; - 各 Rank 写自己的模型、优化器和额外状态;
- 等待全部 Rank 完成并汇总文件大小、校验和与格式版本;
- 写入 Manifest,执行一次可加载性检查;
- 原子发布完成标志或把目录重命名为正式版本;
- 最后更新
latest指针; - 清理旧版本时至少保留最近版本、上一个已验证版本和周期性里程碑。
恢复程序只能选择已经发布并验证的版本,不能按目录名最大值直接猜“最新”。异步保存还要区分“训练线程已经返回”和“远端数据已经持久化”,两者之间发生故障时,本次 Checkpoint 仍可能不可用。
7. 分层 Checkpoint 架构
单一存储很难同时满足快和可靠。生产训练常使用两级或三级结构:
- 节点本地 NVMe:高频、低延迟,但节点丢失就可能消失;
- 跨节点复制的局部 Checkpoint:在相邻节点保存副本,覆盖单节点故障;
- 对象存储或可靠共享存储:低频持久版本,覆盖整个 Worker Group 或机房级故障。
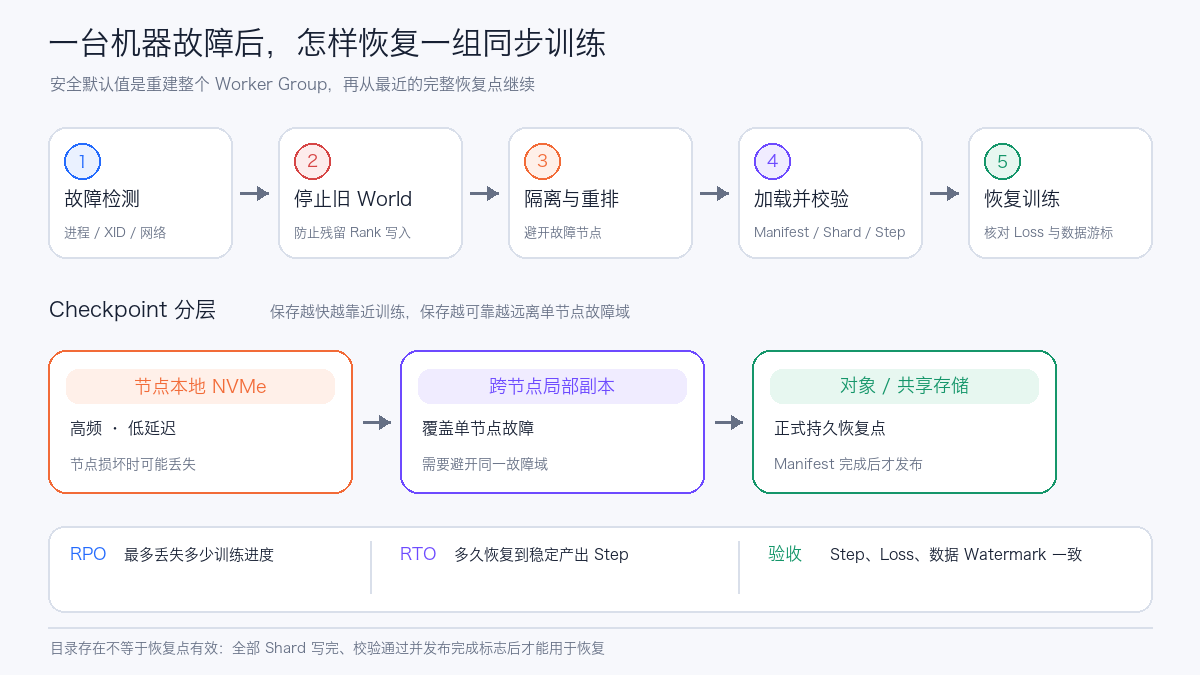
本地保存不能只复制到同一故障域。例如同一机箱、同一电源域或同一机架同时失效时,本地副本也可能一起消失。对象存储路径还要隔离不同 Run,禁止两个训练任务同时把 latest 写向同一目录。
8. Checkpoint 到底存在哪里
存储选择决定了保存耗时,也决定了能覆盖哪一级故障。先根据恢复目标选择介质,再优化速度。
| 存储 | 多节点访问 | 性能特点 | 能覆盖的故障 | 适合用途 |
|---|---|---|---|---|
Pod emptyDir / 节点 NVMe |
默认只在本节点 | 延迟最低、带宽最高 | 进程或容器重启;节点损坏时会丢失 | 高频临时版本、异步保存的 Staging |
| HostPath / Local PV | 绑定节点 | 接近本地盘 | Pod 重建;不能覆盖节点故障 | 受控环境中的本地快速恢复 |
| 块存储 PVC(RWO/RWOP) | 通常单节点挂载 | 延迟稳定,吞吐取决于卷规格 | 节点替换后可重新挂载 | 单节点训练、每个 Worker 独立卷 |
| RWX 文件系统 | 多节点同时挂载 | 使用方便,易受元数据和小文件影响 | Worker 或节点故障 | 多 Rank 分片直接保存、短期共享 Staging |
| 并行文件系统 | 多节点并发 | 高带宽,需做好条带和元数据规划 | 节点与 Worker Group 故障 | 大规模同步/异步分片 Checkpoint |
| 对象存储 | 通过 API 访问 | 吞吐扩展好,不提供 POSIX 目录语义 | 整个训练组、节点池甚至集群故障 | 持久恢复点、归档和跨集群恢复 |
Kubernetes 的 AccessMode 不能被想当然地理解:ReadWriteOnce 表示单节点读写,同一节点上的多个 Pod 仍可能同时访问;需要严格限制为单 Pod 时应评估 CSI 支持的 ReadWriteOncePod。多机训练若让所有 Rank 写同一路径,通常需要 RWX、并行文件系统,或者直接使用支持分布式写入的对象存储后端。参考:Kubernetes Persistent Volumes
三种常见落地方式
小中型 DDP: Rank 0 把模型、优化器等公共状态写入 RWX/PVC,每个 Rank 另存自己的 RNG 和数据消费状态;保存成功后发布完成标志。实现简单,适合作为第一条可靠路径。
FSDP/ZeRO/Megatron: 所有 Rank 并行写分片到 RWX 或并行文件系统,协调 Rank 在全部分片完成后发布 Manifest。再由独立上传进程把完整目录复制到对象存储。这样训练进程不必直接承担远端小文件和重试逻辑。
超大规模训练: 每个 Rank 高频写本地盘,按故障域把副本复制到另一台节点;每隔较长时间生成一次对象存储持久版本。恢复时先尝试同一 Worker Group 的本地副本,再尝试跨节点副本,最后回退远端版本。
9. 目录、Manifest 与原子发布
Checkpoint 路径应由 Run 和 Attempt 隔离,Step 目录一旦发布就不再覆盖:
checkpoints/
└── team-a/model-x/run-20260917-001/
    ├── run.json
    ├── steps/
    │   ├── step-000012000/
    │   │   ├── model/
    │   │   │   ├── __0_0.distcp
    │   │   │   └── __1_0.distcp
    │   │   ├── rank-state/rank-00000.pt
    │   │   ├── manifest.json
    │   │   └── COMMITTED
    │   └── step-000012500.tmp-attempt-03/
    ├── latest.json
    └── attempts/attempt-03.json
manifest.json 至少应记录以下内容:
{
  "schema_version": 1,
  "run_id": "run-20260917-001",
  "step": 12000,
  "world_size": 32,
  "parallelism": {"dp": 4, "tp": 4, "pp": 2, "ep": 1},
  "framework": {"name": "pytorch", "version": "<exact-version>"},
  "image_digest": "sha256:<digest>",
  "code_commit": "<git-commit>",
  "dataset_snapshot": "<immutable-dataset-version>",
  "files": [
    {"path": "model/__0_0.distcp", "bytes": 123456, "sha256": "<checksum>"}
  ],
  "created_at": "2026-09-17T12:00:00Z"
}
在 POSIX 文件系统上,可以把全部内容写到同一文件系统中的临时目录,关闭文件并完成 Barrier 后,用原子 rename 发布正式目录。在对象存储中不要模拟目录重命名:对象 Key 本质上是独立对象,复制再删除既慢也不是事务。更稳妥的顺序是:
- 上传带唯一 Run/Step 的不可变分片;
- 对每个对象核对大小和独立的 SHA-256 等校验值;
- 上传
manifest.json; - 最后写入很小的
COMMITTED对象; - 使用带版本或条件写的
latest.json指向该 Step; - 恢复端只接受存在
COMMITTED且 Manifest 校验通过的目录。
latest.json 只是加速查找的指针,不是事实来源。它损坏或指向无效版本时,恢复器应按 Step 倒序扫描,并回退到上一个通过校验的版本。
对象存储的 ETag 在分段上传、加密和不同实现中不一定等于内容 MD5,不应被当成通用内容校验和。建议启用 Bucket Versioning 或等价能力保护 latest.json 和 Manifest,并给训练身份最小权限:训练任务只能写自己的 Run 前缀,恢复任务只读指定前缀,GC 使用单独身份。静态加密、传输加密、访问审计和跨故障域副本也应纳入存储基线。
容量怎么估算
以 Adam 类优化器和 BF16 参数为例,粗略计算一份完整训练状态:
BF16 模型参数       2 byte / parameter
FP32 Master Weight  4 byte / parameter
Adam 一阶、二阶矩   8 byte / parameter
合计约             14 byte / parameter
如果还保存 BF16 梯度,接近 16 byte/parameter;分片索引、对齐、额外 Buffer 和版本差异还会增加空间。一个 70B 模型按 14 byte/parameter 估算约为 980 GB,一次保留 3 个完整版本就接近 3 TB。生产容量建议按实测单版本大小乘以保留数量,再增加 20%—30% 的临时写入、重试和碎片余量。
不是每个 Checkpoint 都要永久保留。常见策略是保留最近 3—5 个已验证版本、每天一个版本、每个里程碑或最佳评估版本;GC 先标记待删除,再确认没有活跃恢复任务引用,最后删除对象和 Manifest。
10. DDP 的可恢复保存实践
普通 DDP 的模型与优化器状态通常在各 Rank 保持一致,公共状态可以由 Rank 0 保存;RNG、Sampler 和数据 Watermark 属于 Rank 本地状态,需要逐 Rank 保存。下面展示共享 POSIX 文件系统上的核心结构,异常处理与指标上报可按平台补充:
import hashlib
import json
import os
import random
from pathlib import Path

import numpy as np
import torch
import torch.distributed as dist


def sha256(path: Path) -> str:
    digest = hashlib.sha256()
    with path.open("rb") as stream:
        for block in iter(lambda: stream.read(8 * 1024 * 1024), b""):
            digest.update(block)
    return digest.hexdigest()


def save_ddp_checkpoint(root, step, attempt_id, model, optimizer, scheduler, scaler, data_state):
    rank = dist.get_rank()
    world = dist.get_world_size()
    tmp = Path(root) / f"step-{step:012d}.tmp-{attempt_id}"
    final = Path(root) / f"step-{step:012d}"

    if rank == 0:
        tmp.mkdir(parents=True, exist_ok=False)
        (tmp / "rank-state").mkdir()
    dist.barrier()

    # 每个 Rank 都保存自身的随机数和数据消费位置。
    torch.save(
        {
            "rank": rank,
            "torch_rng": torch.get_rng_state(),
            "cuda_rng": torch.cuda.get_rng_state_all(),
            "numpy_rng": np.random.get_state(),
            "python_rng": random.getstate(),
            "data_state": data_state,
        },
        tmp / "rank-state" / f"rank-{rank:05d}.pt",
    )

    if rank == 0:
        module = model.module if hasattr(model, "module") else model
        torch.save(
            {
                "step": step,
                "model": module.state_dict(),
                "optimizer": optimizer.state_dict(),
                "scheduler": scheduler.state_dict(),
                "scaler": scaler.state_dict() if scaler else None,
            },
            tmp / "training.pt",
        )
    dist.barrier()

    if rank == 0:
        files = sorted(path for path in tmp.rglob("*") if path.is_file())
        manifest = {
            "step": step,
            "world_size": world,
            "files": [
                {
                    "path": str(path.relative_to(tmp)),
                    "bytes": path.stat().st_size,
                    "sha256": sha256(path),
                }
                for path in files
            ],
        }
        (tmp / "manifest.json").write_text(json.dumps(manifest), encoding="utf-8")
        (tmp / "COMMITTED").write_text("ok\n", encoding="utf-8")
        if final.exists():
            raise FileExistsError(f"immutable checkpoint already exists: {final}")
        os.rename(tmp, final)  # 临时目录与正式目录必须位于同一文件系统。
    dist.barrier()
实际恢复时按以下顺序执行:
- Rank 0 查找最新的
COMMITTED目录并验证 Manifest; - 把选中的路径广播给所有 Rank;
- 所有 Rank 加载公共状态,各自加载对应的
rank-state; - 恢复 Optimizer、Scheduler、Scaler、RNG 和数据游标;
- Barrier 后执行一个短的验证 Step,再进入正式训练。
def restore_ddp_checkpoint(path, model, optimizer, scheduler, scaler):
    rank = dist.get_rank()
    common = torch.load(Path(path) / "training.pt", map_location="cpu", weights_only=False)
    local = torch.load(
        Path(path) / "rank-state" / f"rank-{rank:05d}.pt",
        map_location="cpu",
        weights_only=False,
    )

    module = model.module if hasattr(model, "module") else model
    module.load_state_dict(common["model"])
    optimizer.load_state_dict(common["optimizer"])
    scheduler.load_state_dict(common["scheduler"])
    if scaler and common["scaler"] is not None:
        scaler.load_state_dict(common["scaler"])

    torch.set_rng_state(local["torch_rng"])
    torch.cuda.set_rng_state_all(local["cuda_rng"])
    np.random.set_state(local["numpy_rng"])
    random.setstate(local["python_rng"])
    dist.barrier()
    return common["step"], local["data_state"]
这段代码适合解释正确边界,不应未经压测直接用于 TB 级模型。还要根据实际 PyTorch 版本评估 weights_only、序列化格式、文件和父目录 fsync、异常广播和安全加载策略。示例中的 weights_only=False 只能用于受信任、自有且访问受控的训练状态;不要加载来源不明的 Pickle Checkpoint。若 World Size 改变,旧 Rank 的 RNG 和数据状态不能按编号机械套用,应重新定义数据分区并使用支持重分片的 Checkpoint 格式。
数据游标比 Epoch 更重要
只保存 epoch=3 不能说明已经消费到哪条数据。数据状态至少要能回答:数据集版本、Shard、样本或 Token Watermark、当前 Epoch 内偏移、Shuffle Seed,以及梯度累积到了第几个 Microbatch。做不到精确续跑时,应明确选择“从本 Epoch 开头重放”,并把重复样本数量纳入 RPO。
11. FSDP 与 PyTorch DCP 实践
FSDP 不适合先把所有分片聚合到 Rank 0 再 torch.save。DCP 可以由多 Rank 并行保存,并在加载时根据已经初始化的新模型布局重分片:
import torch.distributed.checkpoint as dcp
from torch.distributed.checkpoint.state_dict import get_state_dict, set_state_dict


def save_fsdp_checkpoint(path, model, optimizer):
    model_state, optim_state = get_state_dict(model, optimizer)
    dcp.save(
        {"model": model_state, "optimizer": optim_state},
        checkpoint_id=path,
    )


def load_fsdp_checkpoint(path, model, optimizer):
    # 模型和优化器必须先按新的 DeviceMesh / World Size 初始化。
    model_state, optim_state = get_state_dict(model, optimizer)
    state = {"model": model_state, "optimizer": optim_state}
    dcp.load(state, checkpoint_id=path)
    set_state_dict(
        model,
        optimizer,
        model_state_dict=state["model"],
        optim_state_dict=state["optimizer"],
    )
Step、Scheduler、RNG 和数据游标仍需作为应用状态保存,不能因为 DCP 成功写出了模型分片就省略。DCP 的文件系统 Writer 假设目标是空目录或不存在的目录,并依赖文件创建语义;存储后端、框架版本和跨拓扑加载都必须按目标环境验证。PyTorch DCP 当前还提供 async_save,但只有后台上传真正完成后才能发布 COMMITTED,不能把“数据已经 Staging 到 CPU”当成远端持久化完成。
DeepSpeed 的 save_checkpoint 必须由所有 Rank 调用,Megatron Distributed Checkpoint 也需要全组参与。框架提供的 latest、Tracker 或 Metadata 文件可以作为内部实现的一部分,但平台层仍应记录 Run、Attempt、对象清单和完成状态,避免升级框架后失去恢复证据。
DeepSpeed 的基本调用方式如下,client_state 用于保存训练循环自己的 Step、数据位置和配置摘要:
tag = f"step-{global_step:012d}"
engine.save_checkpoint(
    checkpoint_root,
    tag=tag,
    client_state={"global_step": global_step, "data_state": data_state},
)

load_path, client_state = engine.load_checkpoint(checkpoint_root, tag=tag)
if load_path is None:
    raise RuntimeError(f"failed to restore {tag}")
所有 Rank 必须进入保存调用,否则会在同步处挂住。ZeRO-3 下不要假设一个已经分片并继续训练的 Engine 可以在原地无条件重新加载;按目标 DeepSpeed 版本验证重新初始化 Engine 后恢复的流程。参考:DeepSpeed Model Checkpointing
12. Kubernetes 上的存储与恢复实践
下面的挂载方式表达一个常见组合:本地盘负责快速 Staging,RWX PVC 保存短期共享恢复点,再由上传器把已经提交的版本同步到对象存储。
spec:
  template:
    spec:
      terminationGracePeriodSeconds: 180
      containers:
        - name: trainer
          env:
            - name: LOCAL_CHECKPOINT_DIR
              value: /checkpoint/local
            - name: SHARED_CHECKPOINT_DIR
              value: /checkpoint/shared
          volumeMounts:
            - name: checkpoint-local
              mountPath: /checkpoint/local
            - name: checkpoint-shared
              mountPath: /checkpoint/shared
      volumes:
        - name: checkpoint-local
          emptyDir: {}
        - name: checkpoint-shared
          persistentVolumeClaim:
            claimName: training-checkpoint-rwx
上传对象存储最好由独立进程处理,并且只处理出现 COMMITTED 的 Step。它可以是同 Pod Sidecar、独立 Deployment 或按版本创建的短任务:
- Sidecar 延迟低,但训练 Pod 被强制删除时也会一起消失;
- 独立上传器不会与训练容器同生共死,更适合可靠搬运;
- 直接使用框架的对象存储 Writer 可以减少中间层,但必须验证多 Rank 协调、限流、重试和一致性语义。
恢复 Pod 启动时,可以由 Init Container 把选定版本下载到本地缓存,Trainer 再并行加载;也可以从共享文件系统直接读取。无论哪种方式,都不要在 Init Container 中盲目取路径名最大的目录,而要运行同一套 Manifest 校验和回退逻辑。
CSI VolumeSnapshot 可以保护整个卷,但默认只能说明存储块在某个时刻被截取,不能自动保证多个 Rank 的应用状态一致。若要把 Snapshot 当作恢复点,仍应先让训练进程完成 Barrier、刷新文件并发布 Manifest,再触发 Snapshot;否则它只能作为灾难恢复材料,不能直接承诺精确续训。
一份恢复 Runbook
- 确认旧 Worker Group 已经退出,不存在继续写同一 Run 的残留 Rank;
- 根据 XID、Node 状态、RDMA 和存储日志决定是否隔离原节点;
- 从
latest.json开始校验,失败则回退上一个已提交版本; - 建立满足拓扑条件的新 Worker Group;
- 先初始化模型、Optimizer、并行组和目标 Sharding;
- 加载模型与优化器,再加载 Scheduler、Scaler、RNG 和数据状态;
- 核对恢复 Step、World Size、全局 Batch 和 Dataset Snapshot;
- 运行 5—20 个观察 Step,确认 Loss、梯度范数、吞吐和 Collective 正常;
- 记录丢失 Step、下载/加载时间、排队时间和最终 RTO;
- 新 Checkpoint 成功提交后,才允许 GC 清理故障前的版本。
监控哪些指标
| 指标 | 作用 |
|---|---|
checkpoint_last_success_timestamp_seconds |
判断距离上一次有效恢复点有多久 |
checkpoint_save_duration_seconds |
观察保存 P50/P95/P99 和 I/O 退化 |
checkpoint_bytes_total |
估算吞吐、容量和异常小文件 |
checkpoint_save_failures_total |
发现写入、校验或发布失败 |
checkpoint_validation_failures_total |
发现缺 Shard、Checksum 或格式错误 |
checkpoint_fallback_total |
统计最新版本不可用而发生的回退 |
training_recovery_duration_seconds |
衡量端到端 RTO |
training_recovery_lost_steps |
衡量实际 RPO |
告警阈值不应只看保存失败。即使没有报错,time() - checkpoint_last_success_timestamp_seconds 超过计划间隔的两倍,也说明已经失去预期恢复能力。异步保存还应监控排队深度和未完成版本数,防止后台 I/O 越积越多,最终耗尽主机内存或本地盘。
如果计划间隔通过 Label 暴露为秒数,可以从下面的 PromQL 思路开始,再按指标标签调整:
time() - max by (run_id) (checkpoint_last_success_timestamp_seconds)
  > 2 * max by (run_id) (checkpoint_planned_interval_seconds)
恢复验收不能只看进程重新 Running
至少核对以下证据:
- 恢复后的第一个 Step 等于 Manifest 记录值,而不是从零开始;
- Optimizer State 非空,LR 与恢复前相同;
- Dataset Snapshot、Sampler Watermark 和已处理 Token 正确;
- 在约定窗口内,Loss 与梯度范数没有异常跳变;
- 各 Rank 的 Step 一致,没有部分 Rank 偷跑;
- 新 Attempt 写出的第一个 Checkpoint 可以再次独立恢复;
- 与无故障基线相比,最终评估结果处于预先定义的容差内。
13. 节点故障后的标准恢复流程
一次自动恢复可以拆成八个步骤:
- 检测:进程退出、NCCL Watchdog、心跳、Node NotReady、XID 或抢占通知触发故障;
- 收敛状态:标记本次 Attempt 失败,停止旧 Worker Group,防止残留 Rank 继续写状态;
- 保留证据:收集首个异常 Rank、所有 Rank 退出码、GPU XID、dmesg、NCCL/RDMA、Pod Event 与存储日志;
- 分类:区分基础设施、暂态网络、容量、OOM、代码、数据与数值错误;
- 隔离:有硬件证据时给节点或 GPU 加故障标签/污点,避免下一次仍调度回原机器;
- 重新准入:以完整 Gang 重新排队,满足 GPU 型号、数量、RDMA 和拓扑要求后再启动;
- 恢复:选择最近一个已提交且校验通过的 Checkpoint,重建 World 并加载状态;
- 验证:确认恢复 Step、数据 Watermark、Loss 范围和 Collective 正常,再把 Attempt 标记为成功恢复。
自动化应保留每次 Attempt 的节点、Rank、Checkpoint、错误分类和恢复耗时。Job 最终 Completed 不能覆盖前几次失败记录。
14. 相同卡数恢复与缩容恢复
相同 World Size
这是最容易实现和验证的路径。新 Worker Group 保持相同 DP/TP/PP/EP 布局,通常可以直接加载原分片。生产上线至少先保证这一条路径稳定。
World Size 变化
弹性恢复可能改变数据并行规模,甚至改变 Tensor/Pipeline/Expert Parallel。此时必须同时处理:
- 模型和优化器状态重分片;
- 全局 Batch Size 与梯度累积;
- 学习率是否随 World Size 调整;
- 数据分区、Sampler 与已消费样本;
- Pipeline Stage 和 Expert 的重新映射;
- 编译缓存、通信组与随机状态。
| 技术 | 跨拓扑恢复能力 | 生产提醒 |
|---|---|---|
| PyTorch DCP | 支持加载时重分片,适配 DDP/FSDP/DTensor 等状态 | 必须用目标版本和 StorageBackend 实测 |
| Megatron Distributed Checkpoint | 可跨多种并行配置加载 | 优化器格式有不同可重分片边界 |
| DeepSpeed Universal Checkpoint | 目标是跨 ZeRO/3D 并行配置恢复 | 功能仍在演进,先验证模型和优化器组合 |
| Orbax | 支持多 Host 与拓扑无关加载能力 | 所有进程的 Sharding 和 Barrier 必须正确 |
| Horovod Elastic | 能在成员变化时同步内存状态 | 还要处理 Batch、学习率和数据重分区 |
Accelerate save_state |
封装底层后端保存 | 官方定位更偏同一环境续跑,跨环境看底层格式 |
“能改卡数启动”不等于“训练语义不变”。缩容后的吞吐、全局 Batch、优化器更新频率和数据顺序都可能变化,必须对比无故障基线的 Loss 与最终评估。
15. Kubernetes 上如何组合
15.1 Gang Scheduling
多机任务应在完整资源满足后一起启动,避免部分 Worker 占着 GPU 等待其余 Rank。Kubeflow Trainer 可以对接 Kueue、Volcano 等调度方案;JobSet 和 Volcano Job 也能表达整组失败与重启策略。
Kueue 负责配额、优先级、准入和拓扑;训练控制器负责创建 Worker;训练框架负责进程组和 Checkpoint。三者不要互相越权。
15.2 整组重启策略
JobSet 的 FailurePolicy 可以按子 Job 失败原因选择 RestartJobSet、RestartJob 或直接失败;Volcano Job 可在 PodFailed、PodEvicted 等事件上执行 RestartJob。同步训练通常以整组重启作为安全默认值。
下面只展示策略骨架,字段应按集群安装的 JobSet API 版本校验:
spec:
  failurePolicy:
    maxRestarts: 3
    restartStrategy: Recreate
    rules:
      - name: restart-workers
        action: RestartJobSet
        targetReplicatedJobs: [workers]
        onJobFailureReasons: []
        onJobFailureMessagePatterns: []
参考:JobSet Failure Policy、Volcano Job Policy
15.3 抢占和优雅退出
Pod 收到 SIGTERM 后可以触发一次紧急保存,但不能把它当成唯一保障:抢占通知可能很短,节点也可能直接掉电。建议同时使用周期性持久 Checkpoint,并让紧急保存超时后主动退出,避免无限占用 Terminating Pod。
15.4 故障节点隔离
自动重试之前至少检查:
- 节点是否出现 XID、ECC、PCIe 或 NVLink 错误;
- RDMA NIC、端口、PFC/ECN 与链路错误是否异常;
- 同一节点近期是否连续导致多个训练 Attempt 失败;
- GPU 健康检查是否只验证
nvidia-smi,却没有验证显存、P2P 和 Collective。
硬件故障应由 Node Problem Detector、GPU Operator、DCGM 或独立健康控制器转成 Label/Taint,再由调度器排除。训练脚本不应自己修改 Node。
16. RPO、RTO 与 Checkpoint 间隔
- RPO:故障后最多丢失多少训练进度。周期性保存时,上限通常接近 Checkpoint 间隔;异步保存未提交的部分不算有效恢复点。
- RTO:从故障发生到训练重新稳定产出 Step 的时间。
Checkpoint 越频繁,丢失的训练步数越少,但 I/O、暂停和存储成本越高。可以用 Young 近似式作为第一次实验的起点:
它不是最终答案。异步 I/O、排队、局部保存、对象存储限流和大规模并行都会改变实际最优值。生产配置应通过故障注入测量,而不是照搬公式。
建议持续记录:
- Checkpoint 写入与加载 P50/P95/P99;
- 已提交版本年龄;
- 每次故障丢失的 Step/Token;
- MTTD、RTO 和恢复成功率;
- 重新排队耗时与坏节点重复命中率;
- 恢复前后 Step Time、Loss 和数据 Watermark 差异。
17. 必须做的故障演练
| 演练 | 注入方法 | 合格标准 |
|---|---|---|
| Rank 进程退出 | 杀死一个 Worker 进程 | 全组退出并在预算内恢复,没有僵尸 Rank |
| Pod 被驱逐 | 删除一个 Worker Pod | 控制器按整组策略重建,Attempt 可追踪 |
| 节点宕机 | 停机或隔离 kubelet | 新 Attempt 不再命中坏节点 |
| NCCL/RDMA 中断 | 阻断训练网或关闭端口 | Hang 在超时内被发现,日志能定位链路 |
| 最新 Checkpoint 不完整 | 删除一个 Shard 或完成标志 | 自动回退到上一个有效版本 |
| 对象存储变慢 | 注入高延迟/限流 | 异步队列有上限,不会无限占用内存 |
| Spot 抢占 | 发送终止通知 | 紧急保存受时限控制,失败后仍可从周期版本恢复 |
| World Size 改变 | 以较少或较多 GPU 恢复 | 重分片成功,Batch/LR/数据语义经过验证 |
| 连续故障 | 在同一任务注入 3 次故障 | 达到重试预算后停止并告警,不无限烧卡 |
| 数值一致性 | 与无故障基线跑相同步数 | Loss 轨迹与最终评估在约定容差内 |
一次恢复成功只能证明存在可行路径。生产验收应在不同训练阶段重复注入,并覆盖保存过程中故障、刚发布后故障和加载过程中故障。
一个最小可重复实验
可以先用较小模型完成如下闭环,再扩大到正式训练:
- 固定数据集 Snapshot、Seed、World Size 和镜像,运行一条不中断基线;
- 每 50 Step 保存一次,在 Step 135 左右删除一个 Worker Pod;
- 确认旧 World 的其他 Rank 退出,控制器没有留下继续占卡的孤儿进程;
- 新 Attempt 从 Step 100 的有效版本恢复,数据 Watermark 与 Manifest 一致;
- 观察至少 20 Step,比较基线与恢复路径的 Loss、梯度范数和学习率;
- 等 Step 150 产生新的有效 Checkpoint,再次重启并验证它能被加载;
- 制造一个缺少
COMMITTED或缺少一个 Shard 的 Step 200 目录; - 确认恢复器拒绝 Step 200,并自动回退 Step 150;
- 连续注入三次故障,确认超过预算后任务停止并告警;
- 汇总丢失 Step、Checkpoint 耗时、重新排队时间、加载时间和端到端 RTO。
在隔离的测试命名空间中,可以用下面的命令触发 Pod 级故障。节点断电、RDMA 阻断和 GPU XID 演练影响面更大,应使用专门故障节点和变更窗口。
结果记录至少包含以下字段,避免只留下“恢复成功”的结论:
| 字段 | 示例含义 |
|---|---|
| Run / Attempt | 区分原训练和每次重启 |
| 故障时间与首个失败 Rank | 判断检测延迟和根因顺序 |
| 故障节点、GPU、XID/RDMA 证据 | 判断是否需要隔离节点 |
| 选择的 Checkpoint 与回退次数 | 证明恢复器选对版本 |
| 保存 Step / 恢复 Step / 首个新 Step | 计算实际丢失进度 |
| 调度、下载、加载、验证耗时 | 拆解 RTO 瓶颈 |
| 恢复前后 Loss、LR、数据 Watermark | 验证训练语义 |
| 新版本再次加载结果 | 避免恢复后只能继续跑、却不能再次恢复 |
18. 常见反模式
- 只保存模型权重,却宣称支持续训;
- Checkpoint 写在故障节点的 HostPath,且没有远端副本;
- 所有 Rank 直接覆盖同一个文件;
- 更新
latest后才开始写 Shard; - Pod 重启次数等同于训练恢复次数;
- 不区分 XID、OOM、代码异常和数据错误,统一无限重试;
- Worker 数变化后仍沿用原学习率和数据分区,却不验证收敛;
- 只在训练结束验证 Checkpoint,从未在中途真正加载;
- 抢占时依赖
preStop完成数 TB 保存; - 为追求恢复速度只保留本地版本,没有跨故障域副本;
- 自动恢复后不核对 Step、数据 Watermark 和 Loss。
19. 分规模的建议
1—8 GPU
从 DDP 或 FSDP 开始。使用 torchrun、共享/对象存储和完整 Snapshot,优先把单机与单节点故障恢复跑通。没有必要一开始就引入复杂 3D 并行。
8—64 GPU
根据模型显存选择 FSDP 或 DeepSpeed ZeRO;用 DCP/分片 Checkpoint 降低保存瓶颈。Kubernetes 上增加 Gang、队列、拓扑调度与整组重启,开始测量 RPO/RTO。
64 GPU 以上的大模型预训练
评估 Megatron Core/NeMo 或经过充分验证的 DeepSpeed 3D 并行。Checkpoint 需要并行、异步和分层保存;训练网络、存储与节点健康进入统一故障域设计。此时一分钟的全局停顿都可能对应大量 GPU 成本。
Spot、动态资源和复杂 Python 工作流
可以评估 Ray Train 或 Horovod Elastic,但要先定义允许变化的并行维度。模型并行组通常要求固定拓扑,最容易弹性的往往只是数据并行副本。弹性不应以破坏 Batch、数据消费和收敛为代价。
20. 生产检查表
- 已明确训练框架、Launcher、训练控制器、队列和存储各自职责;
- 失败恢复的单位是 Rank、Worker Group 还是整个 Job,行为已验证;
- Checkpoint 包含模型、优化器、调度器、Scaler、RNG、Step 和数据游标;
- 多 Rank 保存使用 Manifest、校验和和原子发布协议;
- Step 目录不可变,
latest只作为指针且能够自动回退; - 至少有一个 Checkpoint 位于训练节点故障域之外;
- 已测量单版本大小、保存带宽、加载带宽、容量余量和 GC 策略;
- 对象存储已配置版本保护、最小权限、加密和访问审计;
- 同 World Size 恢复已经成为上线硬门槛;
- 跨 World Size 恢复单独验证了重分片、Batch、LR 和数据语义;
- Gang Scheduling 不会让部分 Worker 长期占卡;
- XID/RDMA/节点故障可以自动隔离,用户错误不会无限重试;
- 抢占、强杀、节点宕机、网络中断和坏 Checkpoint 均做过演练;
- 记录 MTTD、RPO、RTO、丢失 Step、排队时间和恢复成功率;
- 监控最新有效 Checkpoint 年龄、异步队列和回退次数;
- 每次 Attempt 的节点、Rank、错误与 Checkpoint 均可追溯;
- 恢复后的 Loss、数据 Watermark 和最终模型质量与基线一致。
训练平台的可靠性不取决于控制器能不能重新创建 Pod,而取决于旧 World 能否干净退出、新 World 能否避开故障域、最新完整状态能否被验证加载,以及恢复后的训练语义是否仍然正确。
参考资料
- PyTorch Elastic Run
- PyTorch Distributed Checkpoint
- DeepSpeed Model Checkpointing
- Megatron Core Distributed Checkpoint
- Megatron Bridge Resiliency
- Orbax CheckpointManager
- Elastic Horovod
- Ray Train Fault Tolerance
- Kubernetes Persistent Volumes
- Kubeflow Trainer Runtime Guide
- JobSet Failure Policy
- Volcano Job