OpenTelemetry 与 Kubernetes 入门:从 Trace、Span 到 Collector
OpenTelemetry 常被简称为 OTel。第一次接触它时,最容易遇到两个问题:名词很多,而且它看起来与 Prometheus、日志系统、APM 都有重叠。
如果你已经理解基本概念,想直接观测 API Server、Scheduler、Controller Manager、etcd、CoreDNS 和集群对象状态,可以继续阅读 OpenTelemetry × Grafana 实战:观测 Kubernetes 控制面与集群状态。
可以先记住一句话:
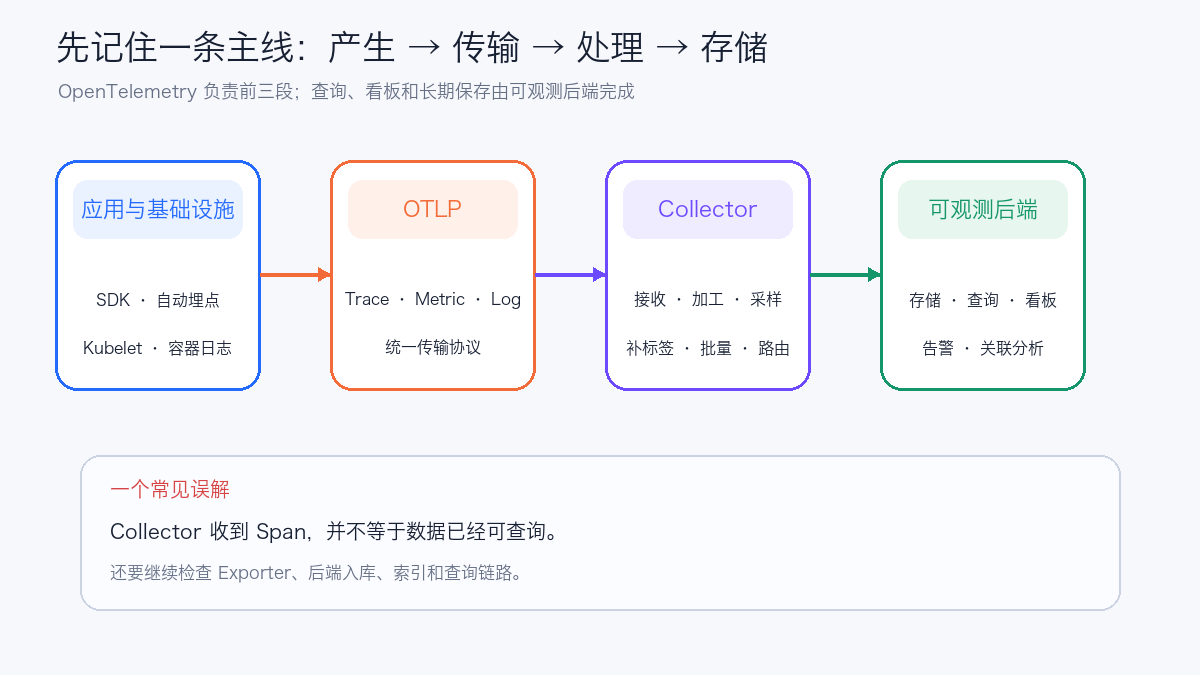
OpenTelemetry 是一套生成、传输和处理遥测数据的开放标准与工具;它本身不负责长期存储和查询。
所谓遥测数据,就是系统运行时主动留下的观察材料,主要包括 Trace、Metric 和 Log。OpenTelemetry 让不同语言、框架和平台使用相同的数据模型、字段约定与传输协议,再由可观测后端负责存储、检索、看板和告警。
这篇文章不要求读者预先了解分布式追踪。我们会从一次下单请求开始,逐步回答以下问题:
- Trace 和 Span 到底是什么;
- Trace、Metric 和 Log 分别解决什么问题;
- Context 为什么能把多个服务的调用串起来;
- SDK、自动埋点、OTLP 和 Collector 各自处于什么位置;
- Collector 在 Kubernetes 中为什么常以 DaemonSet 和 Deployment 两种形态出现;
- 如何用五条测试 Trace 验证整条管道。
1. 用快递系统理解四个基本概念
把一次用户请求想象成一个快递包裹:
| 快递系统 | OpenTelemetry | 解决的问题 |
|---|---|---|
| 一个包裹的完整运送过程 | Trace | 这一次请求究竟经过了哪些服务 |
| 包裹经过分拨中心、干线和派送站 | Span | 每一个具体步骤耗时多久、成功还是失败 |
| 包裹始终携带同一个运单号 | Trace Context | 跨进程后仍能判断这些步骤属于同一次请求 |
| 每小时包裹量、平均时效和超时比例 | Metric | 系统整体是否变慢、错误是否增加 |
| “地址无法识别”“车辆故障”的详细记录 | Log | 某个时间点具体发生了什么 |
这几个信号回答的问题不同:
- Metric 擅长快速发现“错误率从 0.1% 升到 5%”;
- Trace 擅长解释“错误集中在支付服务调用数据库的步骤”;
- Log 擅长提供“数据库返回了哪个错误码、当时有哪些上下文”。
完整的排障过程通常先从 Metric 发现异常,再从 Trace 找到慢点或失败步骤,最后进入对应 Span 关联的 Log 查看细节。
2. Trace 与 Span:一次请求的树
假设用户调用 POST /checkout,前端依次访问订单服务、支付服务和数据库:
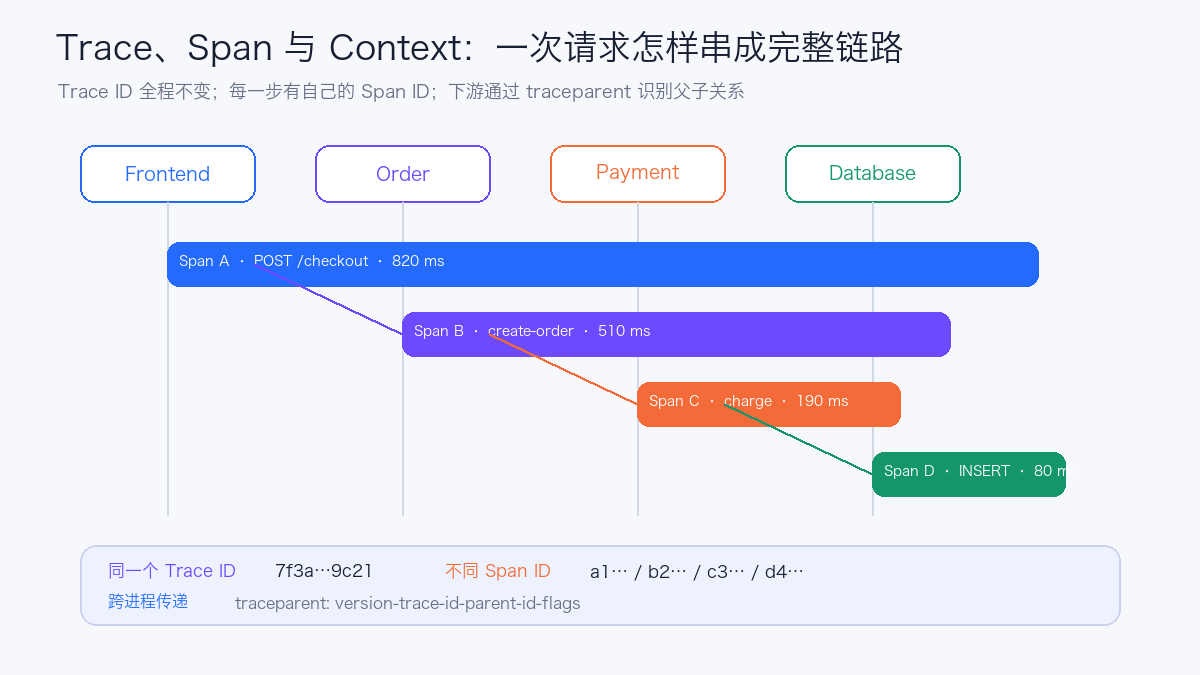
整个调用过程是一个 Trace,每个步骤是一个 Span:
Trace: checkout request
└─ Span A: Frontend POST /checkout
   └─ Span B: Order create-order
      └─ Span C: Payment charge
         └─ Span D: Database INSERT
每个 Span 通常包含:
| 字段 | 含义 | 示例 |
|---|---|---|
| Trace ID | 整条调用链的身份 | 四个 Span 相同 |
| Span ID | 当前步骤的身份 | 每个 Span 不同 |
| Parent Span ID | 当前步骤由谁调用 | Span C 的父级是 Span B |
| Name | 这个步骤做什么 | POST /checkout、charge |
| Start / End | 开始、结束和持续时间 | 190 ms |
| Status | 成功、错误或未设置 | ERROR |
| Attributes | 用于筛选和分析的键值 | HTTP 方法、状态码、数据库类型 |
| Events | Span 生命周期中的离散事件 | 异常、重试、缓存未命中 |
| Links | 与其他 Trace 或 Span 的非父子关联 | 消息队列生产者与消费者 |
Span 是一段有开始和结束的工作。应用持续运行不是一个无限长的 Span;一次请求、一次数据库查询或一次消息处理才是合适的 Span 边界。
2.1 Span Kind
Span Kind 描述当前操作在调用关系中的角色:
| Kind | 常见位置 |
|---|---|
SERVER |
HTTP/gRPC 服务端处理请求 |
CLIENT |
调用下游 HTTP、数据库或 RPC |
PRODUCER |
向消息系统发送消息 |
CONSUMER |
从消息系统接收并处理消息 |
INTERNAL |
进程内部业务步骤 |
Kind 不决定父子关系,但能帮助后端正确绘制服务调用图和计算服务端、客户端延迟。
2.2 Attribute 和 Event 怎样选
稳定且用于筛选的字段适合作为 Attribute,例如:
http.request.method = POST
http.response.status_code = 503
server.address = order-api
db.system.name = postgresql
发生在 Span 生命周期中、带有时间点的信息适合作为 Event,例如“第一次重试”“连接池等待超时”“抛出异常”。
订单号、用户 ID、完整 URL 参数等高基数或敏感数据不能无条件写入 Attribute。Trace 后端虽然比 Metric 更能承受高基数,数据量、隐私和索引成本仍然存在。
3. Context Propagation:跨服务仍属于同一条链
Frontend 调用 Order 时,两个进程没有共享内存。它们需要通过请求携带 Trace Context。HTTP 场景通常使用 W3C Trace Context 定义的 traceparent Header:
traceparent: 00-7f3a...9c21-a1b2...e5f6-01
             │     │          │       └─ flags
             │     │          └─ 上游 Span ID
             │     └─ Trace ID
             └─ version
发送端把当前上下文注入 HTTP Header,接收端提取它并创建子 Span。大多数 HTTP、gRPC 和消息队列客户端可以通过自动埋点完成注入和提取。
如果某一跳没有传播 Context,下游会创建新的 Trace ID,页面上就会看到两条断开的链。排查 Trace 断链时,应先检查:
- 客户端是否注入
traceparent; - 服务端是否提取 Header;
- 反向代理或网关是否删除了 Header;
- 异步任务是否保存并恢复了 Context;
- 消息生产者和消费者是否使用正确的传播方式。
3.1 Baggage 不是 Trace Attribute
Baggage 是随 Context 跨服务传播的键值数据,例如受控的租户等级。它可以帮助下游决定怎样标记 Span,但也会随着请求传播,增加网络开销,并可能泄露信息。
密码、Token、Cookie、个人身份信息和完整 Prompt 都不应放入 Baggage。Baggage 也不会自动出现在 Span 上,需要埋点或 Processor 显式读取和复制。
4. Trace、Metric 与 Log 的区别
4.1 Trace:保留单次请求的因果关系
Trace 适合回答:
- 哪个服务最慢;
- 错误最早出现在哪一步;
- 重试是否放大了下游压力;
- 跨服务调用是否符合预期;
- 某次异常请求与正常请求有什么区别。
Trace 数据量通常与请求数成正比,因此生产环境常需要采样。
4.2 Metric:把大量事件聚合为时序
Metric 适合回答:
- 每秒请求数是多少;
- P95 延迟是否越过 SLO;
- 错误率是否持续升高;
- Collector 队列是否接近上限;
- CPU、内存或队列长度如何变化。
常见 Metric Instrument:
| Instrument | 用途 | 示例 |
|---|---|---|
| Counter | 只增加的累计量 | 请求总数、错误总数 |
| UpDownCounter | 可以增加或减少 | 当前连接数 |
| Histogram | 记录数值分布 | 请求耗时、响应大小 |
| Gauge | 记录某个时刻的值 | 温度、队列深度 |
Metric Label 必须控制基数。把 Request ID、Trace ID、Pod UID 或用户 ID 放进 Label,会为每个值创建新的时序,迅速消耗 Prometheus 内存和存储。
4.3 Log:记录离散事件
Log 包含时间、严重级别、正文和结构化字段。OpenTelemetry 可以:
- 让应用直接通过 OTel Log SDK 发出日志;
- 通过日志桥接器接入已有日志框架;
- 在 Kubernetes 节点读取容器 stdout/stderr 文件;
- 把
trace_id和span_id注入日志,建立 Log 与 Trace 的跳转关系。
将日志送进 Collector 不会自动把无结构的正文变成高质量字段。生产环境仍需约定 JSON 结构、时间格式、级别、服务名、错误码和脱敏规则。
5. Resource、Attribute 与 Instrumentation Scope
这三个概念容易混淆。
5.1 Resource:谁产生了数据
Resource 描述产生遥测的实体:
service.name = checkout-api
service.version = 1.8.2
deployment.environment.name = production
k8s.namespace.name = commerce
k8s.pod.name = checkout-api-7c8d9f-x2p4k
k8s.node.name = worker-17
这些字段会被同一实体产生的多个 Span、Metric Data Point 或 Log Record 共享。
5.2 Attribute:这次操作有什么特征
Attribute 通常属于具体的 Span、Metric Data Point 或 Log,例如 HTTP 方法、状态码和数据库操作。service.name 应作为 Resource Attribute;http.request.method 应作为 Span Attribute。
5.3 Instrumentation Scope:谁创建了这条遥测
Instrumentation Scope 记录产生遥测的库或模块,例如 opentelemetry.instrumentation.fastapi 及其版本。它能帮助排查“这批 Span 是业务手工埋点产生,还是某个自动埋点库产生”。
一个简化的 OTel 数据层级是:
6. API、SDK、自动埋点和 Collector 怎样配合
6.1 API
API 定义应用代码怎样创建 Span、Metric 等对象。业务库依赖 API 后,不需要绑定具体的导出实现。
6.2 SDK
SDK 实现采样、处理、聚合和导出。应用进程通常通过环境变量或代码配置 SDK 把数据发给 Collector。
6.3 自动埋点
自动埋点针对 HTTP 框架、RPC、数据库客户端和消息系统等通用组件创建 Span。它适合快速获得入口和依赖调用,但不知道业务语义。
例如自动埋点可以知道服务调用了 POST /orders,却不知道内部正在执行“库存预留”还是“风控检查”。关键业务步骤仍适合增加手工 Span。
6.4 Collector
Collector 是独立进程,位于应用和可观测后端之间。它由组件和 Pipeline 组成:
| 组件 | 作用 | 例子 |
|---|---|---|
| Receiver | 接收或抓取数据 | OTLP、Prometheus、File Log、Kubelet Stats |
| Processor | 加工数据 | Memory Limiter、Kubernetes Attributes、Batch、Filter |
| Exporter | 发往目标 | OTLP、Prometheus、Debug |
| Connector | 连接两个 Pipeline | 从 Trace 生成 Metric |
| Extension | 提供非数据面能力 | Health Check、认证、持久队列 |
配置一个组件不代表它已经运行。组件必须被某个 service.pipelines 引用:
receivers:
  otlp:
    protocols:
      grpc:
        endpoint: 0.0.0.0:4317
      http:
        endpoint: 0.0.0.0:4318

processors:
  memory_limiter:
    check_interval: 1s
    limit_mib: 192
  batch:
    timeout: 2s

exporters:
  debug:
    verbosity: detailed

service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [memory_limiter, batch]
      exporters: [debug]
这条 Pipeline 的含义是:在 4317/4318 接收 Trace,先保护内存,再批量处理,最后打印到 Collector 日志。
7. OTLP:统一的传输协议
OTLP 是 OpenTelemetry Protocol。常见入口为:
| 传输 | 默认端口 | 常见地址 |
|---|---|---|
| OTLP/gRPC | 4317 | otel-collector:4317 |
| OTLP/HTTP | 4318 | /v1/traces、/v1/metrics、/v1/logs |
OTLP 规定数据怎样编码和传输,Semantic Conventions 规定常见字段怎样命名。两者解决的问题不同:协议一致只能保证数据能送达;字段语义一致才能让多个团队的数据一起查询。
应用不必把三种信号全部走同一个端口。可以先让 Trace 使用 OTLP,Metric 继续由 Prometheus 抓取,日志继续写 stdout,再逐步统一。
8. Kubernetes 为 OpenTelemetry 增加了什么难题
虚拟机时代,服务实例和主机的关系较稳定。Kubernetes 中 Pod 会重建、漂移和扩缩容,仅有一个容器 IP 很难解释遥测来自哪个 Workload。
平台通常需要把以下层次关联起来:
Cluster
└─ Namespace
   └─ Deployment / StatefulSet / DaemonSet / Job
      └─ Pod
         └─ Container
            └─ Application service
这正是 Kubernetes Attributes Processor 的价值。它根据 Pod UID、连接来源等信息找到 Pod,再给 Trace、Metric 和 Log 补充受控的 Kubernetes Resource Attribute。
一个重要边界是:**Kubernetes Attributes Processor 只负责补元数据,不会主动采集节点 CPU、Pod 内存、容器日志或 Kubernetes 对象状态。**这些数据分别需要其他 Receiver:
| 想采什么 | 常见组件 | 典型部署位置 |
|---|---|---|
| 应用 OTLP | OTLP Receiver | Agent 或 Gateway |
| 容器 stdout/stderr | File Log Receiver | 每节点 DaemonSet |
| Node、Pod、Container 资源指标 | Kubelet Stats Receiver | 每节点 DaemonSet |
| 节点宿主机指标 | Host Metrics Receiver | 每节点 DaemonSet |
| Kubernetes 对象与集群事件 | Kubernetes Cluster Receiver | 单个活跃实例 |
已有 Prometheus /metrics |
Prometheus Receiver | 明确分片或 Target Allocator |
9. Kubernetes 中怎样部署 Collector
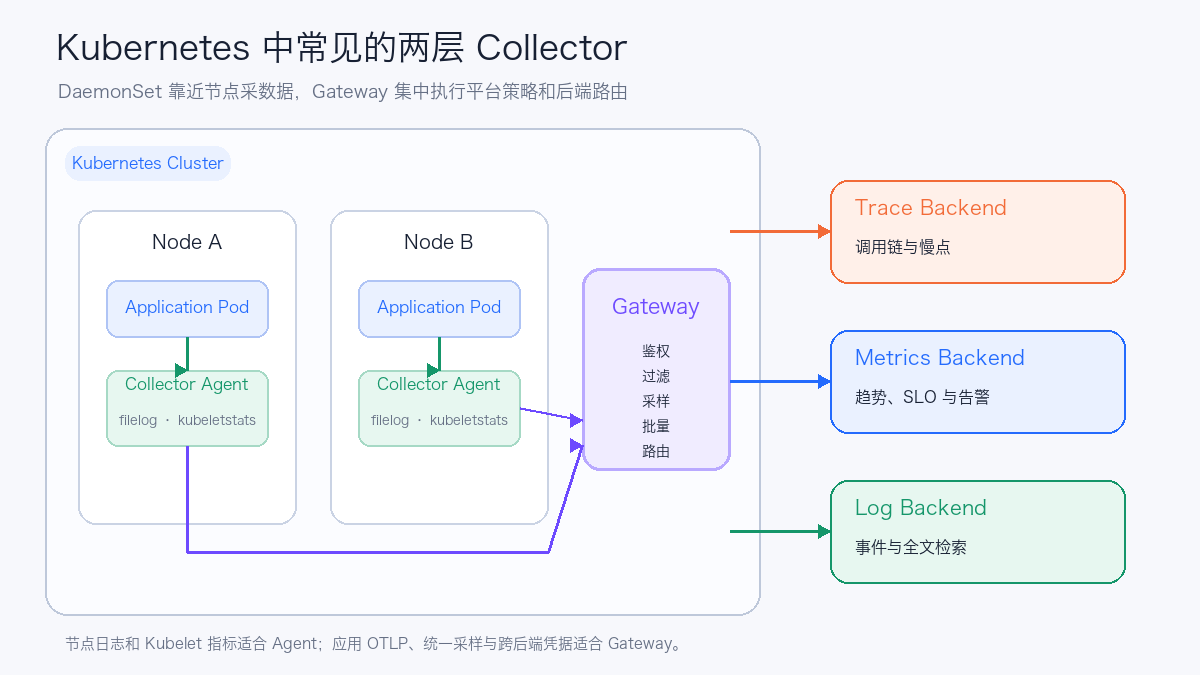
9.1 Sidecar
每个业务 Pod 附带一个 Collector。隔离清晰,但 CPU、内存、配置和升级成本都会随 Pod 数增长。它适合少量需要独立凭据或特殊管道的工作负载。
9.2 DaemonSet Agent
每个节点一个 Collector。它靠近 Kubelet 和容器日志文件,适合 File Log、Kubelet Stats、Host Metrics,也可以接收本节点应用的 OTLP。
9.3 Deployment Gateway
一个或多个 Collector 副本通过 Service 提供统一 OTLP 入口,集中执行鉴权、过滤、采样、批量和后端路由。应用只需知道一个集群内地址。
9.4 Agent + Gateway
较完整的生产结构通常是两层:
Agent 完成靠近数据源的采集和初步加工,Gateway 管理跨团队策略和后端凭据。两层都会增加资源和运维成本,小集群可以先从单层 Gateway 开始。
10. 五分钟实验:只看 OpenTelemetry 自己
为了先理解 Collector,不安装任何可观测后端。实验使用 telemetrygen 生成五条 Trace,由 Collector 的 Debug Exporter 打印出来。
完整清单位于 examples/opentelemetry-kubernetes-basics。
10.1 部署 Collector
cd examples/opentelemetry-kubernetes-basics
kubectl apply -f collector.yaml
kubectl -n otel-basics rollout status deploy/otel-collector
确认 OTLP Service:
它同时暴露 4317 和 4318,测试 Job 使用 gRPC 4317。
10.2 发送五条 Trace
kubectl apply -f trace-job.yaml
kubectl -n otel-basics wait \
  --for=condition=complete job/telemetrygen-traces \
  --timeout=180s
网络受限集群如果不能直接访问 GHCR,应先把 telemetrygen:v0.158.0 同步到集群可访问的 Registry,并只修改镜像地址。
10.3 观察 Collector 输出
日志中应能找到五个 Trace ID。telemetrygen 为每个 Trace 生成父子 Span,并附加以下测试字段:
当 Job 直接运行在集群内,Kubernetes Attributes Processor 还会根据连接来源补充 Namespace、Pod、UID 和 Node 等 Resource Attribute。
这时已经能回答完整数据路径:
telemetrygen是数据生产者;- OTLP/gRPC 是传输协议;
otlp是 Receiver;memory_limiter、k8s_attributes和batch是 Processor;debug是 Exporter;- Collector 日志是临时输出位置。
Debug Exporter 只适合学习和排障。生产环境高详细度打印会产生大量日志,并消耗 CPU 与磁盘。
10.4 清理
kubectl delete namespace otel-basics
kubectl delete clusterrolebinding otel-basics-collector
kubectl delete clusterrole otel-basics-collector
Namespace 删除后,ClusterRole 和 ClusterRoleBinding 仍需单独清理。
11. 从入门配置走向可查询系统
Debug Exporter 验证的是 Collector 已收到数据。要让数据可查询,需要为不同 Pipeline 配置后端 Exporter:
三种信号可以进入不同系统。选择后端时需要分别考虑:
| 信号 | 主要容量因素 | 常见查询方式 |
|---|---|---|
| Trace | 请求量、Span 数、采样率、Attribute 索引 | Trace ID、服务、操作、错误、延迟 |
| Metric | Active Series、采集间隔、保留时间 | 聚合、速率、分位数、告警 |
| Log | 每秒字节、字段索引、压缩率、保留时间 | 关键词、结构化字段、Trace ID |
验收时要沿链路逐层检查:
业务请求返回 200 与遥测管道成功是两件独立的事。Exporter 失败通常不会让业务请求失败,因此必须监控 Collector 自己。
12. 采样:控制 Trace 数量
12.1 Head Sampling
请求开始时决定是否采样。它开销低、实现简单,但此时还不知道请求最终是否错误或变慢。
12.2 Tail Sampling
Collector 暂存一条 Trace 的 Span,等待请求结束后再决定是否保留。它可以优先保留错误、慢请求和关键路径,但需要更多内存,并要求同一 Trace 的 Span 到达同一个有状态采样器。
12.3 采样不会替代 Metric
如果只保留 10% Trace,不能直接用采样后的 Trace 数计算精确请求率和错误率。请求量、错误率和延迟 SLO 应继续使用 Metric;Trace 用于解释单次请求的因果关系。
13. 生产环境需要关注什么
13.1 先统一 Resource 和字段规范
至少统一:
service.name的命名规则;- 环境、版本、区域和集群字段;
- Kubernetes 元数据允许列表;
- HTTP、RPC、数据库和消息系统遵循的 Semantic Conventions;
- 哪些字段属于敏感信息或禁止索引。
没有这些规范,即使所有服务都能上报 OTLP,跨团队查询仍会充满同义字段和错误维度。
13.2 控制基数和正文
- Metric Label 只使用数量有限的稳定值;
- URL 路由模板优先于原始 URL;
- Trace Attribute 不记录密码、Token、Cookie 和完整请求正文;
- Log 在 Collector 侧执行字段允许列表和脱敏;
- Baggage 不传播敏感信息。
13.3 让 Collector 可观察
重点监控:
- Receiver 接收和拒绝的数据量;
- Exporter 成功与失败数量;
- 发送队列长度和容量;
- 内存、CPU、GC 和进程重启;
- 后端请求延迟、超时和重试;
- Sampling 前后的 Span 数;
- Collector 配置版本与发布状态。
Collector Pod Running 只表示进程存在。Exporter 持续失败、队列已满或 Processor 误删数据时,Pod 仍可能保持 Ready。
13.4 有状态组件不能随意多副本
- Kubernetes Cluster Receiver 通常只保留一个活跃实例,避免重复采集集群数据;
- Prometheus Receiver 的多个相同副本会重复抓取,规模化时需要分片或 Target Allocator;
- Tail Sampling 需要按 Trace ID 做稳定路由;
- Metric 数据流要保持唯一 Resource 身份和 Single Writer。
13.5 安全边界
- OTLP Service 只在受控网络暴露;
- 跨网络边界使用 TLS/mTLS 与认证;
- 用 NetworkPolicy 限制生产者和后端;
- Collector ServiceAccount 使用最小 RBAC;
- 后端凭据通过 Secret 注入;
- 对来自公网的 Trace Context 做校验或重建,避免信任任意外部上下文。
14. 初学者常见问题
OpenTelemetry 会存储数据吗?
不会。SDK 和 Collector 负责生成、收集、处理与导出,后端负责持久化和查询。
应用必须部署 Collector 吗?
协议上可以由 SDK 直接发送到后端。Kubernetes 生产环境通常保留 Collector,因为它能集中管理凭据、重试、过滤、采样、元数据和后端迁移。
自动埋点以后还要改代码吗?
自动埋点先覆盖 HTTP、RPC、数据库和消息组件。库存预留、风控检查等业务步骤仍需手工 Span,业务错误也需要明确设置状态和属性。
Kubernetes Metadata 会自动出现吗?
不会。应用可以通过 Downward API 写入 Pod UID,也可以由 Kubernetes Attributes Processor 根据连接或 UID 关联。Processor 还需要只读 RBAC。
三种信号必须一起迁移吗?
不需要。常见顺序是先接入 Trace,保留现有 Metric 和 Log 管道;字段规范和 Collector 稳定后再逐步统一。
为什么一个 HTTP 请求会出现多个 Span?
除了 Server Span,ASGI 等框架可能记录 send、receive 内部 Span,下游客户端也会创建 Client Span。先确认这些 Span 是否提供排障价值,再通过自动埋点配置过滤,不要直接在后端按名称盲目删除。
15. 推荐学习顺序
- 用本篇五分钟实验看懂 Receiver、Processor、Exporter 和 Pipeline;
- 给一个非核心服务开启 HTTP 自动埋点;
- 检查
traceparent能否跨两个服务传播; - 增加一个有业务意义的手工 Span;
- 为日志补充 Trace ID 和 Span ID;
- 接入真正的 Trace 后端,验证错误和慢请求;
- 再学习采样、Agent + Gateway、高可用和容量规划;
- 最后统一全公司的 Resource、Semantic Conventions 和隐私规则。