OpenTelemetry 在 Kubernetes 的应用与实战:从 OTLP 到 Prometheus、Langfuse 与日志管道
Kubernetes 已经有 Prometheus、Grafana、Loki、Elasticsearch、Tempo、Jaeger 和各种 APM,为什么还要引入 OpenTelemetry?
原因不是再增加一个监控后端,而是把应用怎样产生遥测、遥测怎样传输、平台怎样统一加工这三件事从具体厂商中抽出来。应用统一发送 OTLP,平台在 Collector 中补充 Kubernetes 元数据、清理敏感字段、控制基数、采样和路由,后端继续负责各自擅长的存储与查询。
本文先解释 OpenTelemetry 在 Kubernetes 中的位置,再用一套可复现的实验跑通以下链路:
FastAPI 两副本应用
  ├─ OTLP Trace  ─┐
  └─ OTLP Metric ─┼─> OpenTelemetry Collector Gateway
                  ├─ Trace  -> Langfuse
                  ├─ Metric -> Prometheus Exporter -> Prometheus / Grafana
                  └─ Log    -> Debug(生产替换为 Loki / Elasticsearch)
本次执行 20 个正常请求、1 个慢请求和 1 个预期错误请求。最终在 Langfuse 查到 22 条业务 Trace、87 个有效 Span,Prometheus 中三类请求计数分别为 20 / 1 / 1,Collector 的 ServiceMonitor Target 为 Up;健康探针产生的 Trace 已从管道中排除。这个流量用于验证遥测完整性,不是应用性能基准。
完整代码和 Kubernetes 清单见 examples/opentelemetry-kubernetes-practice,脱敏后的结果数据见 results.json。
1. OpenTelemetry 解决什么问题
OpenTelemetry 主要提供四层能力:
| 层次 | 作用 | 本文对应内容 |
|---|---|---|
| API 与 SDK | 在应用中创建 Span、Metric 和 Log,并传播上下文 | Python SDK、FastAPI 自动埋点和三个业务 Span |
| Semantic Conventions | 约定 service.name、HTTP、数据库、GenAI 等字段语义 |
统一服务与 Kubernetes 资源属性 |
| OTLP | 用统一协议传输 Trace、Metric 和 Log | 应用通过 OTLP/HTTP 发送到 Collector |
| Collector | 接收、处理、过滤、采样、批量和导出 | Gateway Deployment 分流到 Langfuse 与 Prometheus |
它不负责替代所有后端:
- Prometheus 仍负责指标时序、PromQL 和告警;
- Grafana 仍负责看板;
- Tempo、Jaeger 或 APM 负责通用分布式 Trace;
- Loki、Elasticsearch 等负责日志存储与检索;
- Langfuse 负责 LLM/Agent Trace、Token、成本、Prompt 与评估语义。
应用只面对一套遥测标准,后端选型和迁移由平台侧完成,这是 OpenTelemetry 对 Kubernetes 平台最直接的价值。
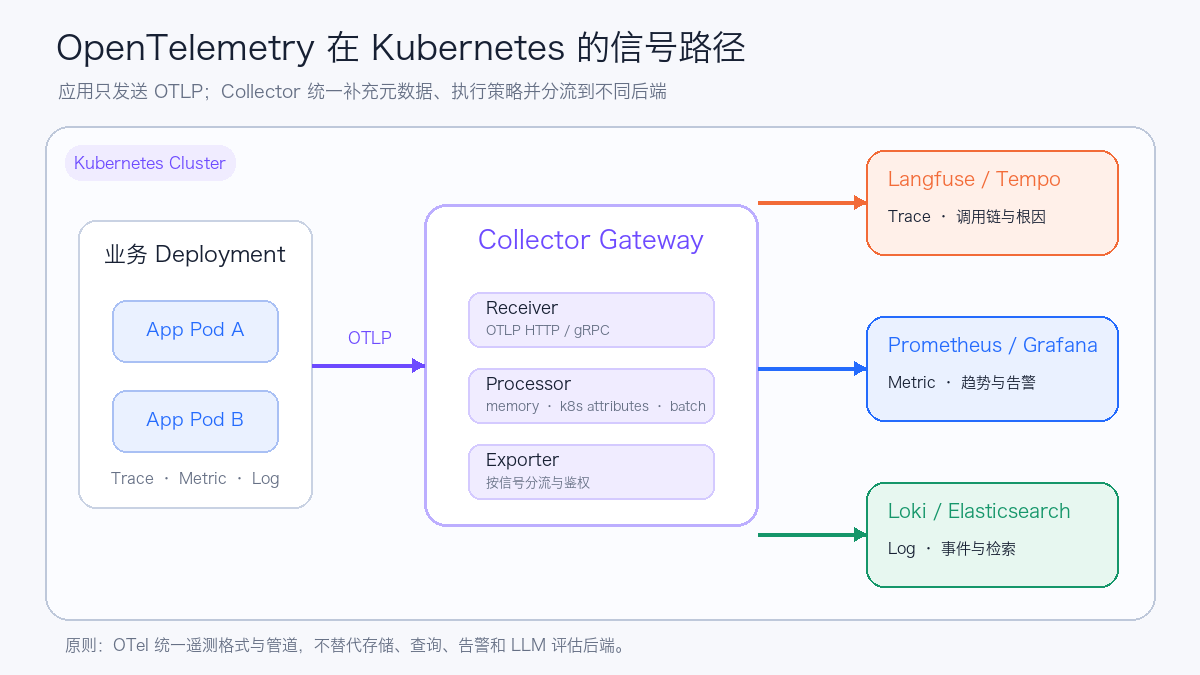
2. Collector 的流水线模型
Collector 配置由四类组件组成:
receivers:   # 数据从哪里进入
processors:  # 怎样加工、限流、补充属性和批量
exporters:   # 发往哪些后端
extensions:  # 健康检查、鉴权等非数据流水线能力
只有把组件写入 service.pipelines,它才真正参与运行:
service:
  extensions: [health_check, basicauth/langfuse]
  pipelines:
    traces:
      receivers: [otlp]
      processors: [memory_limiter, k8s_attributes, resource/common, batch]
      exporters: [debug, otlp_http/langfuse]
    metrics:
      receivers: [otlp]
      processors: [memory_limiter, k8s_attributes, resource/common, batch]
      exporters: [prometheus]
    logs:
      receivers: [otlp]
      processors: [memory_limiter, k8s_attributes, resource/common, batch]
      exporters: [debug]
这里的顺序有实际意义。memory_limiter 应尽早拒绝超出内存预算的数据,避免 Collector 被突发流量拖垮;k8s_attributes 为数据补充 Pod、Namespace、Deployment 和 Node;batch 再合并导出请求,减少后端连接开销。
实验使用 Collector Contrib 0.160.0。该版本已将部分历史组件别名规范化,例如配置中使用 k8s_attributes 和 otlp_http;升级 Collector 时要在预发布环境运行实际配置,不能只看 YAML 语法是否通过。
3. Sidecar、DaemonSet 和 Gateway
Collector 没有一种部署形态适合所有信号。
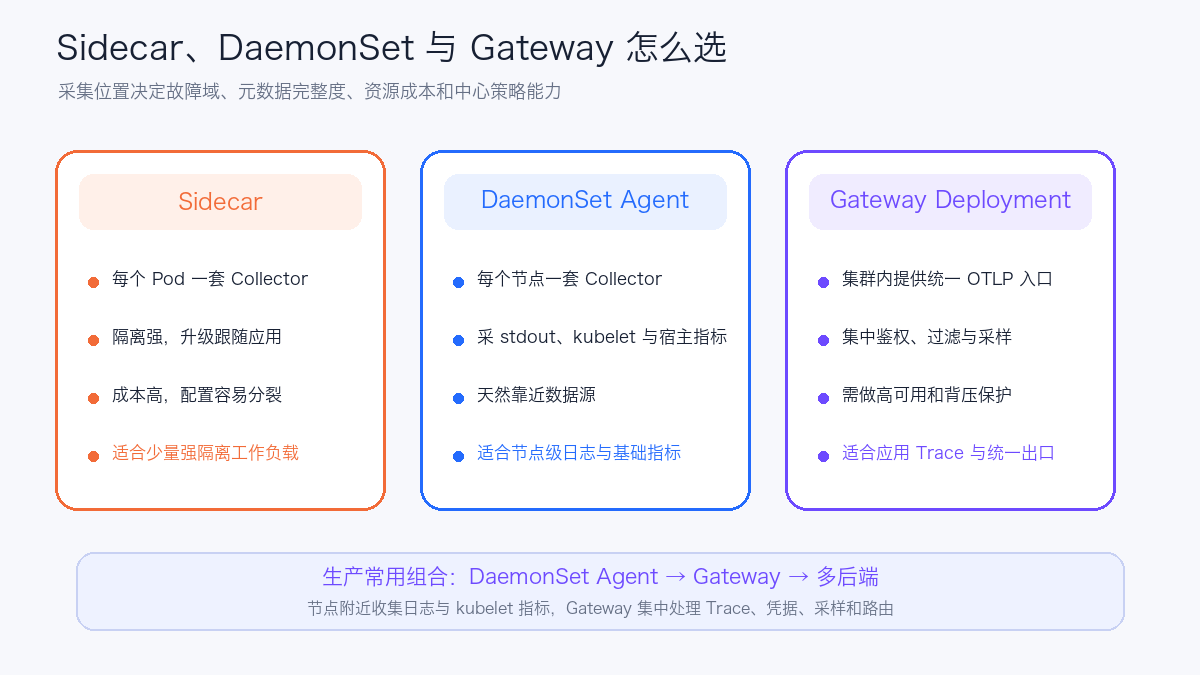
3.1 Sidecar
每个业务 Pod 带一个 Collector。它能实现强隔离和独立配置,但会显著增加 Pod 数、CPU、内存和升级成本。只有少量租户需要独立凭据、独立故障域或特殊处理逻辑时,才值得使用。
3.2 DaemonSet Agent
每个节点运行一个 Collector,适合读取容器 stdout 文件、Kubelet Stats 和宿主机指标。日志文件在节点本地,DaemonSet 能以较短路径读取;应用也可以把 OTLP 发往本节点 Agent。
3.3 Gateway Deployment
Collector 以 Deployment 提供统一 OTLP Service,应用只配置一个集群内地址。鉴权、过滤、采样、路由和后端凭据集中管理,适合应用 Trace 与统一出口。本文实验采用这种结构。
生产环境常见的组合是:
DaemonSet Agent
  ├─ filelog / kubeletstats / hostmetrics
  └─ OTLP from local workloads
        ↓
Gateway Deployment
  ├─ central policy / sampling / routing
  └─ credentials and multi-backend export
涉及 Tail Sampling 时,属于同一 Trace 的 Span 必须稳定到达同一组有状态 Collector;简单地在多个 Gateway 副本之间随机分散 Span,会让采样器看不到完整 Trace。OpenTelemetry 官方建议在需要特定 Collector 状态时使用按 Trace ID 或服务名感知的两层路由。
4. 实验环境与边界
本次环境已经有 Prometheus Operator、Prometheus、Grafana 和自托管 Langfuse,没有安装 OpenTelemetry Operator,因此使用原生 Deployment、Service 和 ServiceMonitor:
| 项目 | 实验配置 |
|---|---|
| Kubernetes | Server v1.30.4 |
| Collector | otel/opentelemetry-collector-contrib:0.160.0 |
| 应用 | FastAPI,两副本 |
| OTLP | 应用到 Collector 同时启用 HTTP 4318 与 gRPC 4317,示例应用使用 HTTP |
| Trace 后端 | 自托管 Langfuse,通过 OTLP/HTTP |
| Metric 后端 | Collector Prometheus Exporter + ServiceMonitor |
| Log 后端 | 本次仅用 Debug Exporter 验证管道,未声称完成日志持久化 |
清单不会创建 Prometheus、Grafana 或 Langfuse。部署前需要确认目标集群已经有相应后端,并调整 ServiceMonitor 标签和 Langfuse Service 地址。
5. 应用埋点:自动 Span 与业务 Span 配合
示例应用同时使用 FastAPI 自动埋点和手工业务 Span:
FastAPIInstrumentor.instrument_app(
    app,
    tracer_provider=trace_provider,
    meter_provider=meter_provider,
    excluded_urls="/healthz",
    exclude_spans=["send", "receive"],
)

with tracer.start_as_current_span("validate-order") as span:
    span.set_attribute("demo.mode", mode)

with tracer.start_as_current_span("inventory-call") as span:
    span.set_attribute("peer.service", "inventory")

with tracer.start_as_current_span("format-response"):
    ...
一条普通请求形成以下结构:
错误请求在 inventory-call 抛出异常,因此没有 format-response,最终为三个 Span。根 Span 必须保留:Trace 后端需要它建立完整链路,过滤器若只留下子 Span,页面可能出现孤立 Observation。
指标也由同一个 SDK 发出:
request_counter = meter.create_counter("demo.requests")
latency_histogram = meter.create_histogram(
    "demo.request.duration",
    unit="ms",
)

request_counter.add(1, {"demo.mode": mode, "demo.result": result})
latency_histogram.record(duration_ms, {"demo.mode": mode, "demo.result": result})
demo.mode 和 demo.result 只有少量固定值,适合作为 Prometheus Label。Trace ID、Prompt、用户 ID、异常堆栈和任意请求参数都不应直接成为 Metric Label,否则会造成高基数与敏感信息泄露。
6. Kubernetes 元数据关联
应用通过 Downward API 把 Pod UID 写入 OTel Resource:
Resource.create({
    "service.name": "checkout-demo",
    "service.version": "1.0.0",
    "deployment.environment.name": "lab",
    "k8s.pod.uid": os.getenv("K8S_POD_UID"),
})
Collector 再按 UID 或连接来源匹配 Pod,并提取受控字段:
k8s_attributes:
  auth_type: serviceAccount
  pod_association:
    - sources:
        - from: resource_attribute
          name: k8s.pod.uid
    - sources:
        - from: connection
  extract:
    metadata:
      - k8s.namespace.name
      - k8s.deployment.name
      - k8s.pod.name
      - k8s.pod.uid
      - k8s.node.name
只依赖连接 IP 在代理、NAT 或多层 Collector 场景中可能关联错误;显式携带 Pod UID 更稳定。Collector 的 ServiceAccount 只需要读取 Pod、Namespace、Node 和相关 Workload 元数据,不能因为“方便”授予集群管理员权限。
7. Trace 导出到 Langfuse
Langfuse 的 OpenTelemetry 入口接收 Trace,地址为 /api/public/otel,当前支持 OTLP/HTTP JSON 或 Protobuf,不支持 OTLP/gRPC。Collector 使用 Basic Auth,并为 Langfuse v4 实时入库增加版本 Header:
extensions:
  basicauth/langfuse:
    client_auth:
      username: ${env:LANGFUSE_PUBLIC_KEY}
      password: ${env:LANGFUSE_SECRET_KEY}

exporters:
  otlp_http/langfuse:
    endpoint: ${env:LANGFUSE_OTLP_ENDPOINT}
    headers:
      x-langfuse-ingestion-version: "4"
    auth:
      authenticator: basicauth/langfuse
密钥来自 Kubernetes Secret,不能写进 ConfigMap、文章、镜像或 Git。使用 Langfuse v3 自托管时,OTel 入口至少需要 v3.22.0;版本更老会返回 4xx。
通用业务 Trace 可以进入 Tempo 或 Jaeger;LLM/Agent 场景如果还需要模型、Token、成本、Prompt 版本和评估,应补充 GenAI Semantic Conventions 或 langfuse.* 属性。只把普通 HTTP Span 发进 Langfuse,能看到调用链,却不会凭空得到 Token 成本。
8. Metric 进入 Prometheus
本文选择 Collector 的 Prometheus Exporter 在 8889 暴露指标,再让 Prometheus 通过 ServiceMonitor 拉取:
apiVersion: monitoring.coreos.com/v1
kind: ServiceMonitor
metadata:
  name: otel-practice
spec:
  selector:
    matchLabels:
      app: otel-collector
  endpoints:
    - port: metrics
      interval: 15s
Prometheus 也能直接接收 OTLP/HTTP Metric,但接收器默认关闭,需要显式启用 --web.enable-otlp-receiver。已有 Prometheus Operator 的集群继续使用 pull 模式,能保留 Target、up 和服务发现的运维语义,迁移成本通常更低。
PromQL 示例:
# 每种结果的请求速率
sum by (demo_mode, demo_result) (
  rate(otel_demo_demo_requests_total[5m])
)

# 每种模式的平均延迟
sum by (demo_mode) (
  rate(otel_demo_demo_request_duration_milliseconds_sum[5m])
)
/
sum by (demo_mode) (
  rate(otel_demo_demo_request_duration_milliseconds_count[5m])
)

# P95 延迟
histogram_quantile(
  0.95,
  sum by (le, demo_mode) (
    rate(otel_demo_demo_request_duration_milliseconds_bucket[5m])
  )
)
仓库同时提供可导入的 grafana-dashboard.json,包含 Collector Target、请求速率、平均延迟和 P95 四个面板。导入时选择实际 Prometheus 数据源即可。
生产看板应使用 rate() 或 increase() 观察窗口增量。直接累加累计 Counter 时,滚动更新后旧 service.instance.id 的时序可能仍处于 Prometheus 回看窗口,短时间内会把新旧实例一起相加。
9. 部署和验证
构建并推送示例应用镜像:
cd examples/opentelemetry-kubernetes-practice
docker build -t <REGISTRY>/otel-k8s-demo:v1 app
docker push <REGISTRY>/otel-k8s-demo:v1
把 k8s/app.yaml 中的 REPLACE_WITH_IMAGE 替换为实际镜像,创建 Langfuse 凭据:
kubectl apply -f k8s/namespace.yaml
kubectl -n otel-practice create secret generic langfuse-credentials \
  --from-literal=public-key='<PUBLIC_KEY>' \
  --from-literal=secret-key='<SECRET_KEY>'
调整 LANGFUSE_OTLP_ENDPOINT 和 ServiceMonitor 标签后部署:
kubectl apply -f k8s/collector.yaml
kubectl apply -f k8s/app.yaml

kubectl -n otel-practice rollout status deploy/otel-collector
kubectl -n otel-practice rollout status deploy/checkout-demo
kubectl create -f k8s/load-job.yaml
验收不能停在 Pod Running。至少核对四层证据:
# 1. 应用确实产生正常、慢和错误请求
kubectl -n otel-practice logs -l app=checkout-demo

# 2. Collector 收到并导出 Span,且无持续 exporter error
kubectl -n otel-practice logs deploy/otel-collector

# 3. Prometheus Target 为 Up,Metric 能查询
sum by (demo_mode, demo_result) (otel_demo_demo_requests_total)

# 4. Trace 后端能查到根 Trace 和子 Span
# 在 Langfuse 中筛选 GET /work,并核对 slow/error 链路
HTTP 请求返回 200 只证明业务入口工作,不证明 Collector 已接收、后端已入库,也不证明 Metric 标签和 Trace 父子关系正确。
10. 实测结果
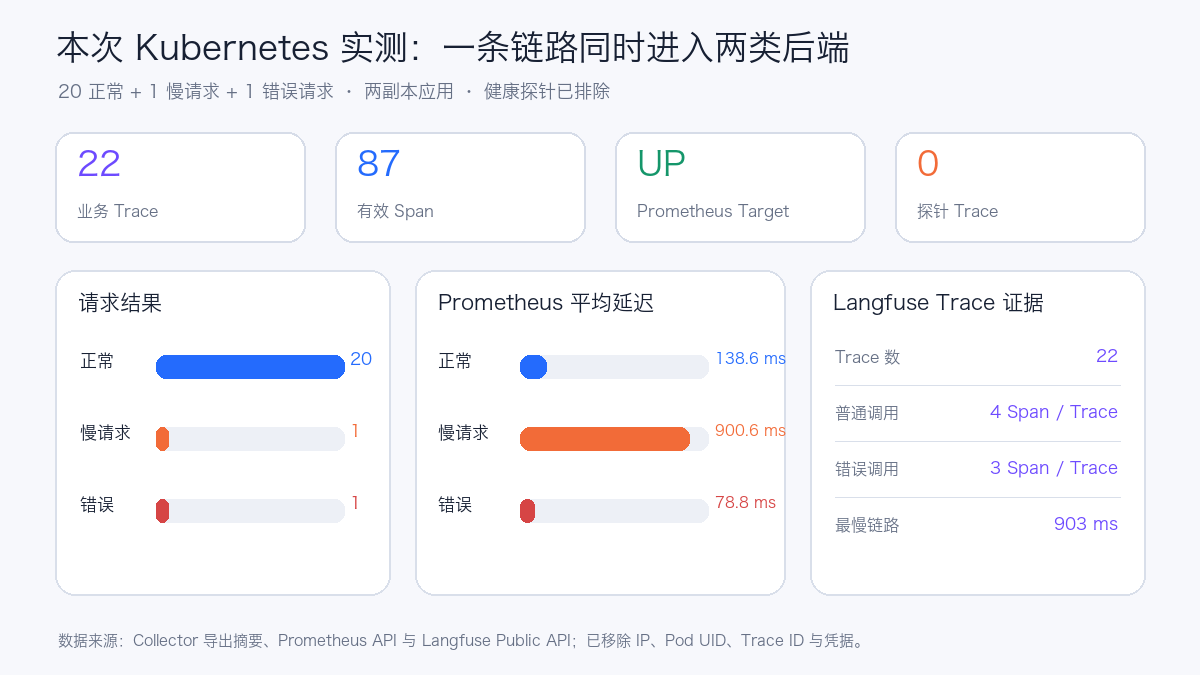
| 证据 | 实测结果 | 能证明什么 |
|---|---|---|
| 业务请求 | 正常 20、慢 1、错误 1 | 三种已知路径确实执行 |
| Collector Span | 87 | 22 个根调用及其业务子 Span 完整进入 Collector |
| Langfuse Trace | 22 | 每个业务请求都能在 Trace 后端找到 |
| 普通 Trace | 4 Span / Trace | 根 Span 和三个业务 Span 的父子结构完整 |
| 错误 Trace | 3 Span / Trace | 异常发生后没有虚构未执行的格式化步骤 |
| Langfuse 延迟范围 | 80—903 ms | 注入的慢请求在 Trace 端明显可见 |
| Prometheus 平均延迟 | 正常 138.55 ms、慢 900.65 ms、错误 78.80 ms | Metric 与预设请求模式一致 |
| ServiceMonitor | up = 1 |
Prometheus 正在抓取 Collector 暴露的指标 |
| 健康探针 Trace | 0 | 探针噪声已排除 |
慢请求和错误请求各只有一个样本,对应的 P95 只用于证明 Histogram 管道可用,不能解释服务的尾延迟水平。要做性能结论,需要固定请求分布、持续时间、并发、预热、样本量和后端采样规则。
11. 实验中遇到的三个问题
11.1 健康探针制造大量 Trace
两个应用副本每十秒执行一次 liveness 和 readiness。FastAPI 自动埋点最初把 /healthz 也记录下来,一次简单请求还会产生 ASGI send/receive 内部 Span,业务流量很快被探针淹没。
最终同时做两项处理:
修正后等待两个探针周期,Collector 没有新增 Trace;再运行 22 个业务请求,得到 87 个 Span,与 21 × 4 + 1 × 3 完全一致。
11.2 Collector 升级后组件别名告警
旧配置使用历史别名时,Collector 0.160.0 会给出弃用提示。改为当前组件标识并重新启动后告警消失。Collector 版本、发行版和配置应作为一组锁定;升级流水线应先执行配置加载和最小 OTLP 冒烟。
11.3 滚动更新后的累计 Metric 看起来翻倍
应用 SDK 发出累计 Counter,Collector Prometheus Exporter 以 service.instance.id 区分不同 Pod。实验重启过程中,如果直接对原始 Counter 求和,旧实例和新实例可能在 Prometheus 五分钟回看窗口内同时出现。
看板使用 rate()/increase();排障时保留 service.instance.id、Pod 和 Target 维度;需要严格单批次实验时,应等旧应用 Pod 完全退出,再重启 Collector 清除接收状态,最后发流量。这个现象也说明 Metric 数据流必须满足 Single Writer 原则,多个 Collector 不应并发改写同一资源身份的同一数据流。
12. AI Agent 接入时,三种系统不能一概而论
OpenTelemetry 能统一传输,但不同 Agent 已经暴露的信号不同:
| 系统 | 已有能力 | 推荐接法 | 需要补充什么 |
|---|---|---|---|
| OpenClaw | 原生 OTel Trace、Metric、Log,可配置 OTLP/HTTP | Trace 先到 Collector,再到 Langfuse/Tempo;Metric 到 Prometheus,Log 到 Loki | 默认关闭内容采集;只有原生 Span 层级不足时再用模型/Agent Hook 补 Span |
| DeepSeek Harness | 官方 Session Telemetry 主要是 OTLP Log,包含会话事件 | Log 进入 Collector 日志管道;用 Cordis 插件或适配器生成 Langfuse Trace | 不能把 /v1/logs 直接指向 Langfuse Trace 入口;会话内容需严格脱敏 |
| Hermes Agent | 有 LLM、API、Tool、Session 生命周期 Hook | 写轻量 Python 插件,在 Hook 中创建 Trace、Generation 和 Tool Span | 异步批量导出、超时失败开放、按 turn/session ID 维护父子关系 |
如果只在统一模型网关记录请求,可以得到模型耗时和 Token,却看不到 Agent 规划、工具执行、重试和会话状态。需要评估 Agent 行为时,埋点位置必须进入 Agent Runtime。
13. 生产配置建议
13.1 容量、背压和失败恢复
memory_limiter放在处理链前部,并让容器内存 Limit 高于其上限;- 为远端 Exporter 配置有界发送队列、重试和超时,明确队列满时丢弃策略;
- 要跨 Collector 重启保留队列时,评估 File Storage Extension 和持久卷;
- 监控 Collector 自身的 accepted、refused、sent、failed、queue size、CPU、内存和 GC;
- 不要在生产长期启用高详细度 Debug Exporter。
13.2 高可用不等于所有组件随便多副本
- 无状态 OTLP Gateway 可以多副本并由 Service 负载均衡;
- Tail Sampling、Span-to-Metrics 和累计到增量转换具有状态,需要一致性路由或明确分片;
- Kubernetes Cluster Receiver 通常只能有一个活跃实例,否则会重复采集集群级指标;
- Prometheus Receiver 按相同配置启动多个副本会重复抓取,规模化时使用 Target Allocator 或显式分片;
- Metric 必须为每条数据流保持唯一资源身份和 Single Writer。
13.3 安全与隐私
- OTLP Service 只在受控网络暴露,跨边界启用 TLS/mTLS 和认证;
- 用 NetworkPolicy 限制哪些 Namespace 能发送数据以及 Collector 能访问哪些后端;
- 凭据只从 Secret 注入,Collector 配置与日志中禁止打印密钥;
- Prompt、响应、Tool 参数、Cookie、Authorization 和用户身份默认不采集;
- 在 Collector 中建立字段允许列表和脱敏规则,再把数据发往外部 SaaS;
- Prometheus Label 禁止使用 Trace ID、原始用户 ID、Prompt 或任意 URL 参数。
13.4 采样策略
- Head Sampling 成本低,但在请求开始时还不知道最终是否错误或慢;
- Tail Sampling 能优先保留错误、慢请求和关键租户,需要缓存完整 Trace,内存和路由复杂度更高;
- 采样规则必须记录版本,并验证根 Span、错误 Span 和关键属性不会被过滤;
- LLM/Agent 场景可按错误、延迟、模型、成本或评估分数组合保留,但不要把敏感正文作为采样标签。
13.5 发布门禁
每次 Collector 或 SDK 升级至少验证:
- 固定版本镜像能加载实际配置;
- 正常、慢、错误三类 Fixture 都能产生预期 Trace;
- 根 Span 与子 Span 数量、父子关系正确;
- Prometheus Target 为 Up,Counter 和 Histogram 可查询;
- 后端凭据错误时有明确 exporter failure,而不是静默丢失;
- 健康探针、静态资源和高频低价值请求已降噪;
- 断开后端后队列、内存和丢弃量符合预算;
- 公开材料不包含内网地址、Pod UID、Trace ID、Prompt 和密钥。
14. 清理实验
kubectl delete namespace otel-practice
kubectl delete clusterrolebinding otel-practice-collector
kubectl delete clusterrole otel-practice-collector
ClusterRole 和 ClusterRoleBinding 是集群级资源,删除 Namespace 不会自动删除它们。生产安装应通过 Helm、Operator 或 GitOps 统一管理生命周期。