GLM-5.3 首日实测:8×H20 上的 SGLang 与 vLLM 基线压测
2026-08-30,我在同一台 8×141GB NVIDIA H20-3e 节点上,用 SGLang 和 vLLM
分别部署 GLM-5.3 原生 FP8 权重,完成了 9 个 Target-only 基线 Case。两个引擎都由
同一个 vllm bench serve 客户端压测,每个 Case 跑 3 轮,本文使用三轮中位数。
GLM-5.3 是约 743B 总参数、39B 激活参数的 MoE 文本模型,使用 DSA、256 个路由专家
(每 Token 激活 8 个)、一层原生 MTP,并声明 1,048,576 Token 上下文。默认
zai-org/GLM-5.3 是原生 FP8 Checkpoint;BF16 权重位于独立仓库。
先说结论
- 两套引擎各留下 27 份完整结果,共 54 份 JSON、7,680 个完成请求,失败请求为 0;
- SGLang 在 9 个 Case 的输出吞吐都更高,相对 vLLM 高 7.3%~57.4%;
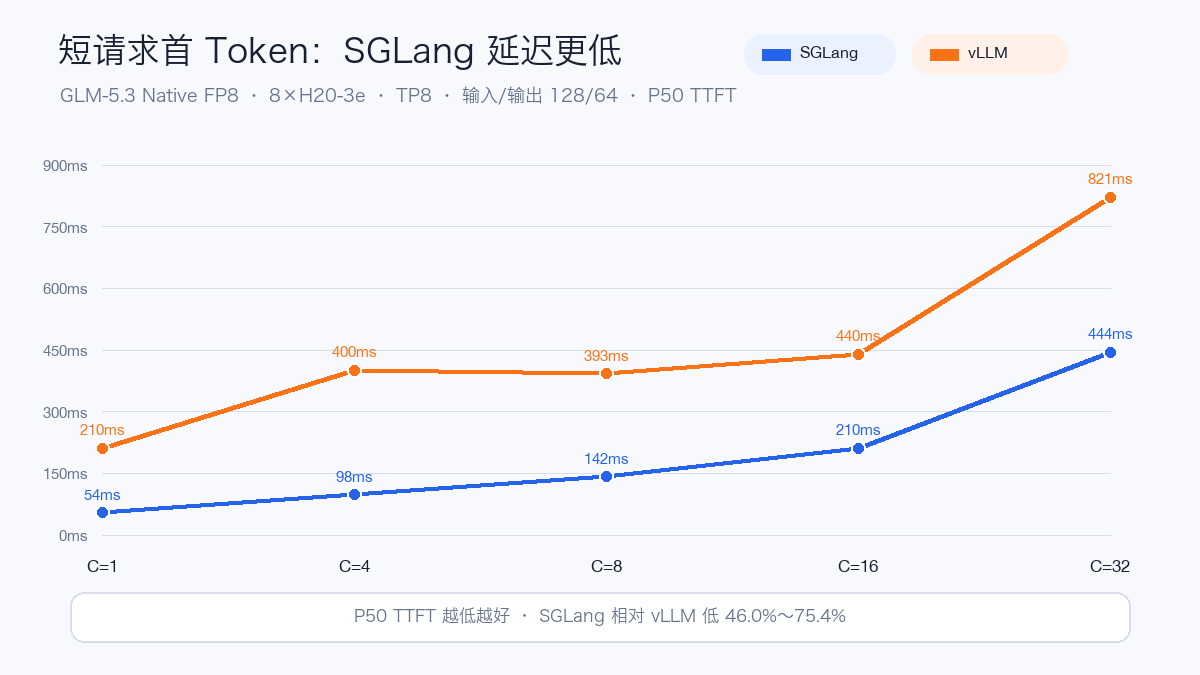
- 128/64 短请求中,SGLang 的 P50 TTFT 低 46.0%~75.4%;
- 4K/16K Prefill 中,vLLM 的 P50 TTFT 更低,但 SGLang 的输出吞吐和 P50 E2E 更好;
- 这组结果只代表关闭 MTP、Prefix Cache、HiCache 和 Context Parallelism 的 128K Target-only 基线,不代表开启各自最佳优化后的最终排名。
测试环境与口径
| 项目 | 配置 |
|---|---|
| 模型 | zai-org/GLM-5.3,Native FP8,141 个 Safetensors 分片 |
| GPU | 单节点 8×NVIDIA H20-3e,单卡 141GB,TP8 |
| Context | 131,072 Token |
| SGLang | 固定 linux/amd64 镜像 Digest sha256:bde16a…fd74bf;归档的版本文件为空,因此不声明语义版本 |
| vLLM | 0.28.0,固定 linux/amd64 镜像 Digest sha256:2286e8…b06635 |
| KV Cache | SGLang 使用 Hopper 默认 BF16;vLLM 使用 auto |
| 优化开关 | MTP、Prefix Cache、HiCache、Context Parallelism 全部关闭 |
| 客户端 | 两边统一使用 vllm bench serve、相同随机请求集合与参数 |
| 统计 | 每个 Case 3 轮,表格取逐指标中位数;不摘最快一轮 |
基线压测结果
吞吐是 Output Token Throughput。TTFT 差值按
(SGLang / vLLM - 1) × 100% 计算,负数代表 SGLang 首 Token 更快。
| Case | SGLang 输出 tok/s | vLLM 输出 tok/s | 吞吐差值 | SGLang P50 TTFT | vLLM P50 TTFT | TTFT 差值 |
|---|---|---|---|---|---|---|
| 128/64,C1 | 90.41 | 69.27 | +30.5% | 54.29ms | 210.45ms | -74.2% |
| 128/64,C4 | 288.50 | 183.33 | +57.4% | 98.30ms | 400.31ms | -75.4% |
| 128/64,C8 | 459.47 | 330.82 | +38.9% | 142.10ms | 392.56ms | -63.8% |
| 128/64,C16 | 656.41 | 601.02 | +9.2% | 210.48ms | 439.92ms | -52.2% |
| 128/64,C32 | 964.25 | 814.68 | +18.4% | 443.91ms | 821.37ms | -46.0% |
| 4K/128,C4 | 100.07 | 93.31 | +7.3% | 3,446.90ms | 2,752.07ms | +25.2% |
| 4K/128,C8 | 115.40 | 103.63 | +11.4% | 5,913.69ms | 1,902.32ms | +210.9% |
| 16K/256,C4 | 53.57 | 49.76 | +7.6% | 12,429.06ms | 10,464.75ms | +18.8% |
| 16K/256,C8 | 57.67 | 53.24 | +8.3% | 20,281.42ms | 12,540.84ms | +61.7% |
短请求:SGLang 同时赢吞吐和首 Token
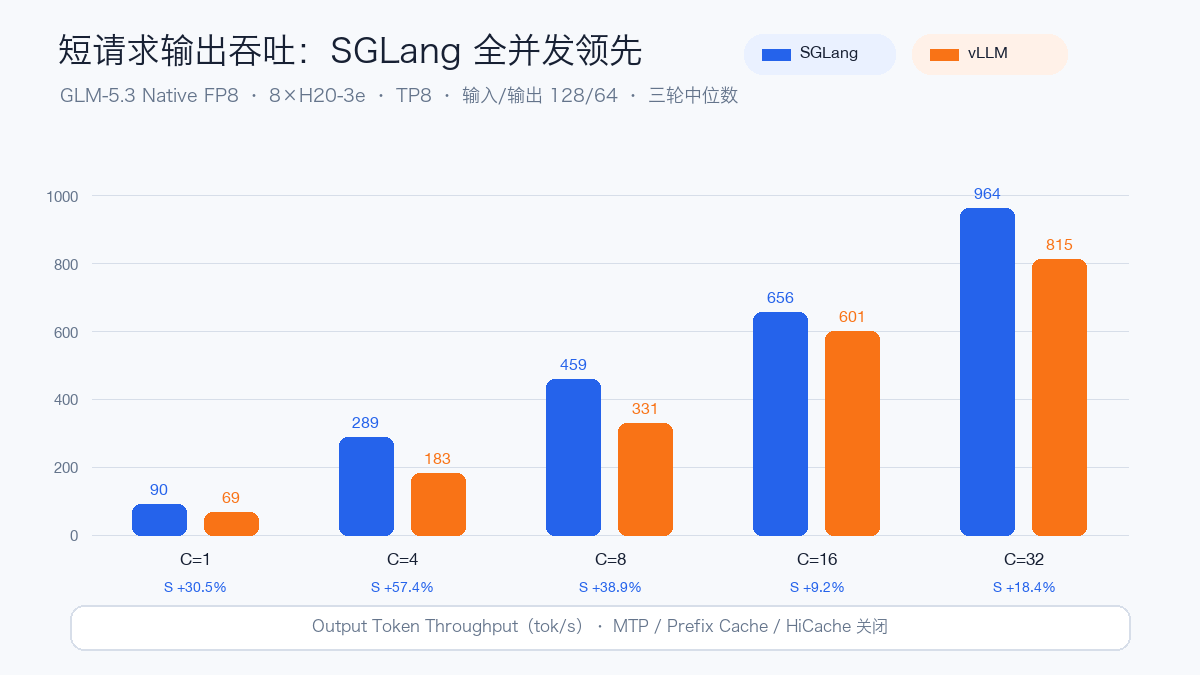
在 128/64 Case 中,SGLang 从 C1 到 C32 都保持更高吞吐和更低 TTFT。C32 时输出吞吐 达到 964.25 tok/s,vLLM 为 814.68 tok/s;P50 TTFT 则分别为 443.91ms 和 821.37ms。对于聊天和短 Agent 调用,这组配置下 SGLang 的优势最明确。
4K/16K Prefill:vLLM 更早出首 Token,SGLang 更早完成
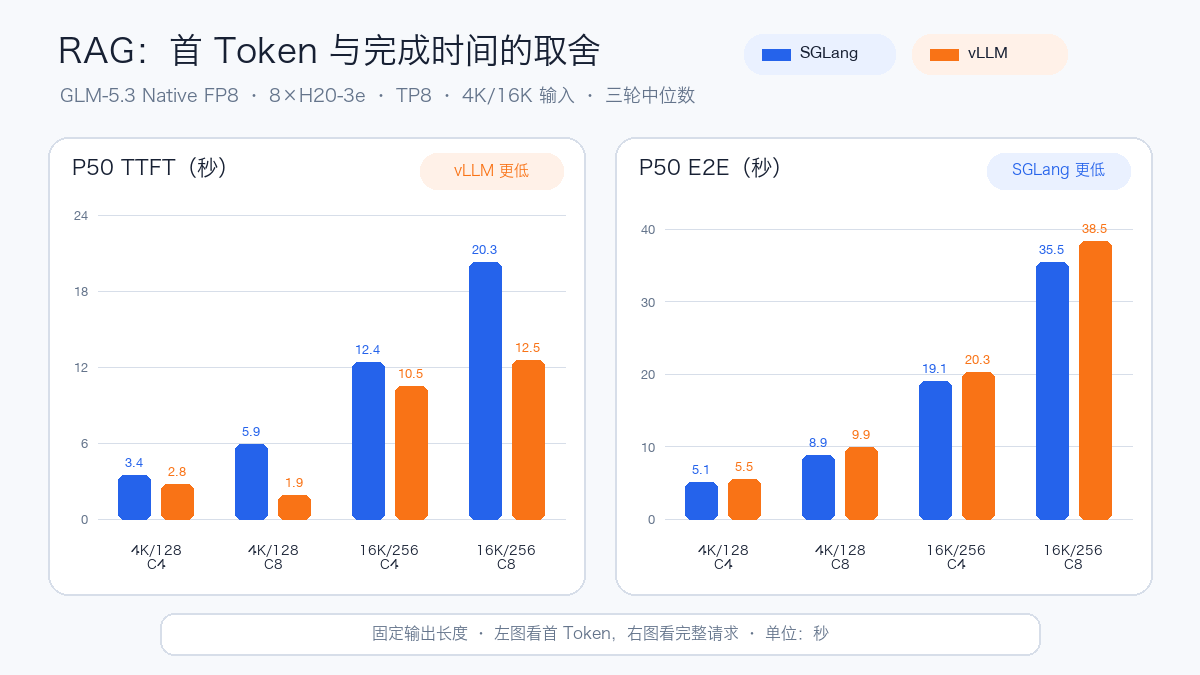
进入 4K 和 16K 输入后,vLLM 的 P50 TTFT 更低,尤其 4K/C8 是 1.90s 对 5.91s。 但在固定输出长度下,SGLang 的 Decode 更快,四个 RAG Case 的 P50 E2E 仍比 vLLM 低约 6.2%~10.6%。因此,首 Token 敏感的 RAG 交互与总完成时间/吞吐优先的批处理, 可能得到不同的引擎选择。
数据质量与结论边界
- 54 份结果文件均可解析,所有 Case 都是 3 轮,
failed=0,错误字符串为空; - SGLang 的
short-128-64-c4第三轮与一个 OpenWebUI 请求重叠,吞吐低于另外两轮; 本文仍按预先约定取三轮中位数,前两轮分别为 288.93 和 288.50 tok/s; - SGLang 批处理首次执行中断,随后从剩余 Case 恢复;聚合只纳入写出完整 JSON 的 27 轮,不纳入未完成轮次;
- 两套服务均完成
/v1/models、流式/非流式 Chat Completion、三档 Reasoning、 Tool Call、多轮对话和错误输入验收,并在测试期间接入 OpenWebUI;功能响应仅保留在 内部审计归档中,不以单次 Smoke 代替生产稳定性结论; - 压测完成后两个工作负载均已缩容到 0,8 张 H20 已释放;OpenWebUI 连接配置保留, 后续扩容可复用;
- MTP、FP8 KV、Prefix Cache、32K~1M Needle、功耗和显存曲线尚未进入本次对比。
逐请求原始 JSON 含随机 Prompt 与生成文本,不直接公开。仓库提供脱敏后的 逐 Case 聚合 CSV, 保留吞吐、P50/P95/P99 TTFT、TPOT、E2E 和请求计数,方便复算本文表格。
官方支持边界
| 路线 | 官方资料当前给出的边界 | 本轮定位 |
|---|---|---|
| vLLM 0.28.0+ | Recipe 明确列出单节点 8×H20/H200 141GB 运行 FP8;完整 1M Context 指向 8×B200 | H20 主验证路线 |
SGLang latest/预发布版 |
Cookbook 已支持 GLM-5.3、DSA、MTP、Reasoning、Tool Call、HiCache 和 Context Parallelism;硬件矩阵写明 H200,但没有点名 H20 | Hopper 兼容性实测路线,Ready 前不写成官方 H20 验证 |
这与 Hy4-preview 的 MXFP8/SM100 限制不同。GLM-5.3 的默认 FP8 权重可以从单节点 8×141GB H20 起步,不需要先准备 BF16 双机方案。
复现材料
本轮实测使用单节点 8×H20、TP8、128K 服务窗口,关闭 MTP、Prefix Cache、HiCache 和 Context Parallelism。两个引擎串行复用同一节点,通过相同客户端和 Case 集合完成各 27 轮基线;逐项配置、样本数和统计口径见上文。
复现目录提供固定镜像、模型预检、功能验收及压测脚本,结果目录保留公开聚合数据。未完成的优化与长上下文实验不纳入本文结论。
公开产物
可执行材料放在 examples/glm53-day1/:镜像基线、Case 矩阵、权重预检、功能 Smoke、
Benchmark、Prefix Cache 和 Needle。results/ 提供脱敏聚合 CSV;包含随机 Prompt 和
生成文本的逐请求原始结果只保留在内部审计归档中。本文三张图由
scripts/generate_glm53_day1_assets.py 直接读取公开聚合 CSV 生成。
延伸阅读:GLM-5.3-Flash 的 4×H20 实测
本文测试的是约 743B 总参数、39B 激活参数的 GLM-5.3 文本模型,使用 8×H20、TP8 建立 128K Target-only 基线。此前还测试过更轻量的 GLM-5.3-Flash:约 320B 总参数、 18B 激活参数,使用 4×H20、TP4,原生支持多模态与 1M Context。
Flash 测试中,SGLang 和 vLLM 都完成了接近 1M Token 的冷 Prefill 与 Needle 检索; vLLM 在高并发和 1K Decode 上更快,SGLang 的 Reasoning、Tool Call、图片、Prefix Cache 和 OpenWebUI 功能闭环更完整。两套引擎都出现了首次新 Shape JIT 带来的尾延迟,因此 同样采用逐轮留档和三轮中位数,而不是只发布最快成绩。
完整结果见: 《GLM-5.3-Flash Day 1 实测:4×H20 部署、1M 上下文与 SGLang/vLLM 对照》。