Kube-apiserver 负载均衡实战:HTTP/2、TLS 终结与四层/七层选型
三个 kube-apiserver 前面放一个负载均衡器,控制面就算高可用了吗?在小集群里,这套结构通常足够;到了请求多、Watch 多、升级频繁的集群,常见现象却是三台 API Server 中一台 CPU 很高,另一台只有零星流量,刚恢复的实例甚至长时间接不到请求。
根因在于均衡单位与请求单位不一致。四层负载均衡器在 TCP 连接建立时选择后端;HTTP/2 又允许大量独立请求复用同一条连接。只要连接不断,后续请求就继续流向原来的 API Server。滚动升级、故障恢复和控制器批量重连会改变连接落点,倾斜随后被长连接固定下来。
我的选型原则是:
- 普通集群先用 L4 TCP + TLS Passthrough,把认证、授权和审计完整留给 kube-apiserver;
- 已经出现长连接倾斜时,先修正 readiness、优雅退出和连接轮换,再评估是否需要七层;
- 只有明确需要请求级均衡、按用户或资源路由、入口限流和多集群证书治理时,才引入专用 Kubernetes API Gateway;
- 七层网关需要处理比普通 Ingress 更完整的协议与身份语义。TLS 终结以后,它进入控制面的身份与审计边界,必须单独验证 Watch、exec、attach、port-forward 和写请求失败语义。
1. HTTP/2 为什么让请求“粘”在一台 API Server
HTTP/2 规范把每个请求/响应放在独立 Stream 中,一条 TCP 连接可以同时承载多个 Stream。这样减少了 TCP 和 TLS 握手,也避免为每个请求重新建连,是正常的性能优化。
问题出现在 L4 LB 的观察尺度:
客户端发起 TCP/TLS 连接
        ↓
L4 LB 选择 API Server 1
        ↓
HTTP/2 Stream 1、2、3……都留在这条连接上
        ↓
L4 LB 看不到每个 Stream,也不能把已有 Stream 移到 API Server 2
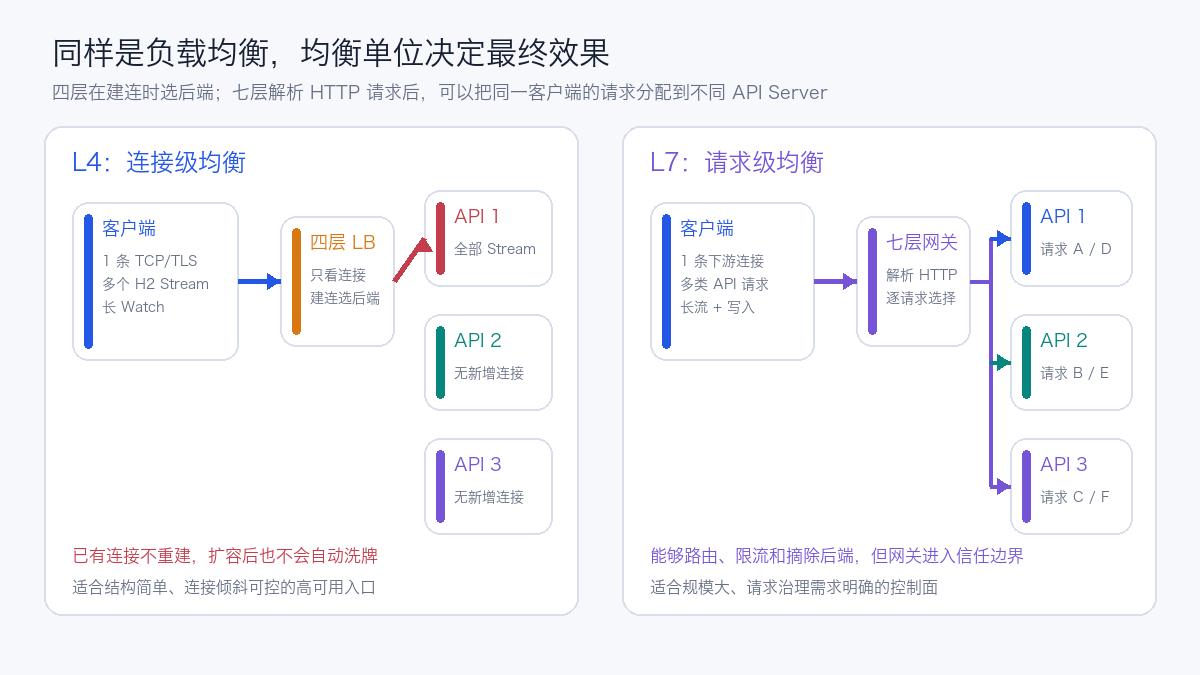
这里有三个容易误判的地方:
- 再加一个 L4 LB 不会迁移已有连接。 新入口只能影响后续建连,旧连接仍然绑定原后端。
- DNS 轮询也不等于请求均衡。 客户端可能缓存解析结果,并长期复用已经建立的连接。
- 请求数相同不代表压力相同。 一个大 LIST、一个慢 Watch 消费者和一个普通 GET 的 CPU、内存及返回字节数差别很大。
阿里的万节点实践记录过 API Server 升级后流量集中到单个实例的现象,并指出单纯增加 LB 不能解决问题,原因正是客户端尽量复用 TLS 连接;其改进同时涉及服务端保护、客户端重连和先扩后缩的发布策略。阿里万节点控制面实践
2. 四层与七层的真正区别
“四层更快、七层功能更多”只说到了表面。对于 Kubernetes API,真正的差异是负载均衡器能看见什么,以及它因此要承担什么责任。
| 维度 | L4 TCP + TLS Passthrough | L7 TLS Terminate + Re-encrypt |
|---|---|---|
| 均衡单位 | TCP 连接 | HTTP 请求;长 Watch 建立后仍是一条长期请求 |
| 可见信息 | 源/目的地址、端口、连接状态 | method、path、verb、resource、user 等,取决于实现 |
| 客户端身份 | 原始证书或 Token 直接交给 API Server | 网关先认证;上游需转发 Token 或使用受控 Impersonation |
| TLS | 客户端到 API Server 端到端加密 | 客户端到网关一段,网关到 API Server 再建立 mTLS |
| 健康检查 | 常见为 TCP/TLS 存活;可另做 authenticated /readyz |
可以按 /readyz 做应用级摘流 |
| 路由与限流 | 无法按 Kubernetes 请求属性区分 | 可按用户、verb、resource、namespace 等治理 |
| Watch 与升级连接 | 连接由客户端直达 API Server | 网关必须正确代理长流,并处理上下游连接生命周期 |
| exec/attach/port-forward | TCP 透传通常最简单 | 必须支持 Upgrade、WebSocket/SPDY 或连接劫持语义 |
| 故障面 | 小,容易旁路 | 网关、身份传递、连接池和规则都成为关键路径 |
如果一个产品配置成 TLS Passthrough,即使产品名称里写着“七层”,它对这段 Kubernetes API 流量仍只能按四层工作,因为加密后的 method、path 和用户信息不可见。
七层也不天然比四层均衡。它必须在每个请求到达时选择后端,并维护多个上游连接池;如果实现只是解密以后把整个下游连接固定到一个上游,仍然没有得到请求级均衡。
3. TLS 终结会迁移身份边界
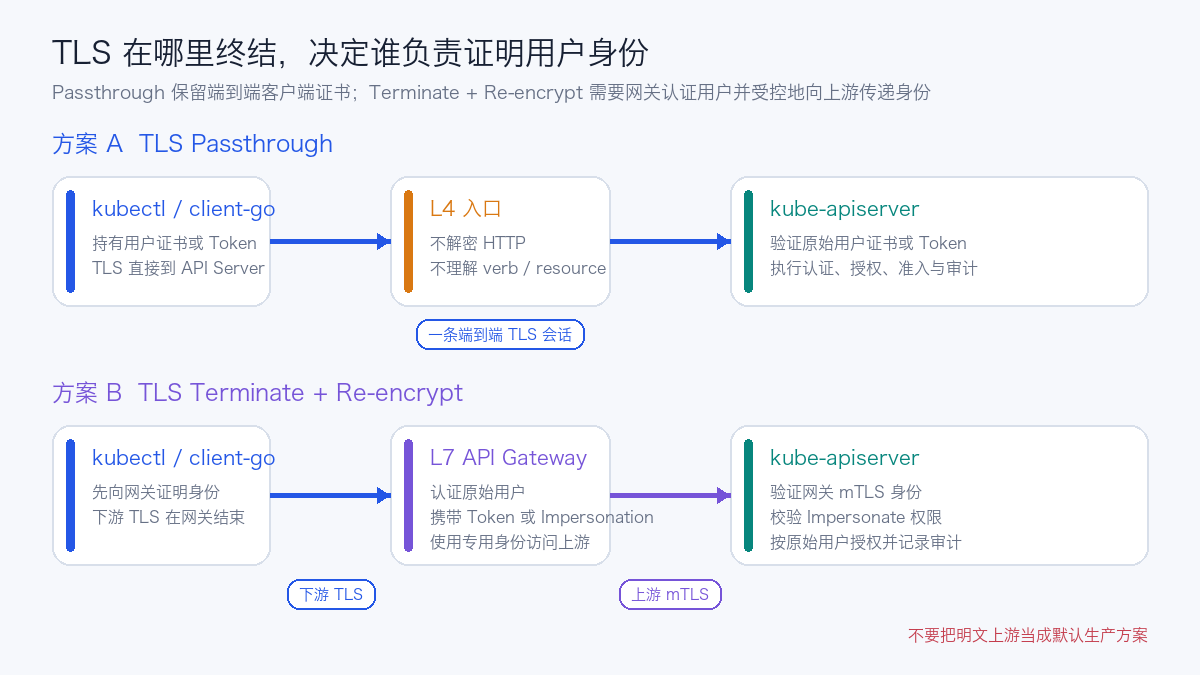
3.1 Passthrough:最小信任面的默认方案
在 L4 Passthrough 中,负载均衡器不解密流量。客户端证书、Bearer Token、认证错误和审计身份都由 kube-apiserver 原样处理。证书私钥不必放在 LB 上,LB 也不能伪造 Kubernetes 用户。
它的限制同样明确:入口无法按 API 属性路由,通常只能看到连接数和字节数;TCP 探测成功也只能证明 6443 在监听,不能证明 watch cache 已经初始化或者 etcd 可用。
因此即使数据面走 L4,我也会增加一条独立的、受认证保护的 /readyz 主动探测。Kubernetes 官方说明,/livez 用来判断进程是否需要重启,/readyz 用来判断实例是否能够接收流量;API Server 初始化或 watch cache 尚未同步时,/readyz 会失败。API Server 健康检查
3.2 Terminate + Re-encrypt:网关成为受信任代理
网关终结下游 TLS 后,原始客户端证书不可能“穿过”新的 TLS 会话继续由 API Server 验证。生产设计通常从下面两条路径选择:
| 身份方式 | 工作方式 | 适用边界 |
|---|---|---|
| 转发 Bearer Token | 网关完成必要检查后,把原始 Authorization Token 交给 API Server 验证 | 适合 Token/OIDC;无法保留原始客户端证书认证链 |
| 网关身份 + Impersonation | 网关认证客户端,以专用 mTLS 身份访问上游,并通过 Impersonate 信息传递原用户/用户组 | 可统一多种下游认证,但网关获得高价值权限 |
KubeGateway 的设计采用 Kubernetes Impersonation 机制:API Server 先认证网关,再确认网关具备扮演用户的权限,最后按被扮演用户做授权,审计中也保留对应信息。CNCF 对 KubeGateway 的架构介绍
这条链路的生产基线至少包括:
- 网关使用独立、短周期、可轮换的上游客户端证书;
- API Server 只允许精确匹配的网关身份执行所需 Impersonate 操作,不能给宽泛的通配权限;
- 网关不能信任客户端自行提交的
Impersonate-*或类似身份头,必须删除后按认证结果重新生成; - 上游继续使用 TLS/mTLS,并校验 API Server 证书,不能为了省事改成明文;
- 审计同时记录网关身份、原始用户、请求 UID、来源和路由结果,并做定期抽样核对;
- 证书轮换要覆盖下游、网关自身和上游三段,验证新旧证书重叠窗口及回退。
4. 先把 L4 方案做正确
对大多数集群,我会先保留 L4 架构,按下面的顺序解决连接倾斜。
4.1 健康检查使用 /readyz,不要只探测端口
数据面可以继续 TLS Passthrough,但健康控制器应使用具备最小权限的凭据检查每个后端的 HTTPS /readyz。摘流依据使用 HTTP 状态码,?verbose 只供人工排障,不要让自动化解析易变的文本内容。
后端恢复时先让 /readyz 连续通过多个周期,再加入服务池。这样能避免 watch cache 尚未初始化的实例接住 LIST/WATCH 风暴。当前 Kubernetes API 文档还说明,watch cache 初始化期间会通过 readiness 保护,并对部分昂贵请求返回 429 和 Retry-After;客户端仍需实现退避。Kubernetes API Concepts
4.2 用 GOAWAY 温和轮换连接
kube-apiserver 提供 --goaway-chance:它按请求概率向 HTTP/2 客户端发送 GOAWAY,不中断当前 in-flight 请求,让客户端随后重连并再次经过 LB。官方参数说明给出的推荐起点是 0.001,允许范围为 0 到 0.02;单实例或没有 LB 的集群不应启用。kube-apiserver 参数参考
这只是起始实验值。每个请求都有概率触发时,QPS 越高,连接轮换越频繁;设置过大可能制造 TLS 握手、Watch 重连和 LIST 恢复压力。上线时我会按实例观察连接分布、GOAWAY/重连数量、LIST/WATCH 速率、429 和 TLS CPU,再逐步调整。
--http2-max-streams-per-connection可以限制服务端向客户端公布的一条 HTTP/2 连接最大 Stream 数。它主要约束单连接并发,不等同于负载均衡;设置太小会增加连接和握手,设置太大则扩大单连接的集中度。除非已经用真实客户端复现问题,我会保留 Go 默认值。
4.3 发布采用“先 Ready、再摘流、后退出”
API Server 退出前需要先让 LB 停止新流量,再给普通请求和长 Watch 留出排空时间。相关参数包括:
--shutdown-delay-duration:进入关闭流程后立即让/readyz失败,同时延迟真正终止,给 LB 留出摘流时间;--shutdown-send-retry-after:排空非长请求时,对新请求返回 429、Retry-After和Connection: close;--shutdown-watch-termination-grace-period:限制优雅关闭阶段等待活跃 Watch 的时间。
这些参数应与 LB 健康检查间隔、失败阈值、静态 Pod/进程管理器的终止宽限和客户端退避一起计算,不能各自复制一个“30 秒”。发布自动化的顺序应是:增加或启动新实例 → 等待 readiness 和缓存预热 → 从入口摘除旧实例 → 观察连接排空 → 终止旧实例。一次只改变有限故障域。
4.4 leastconn 只能优化新连接
L4 中使用 least-connections,通常比只按源地址哈希更适合长连接,但它仍然只为新连接选择当前连接较少的后端。它不能移动已建立的 HTTP/2 Stream,也不知道一条连接正在做空闲 Watch 还是持续大 LIST。
因此我不会把“后端连接数相等”作为最终成功标准。真正要看的是分实例请求率、返回字节、inflight、CPU、内存和尾延迟是否一起回到预算。
4.5 扩容 API Server 后,怎样让流量真正重新均衡
把第四台 API Server 加进 LB,只会影响新连接。原来落在前三台上的 HTTP/2 连接不会因为后端数量变化主动迁移。生产扩容要同时处理实例就绪、LB 放量和旧连接轮换。
变更前先确认实际存在几条访问路径:
- kubelet、外部控制器和运维 kubeconfig 是否访问统一的
controlPlaneEndpoint; - 集群内客户端是否通过
kubernetes.default.svc访问,由 Service Endpoint 和 kube-proxy 形成另一条 L4 路径; - controller-manager、scheduler 或本机 Agent 是否直连
127.0.0.1、节点地址或 node-local LB; - 监控看板能否按 API Server 实例区分上述来源。
只扩容外部 LB 后端,无法改变直连和 Service 路径的流量。先把来源分清楚,才能解释为什么 LB 已经有四个后端,仍有一部分请求固定在旧实例。
kubeadm 的高可用文档推荐在控制平面节点前使用 TCP 转发 LB,并要求 LB 地址与 ControlPlaneEndpoint 一致;文档中的 TCP 端口探测适合安装引导,运行阶段还应增加本文前面所述的 /readyz 和连接生命周期门禁。kubeadm 高可用控制面
新实例进入服务池前还要核对:服务证书覆盖相同的 LB DNS/IP,Client CA、ServiceAccount Key、Encryption Provider、审计、Admission 配置、Runtime Config 和 Feature Gate 与现有实例一致;它连接的是预期的 etcd 集群,并且版本偏差符合 Kubernetes 策略。/readyz 连续通过只能证明当前检查项就绪,不能代替配置一致性检查。
我采用下面的扩容顺序:
| 阶段 | 操作 | 必须观察的证据 | 停止条件 |
|---|---|---|---|
| 建基线 | 记录至少一个稳定窗口内的分实例 QPS、连接、CPU、P99、429、LIST/WATCH 和 etcd 延迟 | 基线时间范围和发布前快照 | 指标缺失或实例标签无法区分 |
| 启动 | 新 API Server 暂不接生产流量,直接访问后端完成证书、版本、API、etcd 和 /readyz?verbose 检查 |
readiness、启动日志、配置差异 | 证书、配置或 watch cache 未就绪 |
| 加入 | L4 先注册为健康后端;L7 先设为 0 或很低权重,再逐级放量 | 新实例收到探测和小比例真实请求 | 认证、授权、审计或协议结果不一致 |
| 预热 | 观察缓存、内存、CPU、P99 和 etcd Range;不要用一次 GET 代替预热验收 | 新实例指标进入正常区间 | LIST/429/etcd 延迟快速抬升 |
| 迁移 | 使用既有 GOAWAY 自然轮换,或把旧后端逐台 Drain 后受控断开连接 | 重连速率、TLS 握手、Watch 恢复、LIST 峰值 | P99、429、reset 或 etcd 压力越过预算 |
| 收敛 | 恢复统一权重,至少跨过一个业务高峰继续观察 | 请求份额和资源压力都回到目标区间 | 只有连接数均衡,QPS/CPU 仍明显倾斜 |
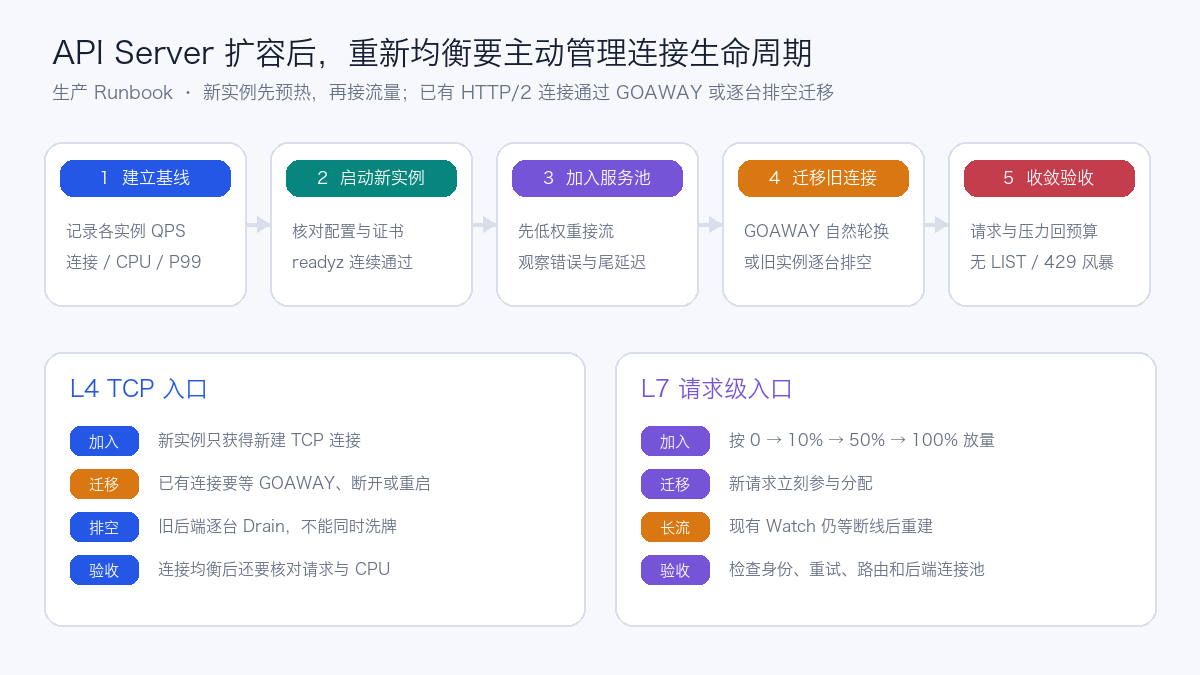
L4 的两种连接迁移方式
渐进迁移适合没有紧迫容量风险的场景。扩容前已经启用并验证过较低的 --goaway-chance,新实例加入后等待连接自然轮换。优点是重连比较平滑,代价是无法保证在一个固定短窗口内达到均衡。这个参数是 API Server 启动参数,应提前纳入控制面基线;扩容时首次启用会把参数发布和容量变更叠加在一起。
受控洗牌用于旧实例已经接近容量上限、需要尽快让新实例分担流量的场景。操作时一次只处理一个旧后端:
- 把旧后端设为 Drain,从普通的新连接选择中移除;如果配置了持久性规则,还要单独确认是否仍会命中;
- 等待普通短连接和请求自然结束,确认其他实例仍有容量;
- 通过 API Server 优雅退出,或在已经验证客户端重连能力后,受控终止该后端的剩余连接;
- 客户端重连时,LB 会在包括新实例在内的健康池中重新选择;
- 旧实例恢复 Ready 并重新加入后,再处理下一台。
以 HAProxy Runtime API 为例,操作语义可以写成下面这样:
# 停止把新连接分配给 api1;现有连接仍然保留
echo "set server kube_api/api1 state drain" \
  | socat stdio /run/haproxy/admin.sock

# 仅在已经验证客户端重连和 Watch 恢复后使用:强制结束 api1 会话
echo "shutdown sessions server kube_api/api1" \
  | socat stdio /run/haproxy/admin.sock

# api1 恢复并通过门禁后重新接流量
echo "set server kube_api/api1 state ready" \
  | socat stdio /run/haproxy/admin.sock
drain只停止普通的新连接选择,不会搬走已有连接;shutdown sessions server会立即终止该后端上的会话,应当视为故障注入级操作,不能对多个后端同时执行。HAProxy Runtime API 的修改只保存在运行内存,持久配置和自动化状态必须同步更新。HAProxy Drain 语义 · shutdown sessions server
云 LB 的“后端摘除”“连接排空”“连接终止”经常是三个不同选项,具体语义要在测试环境抓连接确认。只看到后端权重变为 0,不能推断旧 HTTP/2 连接已经迁移。
扩容后的验收不能只看四等分
四个后端并不一定应该各占 25%。权重、可用区就近策略、客户端访问路径和请求成本都会改变合理比例。我会同时计算:
请求份额_i = instance_i QPS / 总 QPS
连接份额_i = instance_i 活跃连接 / 总活跃连接
压力份额_i = instance_i CPU 或 inflight / 总压力
如果连接份额接近,但请求和 CPU 仍然倾斜,说明少量热连接承载了更多 Stream,继续调整 L4 算法作用有限。如果 QPS 接近而 CPU 倾斜,应继续按 verb、resource、响应大小、Admission 和 GC 查请求成本。
4.6 缩容比扩容更需要排空
缩容时先把目标实例从新流量选择中移除,再等待短请求结束,最后执行 API Server 的优雅关闭。长 Watch 不会因为权重为 0 自动消失,需要给出最大排空时间,并验证客户端按 resourceVersion 恢复。
如果使用 stacked etcd,移除控制平面节点还涉及 etcd 成员与多数派,必须作为独立变更处理。不要把“从 LB 删除后端”“停止 kube-apiserver”和“移除 etcd 成员”合并成一个不可回滚脚本。
5. 负载均衡策略应该怎么选
算法选择必须先写清层级。在 TCP 模式中,HAProxy 文档里的 round-robin、leastconn 和 source 选择的是新连接;在 HTTP 模式或专用 L7 Gateway 中,算法才可能按请求执行。HAProxy Backend 算法
| 策略 | 决策单位 | 适合场景 | 在 API Server 前的局限 |
|---|---|---|---|
| L4 round-robin | 新 TCP 连接轮询 | 后端同规格,连接持续时间和请求量相近 | 长连接建立后不再参与轮询;热连接仍会造成倾斜 |
| L4 leastconn | 新连接给当前连接较少的后端 | Watch、gRPC 等长连接较多,连接寿命差异明显 | 连接数不代表 Stream 数、QPS 或请求成本 |
| L4 source hash | 按源地址固定后端 | 明确要求连接亲和,且来源足够分散 | NAT、节点出口或少数控制器会形成热点;扩缩容映射也会变化 |
| weighted round-robin | 按权重分配新连接或请求 | 后端规格不同、金丝雀或新实例慢启动 | L4 权重不影响已有连接;权重应来自实测容量 |
| random / P2C | 随机取候选,再选较轻后端 | 后端较多,希望降低全量扫描和羊群效应 | 仍取决于“较轻”使用连接还是 active request 衡量 |
| L7 round-robin | 每个新 HTTP 请求 | 同规格 API Server,先追求可解释和稳定 | 长 Watch 建立后仍长期占用选中的实例 |
| L7 least-request | 选择 active request 较少的后端 | 普通请求耗时差异较大 | Watch 会长期计为 active request,应分流或单独建池验证 |
| locality-aware | 优先同可用区,再跨区失败转移 | 多可用区、跨区时延或带宽成本明显 | 本地优先可能牺牲全局均衡,区域故障时要验证剩余容量 |
Envoy 的 least-request 默认可使用两个随机候选再选择 active request 较少的后端,也就是 P2C;不同权重时还会把配置权重和 active request 组合计算。Envoy Least Request 这类算法适合短请求,但直接把 Kubernetes 长 Watch 与普通 GET 混在一个池里,active request 指标可能长期被 Watch 占据。
我的默认选择是:
- 三到五台同规格 API Server、保留 L4: 从 leastconn 开始,同时启用 readiness 摘流、优雅退出和经过验证的低概率 GOAWAY;如果连接寿命高度一致,round-robin 也可以作为更容易解释的基线。
- 来源集中在少数 NAT 或节点出口: 避免 source hash。它会把“来源少”直接放大成“后端热点”。
- 新旧规格混部: 使用权重,但先用同一请求模型测出每种实例的可持续 QPS、P99 和 CPU,权重不要直接按核数比例填写。
- 七层首次上线: 同规格后端先用 weighted round-robin 和慢启动,确认 Watch 与 Upgrade 协议后,再评估 least-request 或资源路由。
- Watch 占比高: 把长流和普通请求分别统计;采用 L7 时可为 Watch 设置独立路由或上游池,避免它干扰普通请求的 active-request 判断。
- 跨可用区: 优先本地只是第一层策略,还要保留跨区故障转移,并按单区失效后的剩余容量设计 APF、限流和后端权重。
策略变更也需要金丝雀。L4 只能通过一小部分入口或客户端组验证;“给新后端 10% 权重”表示约 10% 的新连接选择机会,不等于 10% 请求。L7 可以更接近按请求的 10%,仍要把长 Watch 单独统计。
6. 什么时候值得上七层 API Gateway
下面四类需求同时出现两类以上,七层方案通常开始有价值:
- API Server 经常因滚动升级或故障重连发生持续的请求倾斜;
- 需要按 user、serviceAccount、verb、resource、namespace 或 nonResourceURL 路由和限流;
- 多租户之间需要入口隔离、熔断、降级和独立 SLO;
- 平台同时管理大量集群,需要动态证书、后端和规则治理。
字节开源的 KubeGateway 明确面向千节点以上的大规模集群,提供请求级负载均衡以及按 verb、apiGroup、resource、user、serviceAccount 等字段路由,并宣称可把单个 API Server 的 TCP 连接数至少收敛一个数量级。KubeGateway README
通用 Envoy、HAProxy、NGINX 或云 L7 LB 也可能完成部分功能,但要逐项确认下面的 Kubernetes 语义,而不能只看到普通 GET 返回 200 就上线:
- 下游和上游 HTTP/2 是否都按预期启用,连接池能否分散到多个 API Server;
- Watch 是否允许长时间传输,idle timeout、buffer 和 backpressure 是否正确;
- exec、attach、port-forward、
kubectl logs -f的 Upgrade/WebSocket/SPDY 路径是否完整; - 网关摘除后端时,已有流式请求如何结束与重连;
- 认证失败、授权失败、429、5xx 和客户端取消能否原样返回;
- 请求体大小、响应流式传输、压缩和超时是否会被默认网关策略改变。
七层限流也不能替代 API Priority and Fairness。网关适合在入口丢弃明显异常或按租户执行粗粒度预算;APF 位于 API Server 内部,理解 Kubernetes 请求分类、seat 和公平排队,应继续承担过载时保护关键控制循环的职责。API Priority and Fairness
7. 不要让网关自动重试掩盖不确定写入
控制面入口最危险的默认功能之一,是对所有 5xx 或连接断开自动重试。
| 请求类型 | 建议 |
|---|---|
| GET | 可以在明确未收到上游响应、且有次数与总时限约束时重试 |
| 分页 LIST | 可有限重试,但要保持 continue/resourceVersion 语义 |
| WATCH | 由 Kubernetes 客户端按 resourceVersion 重建;不要让代理静默拼接成一条“看似连续”的流 |
| POST / PUT / PATCH / DELETE | 不对结果未知的请求做通用自动重试;客户端应查询对象状态或依赖幂等前置条件 |
| exec / attach / port-forward | 建连成功后不透明重放,断线由用户或上层工具重新发起 |
如果网关已把写请求送到 API Server,随后只是在返回途中断线,网关无法知道写入是否提交。再次发送可能造成重复操作、冲突或覆盖。安全做法是把失败如实交给客户端,同时保留 Audit-ID、请求 UID、上游实例和重试决策,便于确认最终状态。
8. 不同方案的效果应该怎样比较
公开案例可用于判断方向,但不能拼成一张“谁快多少”的排行榜,因为硬件、对象规模、QPS、请求分布和测试版本并不相同。
| 方案 | 能解决的问题 | 公开或机制层证据 | 仍需自行验证 |
|---|---|---|---|
| L4 Passthrough | 简单 HA、端到端 TLS | 路径短、身份边界简单;不能请求级均衡 | 故障摘除、连接倾斜、发布恢复时间 |
| L4 + GOAWAY + 优雅退出 | 缓解长期连接粘滞和 rollout 倾斜 | kube-apiserver 官方提供 GOAWAY 与 graceful shutdown 参数 | 合适概率、重连风暴、Watch/LIST 成本 |
| 客户端/服务端联合改造 | 更主动地重建连接与过载保护 | 阿里公开案例报告改造后负载基本均衡,重启两个实例后可恢复 | 自有客户端覆盖率、版本维护和恢复 SLO |
| KubeGateway 等专用 L7 | 请求级均衡、路由、限流和多集群治理 | CNCF 转载的字节案例报告代理增加约 1 ms、承载 35 万+ QPS;项目 README 报告连接数至少下降一个数量级 | 同硬件、同请求模型下的 P99、可用性、安全和运维成本 |
字节案例中的 1 ms 和 35 万+ QPS 是其环境中的公开结果,适用范围受当时的硬件、版本与流量模型约束。对自己的集群,我会用同一批回放请求依次测试直连单实例、L4、L4+GOAWAY 和候选 L7,保持后端 API Server、etcd、认证链、对象集和客户端并发不变。
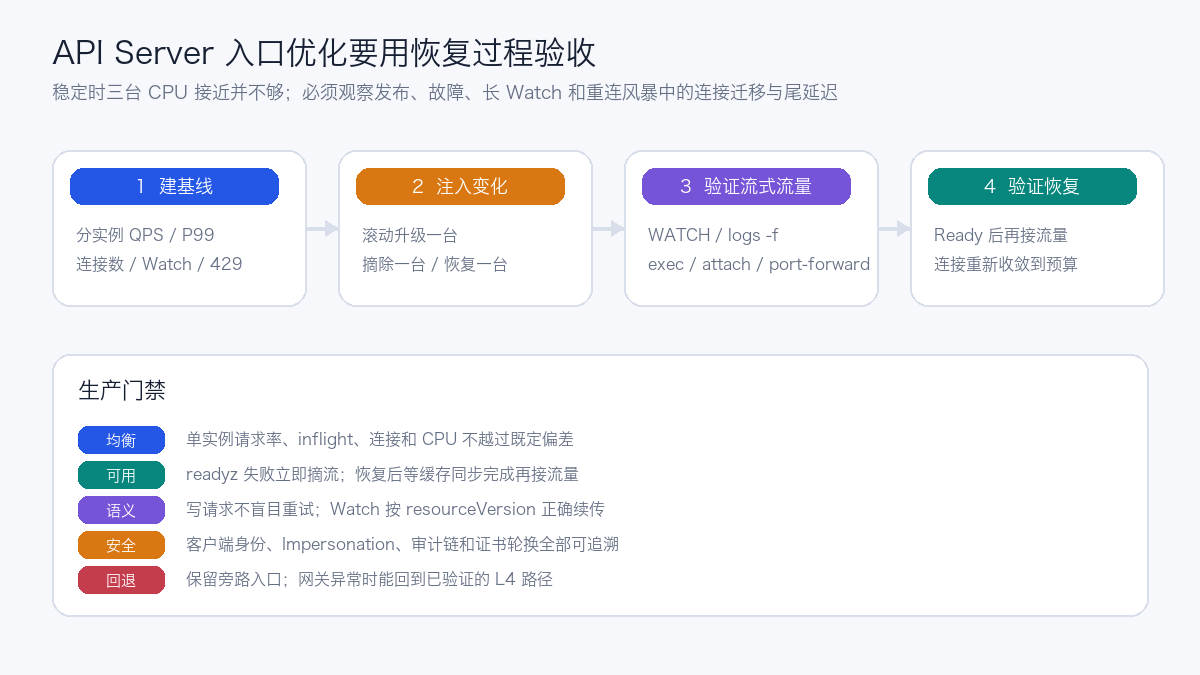
9. 一套可执行的压测与故障验证
9.1 负载模型
不要只用 kubectl get pods 循环。至少建立四组独立负载:
| 负载组 | 示例 | 观察重点 |
|---|---|---|
| 短读 | GET、分页 LIST、常见 discovery | QPS、P50/P99、连接池、序列化和返回字节 |
| 写入 | CREATE/PATCH/DELETE 临时对象 | 准入、etcd 提交、429、超时和不确定结果 |
| 长流 | WATCH、logs -f | 长连接分布、断线、resourceVersion 续传和慢消费者 |
| 升级流 | exec、attach、port-forward | Upgrade 成功率、会话中断和网关兼容性 |
再叠加三种事件:滚动重启一个 API Server、强制摘除一个后端、恢复一个冷实例。成功标准不能只写“请求成功率 99.9%”,还要定义最大单实例负载偏差、P99 预算、429 上限、Watch 恢复时间和连接重新收敛时间。
9.2 核心指标
下面的 PromQL 用于建立视角,标签需按实际采集配置调整:
# 各 API Server 请求率
sum by (instance) (rate(apiserver_request_total[5m]))

# 各实例 P99;生产看板还应按 verb/resource 拆分
histogram_quantile(
  0.99,
  sum by (instance, le) (rate(apiserver_request_duration_seconds_bucket[5m]))
)

# 当前执行中的读写请求
sum by (instance, request_kind) (apiserver_current_inflight_requests)

# APF 拒绝
sum by (instance, flow_schema) (
  rate(apiserver_flowcontrol_rejected_requests_total[5m])
)
API Server 指标还要与 LB/网关指标放在同一时间轴:前后端连接数、TLS 握手率、upstream reset、每后端请求率、主动健康状态、重试次数、各路由 P99、网关 CPU/内存和证书过期时间。只看 API Server CPU,会分不清流量真的均衡了,还是网关丢了请求。
我会给看板增加两个直接门禁:
阈值不应照搬。短时间偏差可以接受,关键是故障或发布后能在既定时间内重新收敛,而且尾延迟、错误率和 etcd 压力没有同步恶化。
10. 生产落地顺序
阶段一:把现状量出来
按 API Server 实例记录请求、连接、Watch、CPU、内存、P99 和返回字节;把倾斜开始时间与升级、故障、证书轮换、控制器重启对齐。如果三台实例请求数接近但 CPU 差距大,先按 verb/resource 查大请求,不要直接归因于 LB。
阶段二:强化 L4 基线
完成 /readyz 摘流、先扩后缩、优雅关闭和后端恢复门禁。只在观察到 HTTP/2 粘滞后,从低值验证 --goaway-chance。保留端到端 TLS 和一条紧急旁路入口。
阶段三:影子验证 L7
复制真实流量的统计分布或做脱敏回放,让 L7 先承接测试身份和测试资源。验证所有长流与升级协议,再做故障注入、证书轮换和网关自身滚动升级。不要通过复制真实写请求做影子流量。
阶段四:按调用方分批迁移
先迁移可回退、以读为主的自动化客户端,再迁移控制器和节点组件。每批都同时比较直连/L4 旁路和 L7 指标。网关规则、证书和身份映射应版本化,变更要有静态校验、金丝雀和自动回滚。
11. 最终选型建议
| 集群情况 | 建议方案 |
|---|---|
| 中小规模,API Server 负载均匀,没有复杂入口治理 | L4 TCP + TLS Passthrough;做好 /readyz 与优雅发布 |
| 升级后偶发连接倾斜,但治理需求有限 | 保持 L4,验证 --goaway-chance、leastconn、先扩后缩和连接排空 |
| 千节点以上,多租户、Watch 多,要求按请求属性路由与限流 | 评估 KubeGateway 或经过完整 Kubernetes 语义验证的 L7 网关 |
| 多集群统一入口和证书治理 | 独立的 API Gateway 控制面;按集群隔离证书、上游池、限额和故障域 |
| 只想减少一次故障后的短暂倾斜 | 不要直接引入复杂 L7;先修复 rollout、readiness 和连接生命周期 |
四层方案的价值是路径短、信任边界清晰;七层方案的价值是把均衡单位从连接提升到请求,并获得精细治理能力。两者对应不同的责任模型。只要 TLS 在网关终结,团队就同时接手了身份传递、审计完整性、协议兼容和网关高可用。成熟的方案应让新增能力与这些新增责任一一对应,并用发布与故障过程证明它能够恢复。