万节点 Kubernetes 集群优化实战:控制面、etcd、调度与网络
讨论万节点 Kubernetes 时,最容易犯的错误是先找一份“万能参数表”。节点规模扩大以后,真正压垮系统的通常不是节点对象本身,而是 Lease、Pod、Event、CRD status、LIST/WATCH、调度重试和批量变更形成的控制循环。相同的一万节点,运行“一台机器一个大作业”和“一台机器一百个微服务 Pod”,控制面负担可以相差几个数量级。
我的处理顺序一直是:先决定单集群是否值得,再建立负载模型,随后减少无效请求,最后才调组件参数。 如果集群仍然通过增加客户端 QPS、扩大 etcd quota 和拉长超时维持表面稳定,规模继续上升后只会把故障推迟到更难恢复的位置。
先给出几个结论:
- Kubernetes 官方当前公布的通用规模基线是最多 5000 节点、每节点 110 个 Pod、总计 15 万 Pod 和 30 万容器。这是经过验证的工作范围,不是写死在代码里的硬上限。Kubernetes 大集群最佳实践
- 一万节点已经超出上游通用验证边界。可以实现,但需要专用规模测试、受控负载形态、etcd 和 API 治理、明确的故障恢复能力,并接受更大的单集群故障半径。
- etcd 优化首先是减少对象和写入,而不是更换一组神奇参数。Raft 写入必须等待多数派,增加成员数只会提高容错能力,不会提高写入容量。
- 单一超大集群不是平台成熟度的奖杯。对于普通业务,多个受控规模集群往往更容易升级和隔离故障;对于需要共享整池 GPU、Pod 数量相对少的大作业,单一大集群才可能产生足够的容量收益。
这篇文章关注单集群扩大的工程方法。数百个独立集群的发布、配置和灾备治理,可继续阅读 数百个 Kubernetes 集群的稳定性建设。
1. 节点数不是容量模型
Kubernetes 节点默认每 10 秒更新一次 Lease。一万节点仅心跳就形成大约 1000 次 Lease 更新/秒;这还没有计算 Pod 生命周期、Event、控制器状态更新和业务 CRD。节点状态本身默认在变化时或每 5 分钟更新一次,Lease 才是高频健康信号。Node heartbeat
我会先把规模写成下面这张压力账单:
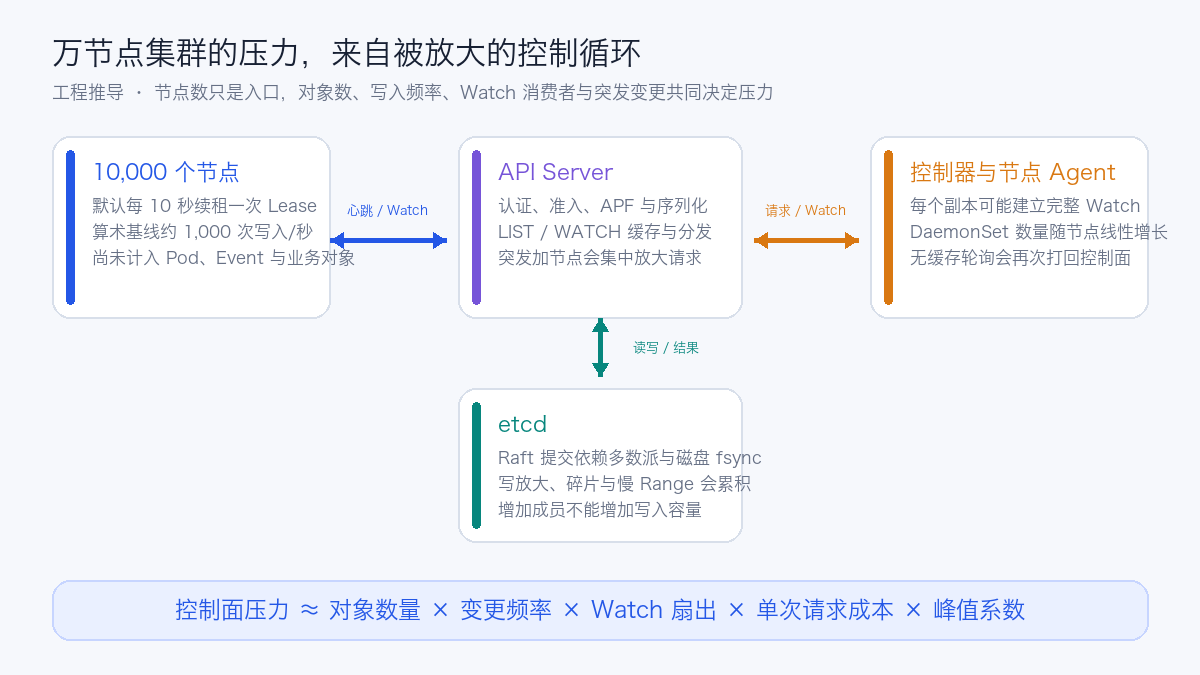
这个模型能解释很多表面上不一致的现象:节点数没有变化,只增加了一个在每个节点运行的 Agent,API Server 流量却明显上升;工作负载数量相同,只把控制器副本从 2 扩到 20,每个副本的全量 Watch 又把网络和反序列化成本放大十倍;etcd 文件只有几 GB,一次返回大量对象的 Range 请求仍可能让尾延迟和内存突然升高。
规模评审时,我至少会收集以下数据,而不是只填“目标一万节点”:
| 维度 | 需要测量的值 | 为什么重要 |
|---|---|---|
| 对象基数 | Node、Pod、Lease、Event、Service、EndpointSlice、Secret、ConfigMap 与主要 CRD 数量 | 决定存储、LIST 和 Watch 初始同步成本 |
| 写入 | 各资源 CREATE、UPDATE、PATCH、DELETE 速率及峰值 | 决定 etcd Raft、准入和序列化压力 |
| 读取 | LIST 响应大小、范围、频率以及分页情况 | 大范围读取容易造成 API Server 与 etcd 内存峰值 |
| Watch | 按资源统计连接数、事件速率和慢消费者 | 同一个变更会被多个消费者重复处理 |
| 调度 | 待调度 Pod、每秒创建量、调度耗时、失败插件和重试量 | 判断瓶颈在过滤、打分、队列还是后端容量 |
| 变更峰值 | 加节点、控制器重启、批量发布、区域故障后的请求曲线 | 稳态正常不代表恢复过程能承受 |
2. 一万节点应该是一项架构选择
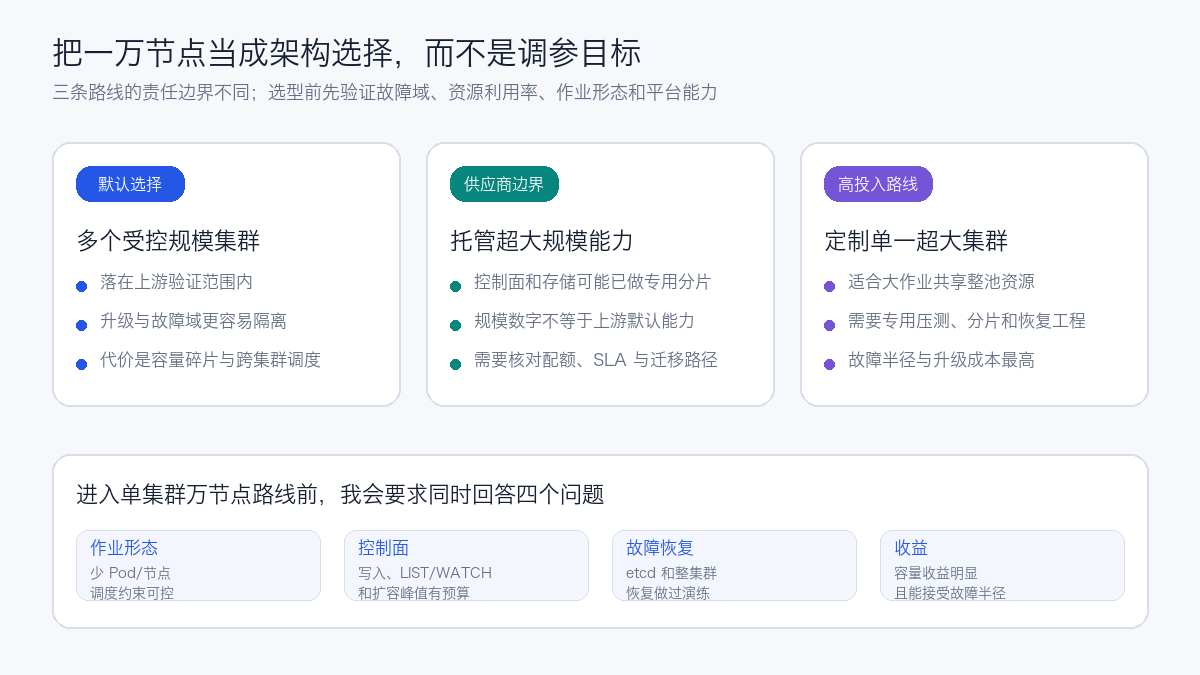
我通常先比较三条路线:
| 路线 | 更适合的情况 | 主要代价 |
|---|---|---|
| 多个不超过验证边界的集群 | 普通在线服务、多业务隔离、独立升级窗口、区域故障域 | 容量碎片、跨集群调度、配置与版本治理 |
| 云厂商托管的超大规模能力 | 希望购买已经定制的控制面能力,能够接受产品边界 | 供应商依赖、配额和功能差异、迁移成本 |
| 自建单一万节点集群 | 少 Pod/节点、大作业共享资源、收益能够覆盖工程成本 | 单集群故障半径、专用存储与控制面、升级和恢复复杂度 |
OpenAI 公开过 7500 节点集群,但文章同时说明其工作负载通常由一个 Pod 占用整台机器,调度约束较简单,网络也有较强保证。这种负载形态与每节点运行大量微服务并不等价。他们遇到的 Endpoints Watch 扇出一度产生接近 N² 的流量,改用 EndpointSlice 后相关负载下降了三个数量级;一次加入数百节点也会冲击 API Server,因此扩容需要平滑推进。OpenAI:Scaling Kubernetes to 7,500 Nodes
Uber 的公开迁移实践验证过 7500 节点、20 万 Pod 和每秒 150 个 Pod 的调度场景,并调整了客户端 QPS、控制器并发、调度器和 APF。Uber 选择较大集群是为了减少资源碎片和控制面开销,这个收益前提同样重要。Uber:Migrating the Compute Platform to Kubernetes
AWS EKS 的 Ultra-Scale 能力达到 10 万节点,但它对 Kubernetes 对象按资源类型划分到多个 etcd 集群,并使用专门的调度和控制面实现。这个案例证明“超大规模需要分片”,不能反过来证明上游默认组件无需改造就能达到相同数字。Amazon EKS Ultra-Scale 架构
这些案例放在一起,我得到的判断是:先确认超大集群能减少多少真实碎片,再决定是否承担更大的恢复单元。 如果收益只来自“集群数字更大”,多集群通常更稳妥。
3. 从阿里和字节的公开实践中提炼运行经验
国际案例说明了超大集群可以做到多大,阿里和字节的分享则更接近日常运行:控制面滚动升级后为何一台 API Server 被打满、Controller 主备切换为何仍要几分钟、一个 DaemonSet Agent 为什么能拖垮整个集群、离线任务进入后元数据压力为什么会突然放大。
这里需要先说明版本边界。阿里的万节点控制面文章来自 2019 年,部分改进后来已经进入 Kubernetes 上游;字节的 2 万节点分享来自 2024 年,其中 KubeGateway、KubeBrain 和 Gödel Scheduler 属于深度定制方案。我的做法不是复制当年的 patch,而是把它们还原成今天仍然成立的问题,再选择当前版本能够提供的实现。
3.1 压测要还原对象形态和重启过程
阿里在万节点规划中使用 1 万 Node、20 万 Pod、100 万对象作为目标模型,并用 Kubemark 模拟 1 万 kubelet。最初测试中,Pod 调度延迟达到 10 秒量级,同时出现 etcd 读写延迟、Pod/Node 查询可能导致后端 OOM、Controller 重启恢复数分钟和调度吞吐不足等问题。阿里巴巴万级 Kubernetes 控制面优化
这组数字的价值不在于提供一份固定规格,而在于提醒我:节点、Pod 和对象必须分别建模。 一万个几乎空闲的模拟节点,无法代表一万个运行大量 CRD、Webhook 和 Agent 的生产节点。我的规模测试会拆成三张负载画像:
| 画像 | 要还原的内容 | 重点证据 |
|---|---|---|
| 稳态对象 | Node、Pod、Lease、Service、EndpointSlice、Secret 与主要 CRD 的数量和大小 | API/etcd 内存、LIST 大小、Watch 事件率 |
| 业务变化 | 发布、弹性、Job 批量创建、status 更新、Event 和删除 | 写 QPS、调度吞吐、队列积压、Webhook 延迟 |
| 冷启动与恢复 | API Server、Controller、Scheduler、Agent 和节点批量重连 | LIST 风暴、缓存同步时间、峰值内存、恢复到 SLO 的时间 |
蚂蚁的分享进一步指出,标准压测容易漏掉生产扩展:一个不规范的 DaemonSet 客户端或者慢 Webhook,在万节点环境中足以把 API Server 推向崩溃。蚂蚁金服万节点集群实践 因此,压测包必须包含生产中的 DaemonSet、Operator、Webhook、审计和监控链路;只测原生控制面最多证明上游基线能够运行。
3.2 四层负载均衡解决不了长连接倾斜
阿里和字节都遇到了多实例 API Server 负载不均衡。client-go 会复用 HTTP/2/TLS 长连接;API Server 滚动升级或单实例重启后,先恢复的实例可能承接大量长期连接,后恢复的实例长时间接不到相同比例的请求。普通四层 LB 只在建连时选择后端,连接不重建,增加 LB 本身不会重新分配已有流量。
我会先从四组指标确认问题,再决定是否引入网关:
- 分实例比较请求率、CPU、内存、inflight 和 Watch 数;
- 比较前端连接数、HTTP/2 stream 数和客户端来源;
- 把不均衡开始时间与 API Server rollout、故障和证书更新对齐;
- 对照业务 verb/resource,区分少量大 LIST 与普通请求数量倾斜。
短期手段是采用先扩后缩的 API Server 发布策略,让新实例 Ready 并完成缓存预热后再下线旧实例,同时限制一次退出的实例数。长期需要请求级均衡时,可以评估七层 Kubernetes API Gateway。字节开源的 KubeGateway 能解析 user、verb、resource 等请求属性,在 HTTP 请求层做路由、限流、降级和上游健康检查,并通过 HTTP/2 多路复用收敛上游连接。字节 2 万节点 GOPS 分享
API Gateway 进入控制面后也成为新的关键依赖。上线门禁必须覆盖长 Watch、exec/log 流式连接、证书与 Impersonation、审计身份、Gateway 故障旁路和升级中的连接迁移。若只为修复一次连接倾斜就直接引入复杂网关,新增风险可能大于收益。四层、七层、TLS 终结与 GOAWAY 的具体取舍可继续阅读 Kube-apiserver 负载均衡实战。
3.3 HA 进程就绪,不代表控制循环已经就绪
Controller 或 Scheduler 备实例虽然处于运行状态,Informer cache 可能尚未同步;主实例故障后再由冷备执行全量 LIST 和反序列化,切换仍会持续数分钟,并在最脆弱的时候给 API Server 和 etcd 增加负载。
阿里的方案是提前启动备实例的 Informer,主实例升级时主动释放 Leader Lease,让已经预热的备实例接管。其分享报告升级切换中断降到 2 秒以内,异常故障则主要等待默认 15 秒的 Leader Lease 到期;这是当时目标环境的结果,不能直接当成其他集群的 SLO。阿里 Controller failover 实践
在自己的平台里,我会把控制器 readiness 拆成四项:进程存活、关键 Informer HasSynced、本地 resourceVersion 接近 API Server 进度、取得领导权后代表性队列能够推进。热备会增加 Watch 和内存,因此只给关键控制器使用,并把主备副本的重复缓存计入容量。
API Server 也需要类似门禁。字节分享过 Cache NotReady 时拒绝大 LIST,以及把满足条件的读取引导到 cache,目标是避免冷实例一边初始化缓存,一边接受新的全量读取。当前版本还可以结合 WatchList、consistent reads from cache 和 etcd RangeStream,但核心规则没有变化:缓存完成同步之前,不让实例承接最昂贵的流量。
3.4 元数据存储的演进顺序比最终架构更有价值
阿里的 etcd 方案经历了外部存储、按资源拆分多个 etcd、再到定位 bbolt page 分配问题的多轮演进。第一版引入 Tair 提升容量,却增加了运维复杂度并改变一致性风险;后续才通过资源路由和底层存储优化继续推进。这个过程提醒我,替换存储后端会把“容量问题”扩展成“一致性、Watch、备份和升级问题”。
字节在离线业务进入后观察到 10 到 20 倍的元数据存储压力,随后构建 KubeBrain,把 Kubernetes 所需的 MVCC、CAS 和 Watch 语义适配到 ByteKV 等分布式 KV 后端;公开案例报告过 1 万节点、40 万以上容器以及 5000 容器 10 秒内 Gang 拉起的结果。字节融合调度实践 KubeBrain 也明确把水平扩展作为目标。
我不会把这理解成“万节点必须替换 etcd”。实施顺序仍然是:治理写入和大对象 → 专用硬件 → cache/list/watch 优化 → Event 或热点资源拆分 → 评估自定义存储。走到最后一步时,验收范围至少包括:
- 线性一致读、CAS 与事务边界;
- resourceVersion 单调性、Watch 顺序、断线续传与历史压缩;
- TTL/Lease、分页、大对象和慢消费者;
- 故障注入、网络分区、主从切换与不确定写入结果;
- 快照、跨版本升级、回滚、数据校验与 Kubernetes 全链路恢复。
KubeBrain 仓库公开的 TODO 仍列有一致性关键场景和 Jepsen 测试等工作。这个信息很重要:开源项目展示了架构方向,不等于任何版本都可以直接替换生产 etcd。选型时要核对正在使用的 commit、后端和已经完成的测试,不能只引用分享中的峰值数字。
3.5 调度吞吐来自减少重复工作
阿里分享的两个思路是把相似 Pending Pod 归为等价类,复用过滤和打分结果;候选节点很多时采用松弛随机化,找到足够可行节点后停止继续扫描。字节开源的 Gödel Scheduler 则使用乐观并发优化过滤与打分,并引入 Unit/Pod 两层语义处理批任务和 Gang Scheduling。
这些实践让我不会先把 scheduler 并发参数调大。更有效的顺序通常是:识别相同约束的批量 Pod → 缓存或复用重复计算 → 减少无关事件导致的重新入队 → 对简单任务使用更轻的 profile → 在可接受的放置质量下减少候选节点 → 最后调整并发。每一步都要同时看吞吐和碎片,防止短期调得快、长期把可用大块资源切碎。
3.6 超大集群需要能够阻止正确程序做出错误规模的动作
阿里 ASI 的运维复盘披露过几个很有代表性的事故:正常 Kubelet 升级导致近千业务 Pod 重建,错误判断触发 300 多节点业务驱逐,非标操作批量删除服务。后续方案对 Pod、Service、Node 等关键资源按 1 分钟、5 分钟、1 小时和 24 小时设置操作令牌,结合 UserAgent 限流和 APF,并用持续探针参与发布阻断。阿里 ASI 全托管运维实践
这类经验比“多部署几套监控”更接近万节点稳定性的核心。我的自动化工作流会同时设置:
- 对象预算:限制一次和一个窗口内可删除、驱逐、更新的 Node/Pod/Service 数;
- 故障域预算:分别约束集群、可用区、节点池和同一业务副本组;
- 调用方预算:按 ServiceAccount/UserAgent、verb 和 resource 统计并限流;
- 推进门禁:业务探针、控制面指标和观测完整性全部满足才扩大批次;
- 独立刹车:异常扩大、指标失联或执行状态不明时停止新增动作;
- 有状态确认:数据库、中间件、Flink 和训练任务把可中断条件提供给平台,自愈系统不自行猜测。
我会把这些经验落到排障表,而不是保留成架构名词:
| 现场表现 | 容易做出的第一反应 | 我先核对的证据 | 优先动作 |
|---|---|---|---|
| 一台 API Server 满载,其他实例很空 | 再加实例 | 分实例连接、stream、请求率和 rollout 时间线 | 先扩后缩、连接/请求级重平衡,再评估七层网关 |
| 控制面重启后持续 OOM | 继续加内存 | Cache ready、全量 LIST、resourceVersion、客户端重试 | 冷启动限流、缓存同步门禁、错峰重启 |
| Controller 切换要几分钟 | 缩短 Leader Lease | Informer 同步与反序列化时间、队列恢复 | 关键控制器热备预热,随后再调 Lease |
| etcd DB 与写延迟持续增长 | 扩大 quota | 写入 Top N、对象大小、历史与碎片率 | 治理 status/Event,compact/defrag,必要时按资源拆分 |
| Scheduler 吞吐不足 | 提高并发 | 插件耗时、重复约束、无效重试和碎片 | 复用计算、分 profile、减少候选节点 |
| 自愈一次影响数百节点 | 增加判断规则 | 动作窗口、故障域、业务副本和停止条件 | 多层操作预算、探针门禁与独立熔断 |
4. 先给控制面建立服务目标
优化需要围绕用户可感知的结果。只看 CPU 利用率,很容易把排队、拒绝和客户端重试遗漏掉。我会把控制面目标分成四层:
| 层次 | 观察内容 | 示例判据 |
|---|---|---|
| API 可用性 | 成功率、429、5xx、inflight、APF 排队与拒绝 | 关键写入在目标窗口内满足 SLO,限流能保护核心请求 |
| API 响应性 | 按 verb/resource/scope 统计 P50/P95/P99 | 大 LIST 单独统计,不能与小 GET 混在一起平均 |
| 协调进度 | workqueue 深度、重试、最老待处理项、控制器延迟 | 请求成功后,目标对象能在规定时间达到期望状态 |
| 业务结果 | Pod 调度、启动、Service 可达、卷挂载、DNS 解析 | 批量扩容与故障恢复时仍达到验收标准 |
规模压测前先固定版本、特性门和客户端配置,保存 API Server、scheduler、controller-manager、etcd、CNI、CSI、DNS 以及关键控制器的资源与参数。否则一次测试结论无法解释,也无法用于升级回归。
5. API Server:先治理客户端,再增加实例
增加 API Server 实例能够分担无状态请求和 Watch 连接,但无法消除写入最终落到 etcd、每个控制器重复 Watch、Webhook 串行阻塞等问题。我会按以下顺序处理。
5.1 让 LIST/WATCH 具备边界
- 控制器使用共享 informer/cache,避免每次协调都直接 LIST;仅缓存需要的资源、Namespace 和字段。
- WATCH 断线时使用退避,并允许
BOOKMARK;不要让所有客户端在同一秒重新全量 LIST。 - 需要初始状态时,使用目标版本支持的 streaming list/watch 机制,避免先把巨大列表完整缓存在 API Server 内存。Kubernetes 1.34 中 Streaming Lists 已进入 Beta 并默认开启,使用前仍需按客户端和版本验证。Streaming Lists
- 对只读一致性要求允许的请求,验证 watch cache 路径。Kubernetes 在 5000 节点测试中曾报告一致性读取缓存使 API Server CPU 下降约 30%、etcd CPU 下降约 25%;这是该测试环境的结果,需要在自己的对象分布上复测。Consistent Reads from Cache
controller-runtime 的缓存会隐藏 LIST/WATCH 成本。一个 Reconcile 中看似普通的 List(),如果没有限定范围,可能把某类资源全部装进进程内存。控制器副本扩展前,应统计每个副本缓存的对象数、内存和 Watch 流量,而不是只看 Reconcile 并发。Controller-runtime cache 说明
5.2 用 APF 保护关键控制循环
API Priority and Fairness 可以按用户、ServiceAccount、verb、resource 和 Namespace 分类请求,隔离并发份额并对部分请求排队。它适合防止批量 LIST、平台脚本或异常控制器挤占 kubelet 与核心控制器请求,但配置必须经过命中验证和压测。APF 官方文档
我的做法是先从审计和指标中找出请求主角,再建立少量清晰的优先级:节点心跳和核心控制器、生产变更、普通平台请求、批量和调试流量。随后通过响应头、FlowSchema 命中计数、排队时间和 429 核对实际效果。本站的 APF 隔离实测 展示了这套验证方法。
APF 不会降低一个巨大 LIST 自身的成本,也不会保护已经进入 etcd 的错误写入。限流后客户端如果无退避地重试,还可能制造更大流量,因此客户端请求预算与服务端策略要一起改。
5.3 缩短准入链路
准入 Webhook 每次被调用都位于 API 写入关键路径。应缩小匹配资源和 Namespace,使用 matchConditions 排除无需处理的对象,设置短而明确的超时,提供多副本和反亲和,并避免 Webhook 修改自己依赖的对象形成循环。简单校验优先考虑 CEL 等内置能力。Admission Webhook 最佳实践
failurePolicy 不能统一设成 Ignore 或 Fail:安全边界通常需要失败关闭,可用性辅助能力可能允许失败放行。决定应写进威胁模型和故障演练,而不是在事故时临时切换。
5.4 把节点加入与组件重启做成批次
节点启动会产生注册、Lease、状态、DaemonSet Pod、CNI/CSI 和监控 Agent 等一串请求。一次投入数百或数千节点,会让各控制循环同时加速。加入过程需要固定每批节点数、批间观察时间和自动停止条件;DaemonSet rollout、控制器重启和节点扩容也应避免叠在同一窗口。
6. etcd:优化的是写入路径和恢复能力
etcd 是 Kubernetes 一致状态的底座。一次写入要进入 WAL、通过 Raft 多数派提交,再应用到后端存储。磁盘抖动、成员间网络延迟、CPU 饥饿或大范围读取都可能表现成 API Server 尾延迟。我的优化原则是先减负,再保证硬件,随后维护数据库,最后才考虑拆分。
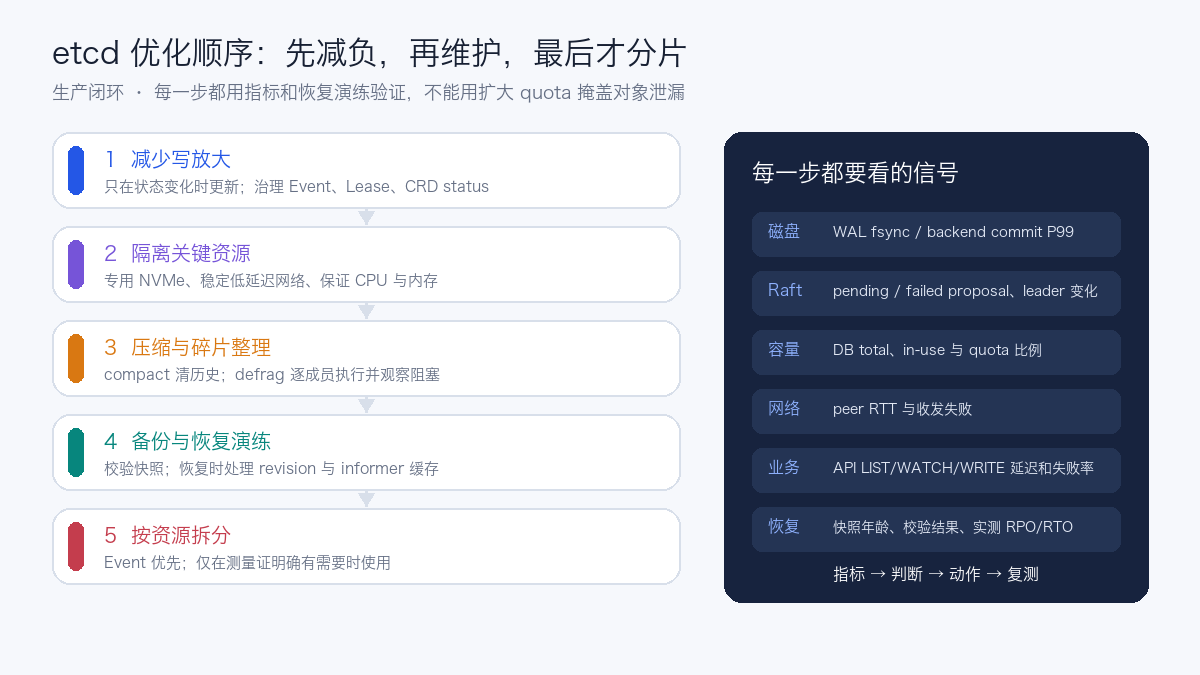
6.1 先找出谁在写
扩大磁盘和 quota 前,先从 API Server 指标与审计日志按 resource、verb、user 和 userAgent 统计写入。常见问题包括:
- 控制器无论状态是否变化都更新
status; - Event 高频重复,或者保留时间远大于排障需要;
- Agent 定时 PATCH 对象,把 Kubernetes 当作指标或心跳数据库;
- CRD 单对象过大,状态中存放日志、历史记录或大段配置;
- 失败控制循环持续创建、删除或更新对象;
- 无效 finalizer 让删除对象长期滞留。
处理这些源头通常比调整 etcd 参数更有效。状态更新应比较新旧值,只在变化时写入;高频时序数据进入监控系统;历史记录放到对象存储或数据库;Event 设置符合排障窗口的 TTL;CRD 把频繁变化和长期配置拆开。
6.2 给 etcd 独立、可预测的资源
etcd 对持久化延迟非常敏感。我会优先使用专用本地 NVMe/SSD,避免与日志、容器镜像和高吞吐业务共享 I/O;为进程保留 CPU 和内存,禁止 swap;成员间网络选择低延迟、低丢包路径,并让所有成员使用一致的 heartbeat 与 election 参数。etcd tuning
heartbeat 不应靠猜。etcd 建议按成员间 RTT 设置为约 0.5 到 1.5 倍,election timeout 至少为 RTT 的 10 倍,并且所有成员保持相同值。拉长 election timeout 能减少误选举,却会延长真实故障发现时间;应先修复磁盘和网络抖动,再调整时间参数。
成员数按故障模型选择 3 或 5。增加到 7 个成员不会提高写吞吐,因为一次提交仍需等待多数派,反而增加复制和达到 quorum 的成本。成员不应自动扩缩容;跨区域部署也必须把 RTT 和区域同时故障风险放进测试。Kubernetes 配置外部 etcd
关键参数要与版本、依据和验证结果一起管理:
| 参数 | 作用 | 生产调整依据 |
|---|---|---|
--heartbeat-interval |
leader 向 follower 发送心跳的间隔 | 成员间 RTT、磁盘尾延迟和误选举记录 |
--election-timeout |
follower 判定 leader 失效的等待时间 | 与 heartbeat 成比例,权衡误选举和故障发现时间 |
--auto-compaction-mode / --auto-compaction-retention |
以时间或 revision 保留 MVCC 历史 | 最慢 Watch 恢复窗口、写入速度与数据库增长率 |
--snapshot-count |
触发内部 Raft 快照的已提交事务数 | 内存、慢 follower 追赶和快照开销;它不是灾备快照 |
--quota-backend-bytes |
后端达到配额时触发空间告警 | 对象规模、增长率、处置时间和实测恢复能力 |
--max-request-bytes |
单个 etcd 请求大小上限 | 优先拆小 Kubernetes 对象;扩大上限需评估内存和尾延迟 |
etcd 3.6 把 snapshot-count 默认值从 10 万降到 1 万,以减少保留的 Raft 历史和内存;这也说明跨版本照搬旧配置会失去新版本的默认优化。etcd 3.6 发布说明 所有成员应使用同一组 Raft 时间参数,配置文件、命令行和环境变量的优先级也要统一,避免实际生效值与配置仓库不一致。etcd 3.6 配置参考
6.3 quota 不是容量扩展方案
etcd 默认后端配额为 2 GiB,官方对常规环境建议的上限是 8 GiB,并会对更大的配置发出警告。这个数字不是 Kubernetes 万节点集群的统一答案;它提示的是 etcd 的设计目标仍是保存小规模、可放入内存的元数据。etcd system limits
生产配额应根据对象增长率、compaction 周期、碎片率、快照和恢复时间实测,并预留处理峰值的余量。数据库逼近 quota 时直接扩大上限,可能把对象泄漏变成更慢的恢复。我的告警通常会先在容量占比进入观察区间时定位增长资源,再在更高区间限制非关键写入;阈值要按写入速度和处置时间推导,不照抄固定百分比。
6.4 compaction 与 defragmentation 是两件事
MVCC compaction 删除旧 revision 的逻辑历史,降低仍需要保留的历史范围;defragmentation 重建后端文件,才会把空洞空间返还给文件系统。只做 compaction,磁盘文件大小未必下降;只做 defrag,又无法治理历史版本持续增长。etcd maintenance
我会采用以下维护流程:
- 配置与业务恢复目标一致的自动 compaction,持续观察 compact 相关失败和 Watch 客户端行为;
- defrag 前确认快照有效、集群有 leader、成员健康且没有大规模发布;
- 一次只处理一个 follower,期间观察 API 延迟、leader、pending proposal 和成员同步;
- 验证完成后再处理下一个成员,leader 最后执行,必要时先转移领导权;
- 记录处理前后的 total size、in-use size、耗时和 API 尾延迟。
在线 defrag 会阻塞目标成员的读写,不能用 CronJob 同时对全部成员执行。维护频率应由碎片增长率决定,而不是每天固定运行一次。
6.5 先把 etcd 看板做完整
以下指标名来自 etcd 的稳定 Prometheus 指标;具体发行版可能增加标签,查询前应先检查目标版本 /metrics。etcd metrics
| 信号 | Prometheus 指标 | 需要回答的问题 |
|---|---|---|
| WAL 落盘 | etcd_disk_wal_fsync_duration_seconds |
P99 是否出现周期性尖峰,是否与 API 写延迟重合 |
| 后端提交 | etcd_disk_backend_commit_duration_seconds |
BoltDB 提交是否受到共享磁盘或 defrag 影响 |
| Leader | etcd_server_has_leader、etcd_server_leader_changes_seen_total |
是否失去 leader,选举次数是否异常增长 |
| Raft backlog | etcd_server_proposals_pending、etcd_server_proposals_failed_total |
请求是否在等待提交,失败是否与选举或 quorum 有关 |
| 数据库大小 | etcd_mvcc_db_total_size_in_bytes、etcd_mvcc_db_total_size_in_use_in_bytes |
距离 quota 还有多少空间,碎片比例是否持续上升 |
| 成员网络 | etcd_network_peer_round_trip_time_seconds、peer failure 指标 |
慢成员是否拉高多数派提交时间 |
几个基础查询可以先放进 Grafana,再根据实际 label 补充集群和成员过滤:
# WAL fsync P99
histogram_quantile(
  0.99,
  sum by (instance, le) (
    rate(etcd_disk_wal_fsync_duration_seconds_bucket[5m])
  )
)

# backend commit P99
histogram_quantile(
  0.99,
  sum by (instance, le) (
    rate(etcd_disk_backend_commit_duration_seconds_bucket[5m])
  )
)

# 近 15 分钟 leader 变化
sum by (instance) (
  increase(etcd_server_leader_changes_seen_total[15m])
)

# 后端文件中的碎片比例;total 为 0 时需要在面板中保护除零
1 - (
  etcd_mvcc_db_total_size_in_use_in_bytes
  /
  etcd_mvcc_db_total_size_in_bytes
)
旧版 etcd FAQ 曾给出 WAL fsync P99 小于 10 ms、backend commit P99 小于 25 ms 的排障参考值,但硬件、版本和负载都在变化。我会把它们当成发现慢盘的起点,再以目标集群正常窗口的分位数和 API SLO 建立基线,而不是把两条数值写成不变的生产承诺。etcd FAQ 的磁盘排障说明
6.6 什么时候拆分 etcd
Kubernetes API Server 支持通过 --etcd-servers-overrides 把指定 group/resource 路由到另一组 etcd。官方大集群指南首先建议考虑把 Event 存入单独的 etcd,因为 Event 频繁写入且业务恢复价值与声明式对象不同。kube-apiserver 参数
拆分不是第一步。它增加了备份集合、版本升级、证书、监控、恢复顺序和一致性排障的复杂度。采用前要确认:
- 已经治理高频无效写入,单纯加硬件无法满足目标;
- 目标资源可以形成清晰的故障与恢复边界;
- 每个分片都有快照、恢复、容量和告警;
- API Server 参数、自动化安装与升级工具都能保持一致;
- 恢复演练覆盖“一个分片丢失”与“多个分片 revision 不一致”。
AWS 的 10 万节点案例把资源类型分布到多个 etcd 集群,是定制控制面的结果。自建集群不能只复制“多套 etcd”这一层,而忽略路由、恢复和运维系统。
6.7 备份成功不等于可以恢复
快照至少要记录 revision、hash、大小、etcd 版本、加密配置和保存时间,并用 etcdutl snapshot status 做完整性检查。恢复演练要关闭或隔离 API Server 写入,使用匹配版本的工具恢复,再重启控制面并完成 API、控制器和业务验收。etcd snapshot
恢复旧快照会让 revision 回退,Informer 可能仍持有“未来”状态。etcd 3.6 的恢复流程支持 revision bump 和 mark-compacted,用于让 Kubernetes 客户端重新建立缓存;bump 值要根据可能丢失的写入量计算并在演练中验证。etcd disaster recovery
我会分别记录三个时间:得到可用快照需要多久、恢复出 API 需要多久、业务协调完成需要多久。只报告 etcdutl restore 命令耗时,无法说明集群 RTO。
6.8 新版读取优化解决什么问题
Kubernetes 1.37 配合 etcd 3.7 后,可以使用默认开启的 Beta 特性 EtcdRangeStream。传统 unary Range 要在 etcd 内存中先组装完整响应;RangeStream 按值大小自适应分块,并让 API Server 边接收边解码,降低大资源集合在 watch cache 初始化和直接 LIST 时的内存峰值。可通过下面的计数确认流式读取确实发生:Kubernetes 1.37 RangeStream
RangeStream 改善大范围读取的内存行为,对高频 status 更新、Event、Lease、慢盘和 Raft 提交没有直接帮助。升级前仍需完成 etcd 版本兼容、回滚和规模测试;指标为零时,应检查 etcd 是否达到 3.7,以及 API Server 是否实际启用了对应 feature gate。
7. 调度器:减少无意义计算,保留放置质量
调度瓶颈通常落在队列、过滤、打分、扩展点或外部调度组件之一。优化前先按插件看耗时和失败原因,特别关注拓扑、亲和性、卷绑定和自定义 extender。简单批处理和复杂在线服务可以使用不同 scheduler profile,减少不需要的插件。
percentageOfNodesToScore 允许在找到足够可行节点后停止继续搜索。默认算法会随集群增大降低比例,5000 节点约为 10%,且存在最小可行节点数。继续压低比例可能提高吞吐,却会牺牲放置质量,尤其是资源碎片、拓扑和 GPU 约束明显时。Scheduler performance tuning
我的顺序是:
- 清理永远无法调度或持续反复入队的 Pod;
- 找出最昂贵且价值不足的插件与约束;
- 用 QueueingHints 等机制减少无关事件触发的重试;
- 拆分简单与复杂调度 profile;
- 最后在真实碎片模型下调整打分比例和并发。
只在空集群测每秒调度量,会掩盖长期运行后的碎片。压测数据需要包含真实节点标签、污点、资源分布、卷与拓扑约束,并在 50% 到 80% 利用率区间重复测试。
8. 网络与 DNS:控制对象传播,不只看数据面带宽
超大集群中的网络问题分两类:业务包是否能转发,以及网络控制对象能否及时收敛。Service、EndpointSlice、NetworkPolicy、路由和 DNS 记录的更新速度都要测量。
- 使用 EndpointSlice,按业务和控制器能力选择 slice 大小;默认每个 slice 最多 100 个 endpoint,可配置上限为 1000。EndpointSlice
- 评估 NodeLocal DNSCache,把重复查询留在节点,并以真实域名分布和缓存命中率估算内存;不能只按 Pod 数量配额。NodeLocal DNSCache
- CoreDNS 同时依据节点数、Pod 数和实际 QPS 扩展,验证缓存失效、滚动升级和上游 DNS 故障。
- Kubernetes 1.33 的 kube-proxy nftables 后端已稳定,数据结构和增量更新更适合大量 Service;迁移前必须验证内核、CNI、NetworkPolicy、监控和回滚路径,iptables 仍可能是现有集群默认方案。nftables kube-proxy
- Pod/Service CIDR、VPC 路由、ENI/IP、连接跟踪表和负载均衡配额要在建集群前算清,后补地址空间通常代价很高。Mobileye 的 3200 节点 EKS 案例也把 VPC、子网和 IP 规划列为核心约束。Mobileye EKS 扩展实践
DaemonSet 是常见放大器。10 个每节点 Agent 在一万节点上就是 10 万个 Pod;如果每个 Agent 都直接轮询 API Server,控制面压力会随节点数一起增长。优先让 Agent 读取节点本地数据,通过分层聚合器汇总,并对上报频率和失败重试设预算。
9. 用分层测试接近万节点
生产规模不能靠一次满载测试证明。测试体系需要从控制面模拟逐步走向真实节点:
| 层次 | 工具与环境 | 能证明什么 | 不能证明什么 |
|---|---|---|---|
| 资源模型与控制器测试 | KWOK、虚拟 kubelet或模拟节点 | API、etcd、控制器在大对象基数下的行为 | 真实 kubelet、CNI、CSI、内核和节点网络 |
| 上游规模负载 | ClusterLoader2 | API 响应、Pod 启动、调度吞吐、etcd 与资源用量 | 业务流量、复杂自定义控制器和特定硬件 |
| 对象 churn | kube-burner | 创建、删除、更新峰值与 Prometheus 证据 | 节点故障和真实数据面容量 |
| 真实节点阶梯 | 目标硬件 25% → 50% → 75% → 100% | 完整 kubelet、CNI、CSI、DNS 与业务路径 | 未覆盖的区域级故障和长期老化 |
ClusterLoader2 是 Kubernetes 上游的规模与性能框架;KWOK 适合快速制造节点和 Pod 对象;kube-burner 适合定义对象 churn 并采集 Prometheus 指标。三者用途不同,不应把模拟节点测试写成“万节点生产已经通过”。
每一级都至少包含四种场景:
- 稳态:目标对象基数和正常业务变化率;
- 变更:批量发布、DaemonSet rollout、控制器与 API Server 重启;
- 弹性:节点分批加入、退出和大批 Pod 创建;
- 故障:etcd follower/leader、网络抖动、慢盘、DNS、Webhook 与区域容量减少。
阶段推进条件应该同时覆盖 API SLO、etcd 磁盘和 Raft、调度、Pod 启动、DNS/Service 收敛与业务探针。观测缺失视为未知并停止扩大,不把它算成成功。
Cloudflare 曾使用 KubeVirt 创建包含数百节点和数千 Pod 的虚拟 Kubernetes 集群来发现只在规模下出现的问题。这种方法很适合 CI 中的控制面回归,但仍需要真实网络和节点测试补齐边界。Cloudflare KubeVirt 规模测试
10. 一套可执行的扩容节奏
我会把目标规模拆成“容量门禁”,而不是预先承诺某天直接达到一万节点。以下比例是方法示例,不是通用生产参数:
| 阶段 | 重点 | 必须保留的证据 | 停止条件示例 |
|---|---|---|---|
| 基线 | 当前生产规模与正常峰值 | 组件版本、请求画像、SLO、etcd 和业务基线 | 基线自身不稳定或指标缺失 |
| 25% 目标 | 对象模型与客户端治理 | 请求 Top N、LIST 大小、Watch 数、写入资源 | 新增大范围 LIST、etcd 磁盘尖峰 |
| 50% 目标 | 调度、DNS、EndpointSlice 与网络收敛 | 调度分位数、DNS QPS、Service 传播时间 | 尾延迟持续超标、放置质量下降 |
| 75% 目标 | 组件滚动与节点批量加入 | 发布时间线、APF、队列与自动停止记录 | 重试风暴、控制器 backlog 不恢复 |
| 100% 目标 | 故障与恢复、长期 churn | etcd 恢复、快照校验、业务 RPO/RTO | 无法在目标时间恢复或故障扩大 |
每次推进只改变一个主要变量,并保留配置、代码版本、原始指标和失败样本。规模实验中的失败不是需要删除的噪声,而是下一阶段门禁的来源。
11. 生产检查单
架构
- 已量化单集群减少的资源碎片或平台成本,而不是只追求节点数;
- 已比较多集群、托管超大规模和自建单集群;
- 业务能够接受单集群控制面、网络和升级故障半径;
- Pod/节点比例、对象数量和变更频率来自实际负载模型。
API 与控制器
- 已按用户、resource、verb、userAgent 统计请求与错误;
- 大 LIST 有范围、分页或 streaming 方案;
- 控制器缓存、Watch 和重试有边界;
- APF 通过命中和故障实验验证;
- Webhook 有限时、限范围、多副本和明确失败策略;
- 节点加入、DaemonSet rollout 和控制器重启分批执行。
etcd
- 已定位写入 Top N,并治理无变化 status、Event 和大 CRD;
- 使用低延迟专用存储、稳定网络和受保证的 CPU/内存;
- WAL fsync、backend commit、leader、proposal、DB size 与 peer RTT 已进入看板;
- compaction 与逐成员 defrag 有独立流程;
- quota 来自增长率和恢复测试,未用于掩盖泄漏;
- 快照经过校验,revision bump 与业务恢复完成过演练;
- 如果使用资源分片,每个 etcd 都有独立备份、监控和恢复顺序。
调度、网络与验证
- 调度压测包含真实资源碎片、拓扑、污点、卷和扩展插件;
- DNS、EndpointSlice、Service、NetworkPolicy 和路由收敛有目标;
- Pod/Service CIDR、节点网络、连接跟踪与云网络配额有余量;
- 模拟节点结论没有替代真实 kubelet、CNI 和 CSI 测试;
- 稳态、变更、弹性、故障和恢复均有原始证据与停止条件。
12. 我最终会怎么选
对于通用企业平台,我更愿意先把单集群控制在上游和自身持续验证的范围内,用多集群减少故障半径,再通过统一调度与容量视图解决碎片。对于 AI/HPC 场景,如果一台节点通常只运行一个大 Pod、调度约束相对稳定,而且拆集群会显著损失大规模作业的可用节点集合,我才会认真评估 5000 节点以上的单集群。
进入这条路线以后,优化工作不再是“把 API Server 内存加大”。平台要能够解释每一种控制面流量,控制节点和对象进入速度,让 etcd 在磁盘、网络和恢复上有明确余量,并把调度、DNS、CNI、CSI 和业务恢复放进同一套规模门禁。达到一万节点只是阶段结果;在发布、扩容和故障时仍能停下来并恢复,才是这套系统真正可用的证据。
参考资料
- Kubernetes:Considerations for large clusters
- Kubernetes SIG Scalability:Thresholds
- Kubernetes perf-tests:ClusterLoader2
- etcd v3.6:Tuning
- etcd v3.6:Maintenance
- etcd v3.6:Disaster recovery
- OpenAI:Scaling Kubernetes to 7,500 Nodes
- Uber:Migrating the Compute Platform to Kubernetes
- AWS:Amazon EKS Ultra-Scale Clusters
- 阿里巴巴:万级规模 Kubernetes 控制面性能优化
- 蚂蚁金服:从零到破万节点的 Kubernetes 集群实践
- 阿里巴巴 ASI:超大规模 Kubernetes 全托管运维体系
- 字节跳动:Kubernetes 集群 2 万以上节点性能优化分享
- 字节跳动:从混合部署到融合调度
- KubeWharf:KubeGateway
- KubeWharf:KubeBrain
- KubeWharf:Gödel Scheduler