大规模 Kubernetes 监控方案:Prometheus、VictoriaMetrics、Thanos 与 Mimir 怎么选
几百个 Kubernetes 集群或者上万台节点的监控,真正困难的通常不是“有没有曲线”,而是监控自己也成为了一套大型生产系统:采集器连接 API Server,指标进入存储,查询跨多个集群展开,告警又依赖这条链路。
讨论 Prometheus 和 VictoriaMetrics 时,需要先明确比较范围。Prometheus 同时负责采集、本地存储、查询和规则计算;VictoriaMetrics 可以只作为远端时序存储,也可以通过 vmagent、vmalert 等组件组合成完整监控系统。 两者可以共存,不必从一开始就作全量替换。
我的选型顺序是:先核算序列和样本规模,再决定本地与中心的职责,随后比较存储和查询成本,最后验证故障恢复。节点数只是入口,不能直接推导“超过多少节点就必须换数据库”。
1. 把监控拆成六层
| 层次 | 常见组件 | 大规模下要回答的问题 |
|---|---|---|
| 指标来源 | kubelet、cAdvisor、node-exporter、kube-state-metrics、控制面、业务埋点 | 是否重复采集,标签是否无界增长 |
| 服务发现与采集 | Prometheus、Prometheus Agent、vmagent、Grafana Alloy | LIST/WATCH 会给 API Server 多大压力 |
| 写入与缓冲 | Remote Write、WAL、采集器磁盘队列 | 中心不可用多久还能保住数据 |
| 时序存储 | Prometheus TSDB、VictoriaMetrics、Thanos/Mimir 存储链路 | 保留期、复制、备份、扩容与磁盘故障 |
| 查询与规则 | PromQL/MetricsQL、查询前端、Ruler、vmalert | 查询是否挤占告警,跨集群规则如何执行 |
| 告警与展示 | Alertmanager、Grafana、值班系统 | 故障时是否还能看到并收到有效告警 |
TSDB 是 Time Series Database,即时序数据库;WAL 是 Write-Ahead Log,即预写日志;Remote Write 是把采集到的样本发送给远端存储的接口。它们分别解决存储、崩溃恢复和数据传输,不能互相替代。
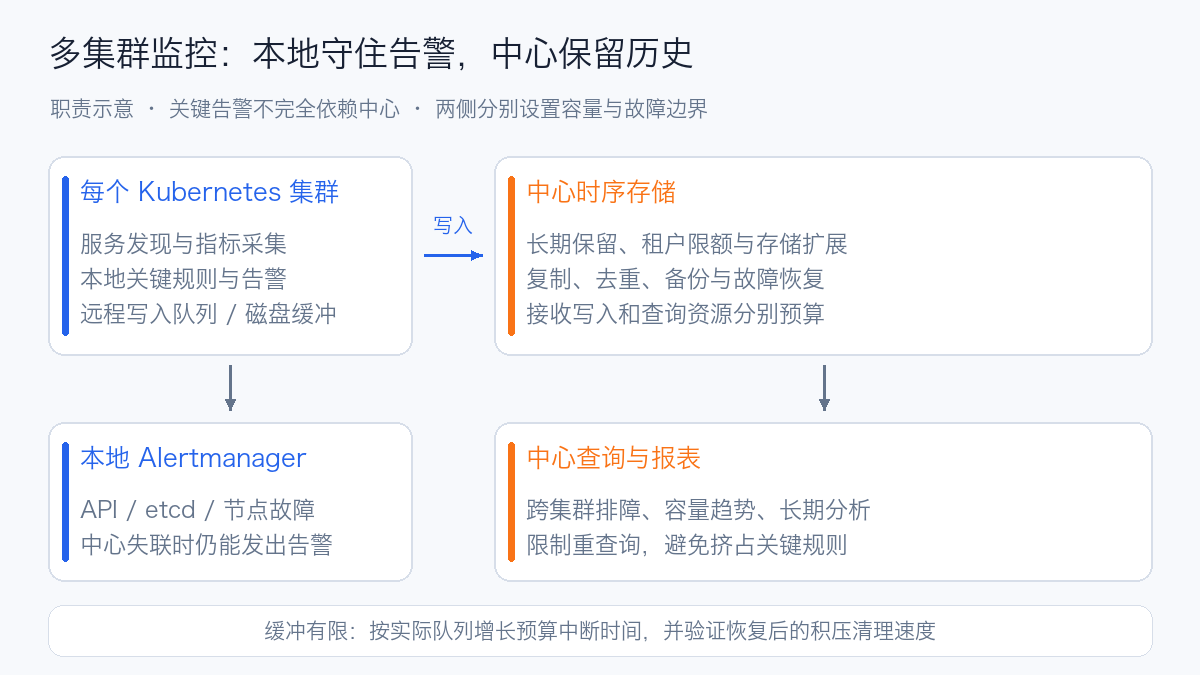
对多集群平台,我倾向于保留集群本地的关键告警,中心负责长期数据、跨集群分析和容量报表。这样中心网络或数据库异常时,不会同时失去全部集群的 API Server、etcd 和节点故障告警。
只部署 Agent 并把所有规则放在中心也可以,但必须把“中心故障后告警不可用”计入架构取舍。Agent 不具备完整 Prometheus Server 的本地查询和规则能力。Prometheus Agent Mode
2. 容量模型:看序列、样本和变化率
每一种指标名称与完整标签组合构成一条时间序列。对大规模监控,我至少会核算六个数:
| 数据 | 用途 |
|---|---|
| 活跃序列数 | 估算内存、索引与缓存压力 |
| 每秒新建序列数 | 识别短生命周期 Pod 和高基数标签造成的 churn |
| 每秒写入样本数 | 估算网络、写入和压缩吞吐 |
| 单个采集响应大小 | 识别大 exporter、超时和响应上限 |
| 查询触及的序列与时间范围 | 评估查询展开量和资源隔离 |
| 规则数量及单次计算成本 | 判断规则是否能按时完成 |
Churn 指序列持续创建与消失的变化。两个系统都有 1000 万活跃序列,一个由长期稳定节点产生,另一个不停创建短 Job 和新 Pod,索引与缓存成本可能相差很大。
下面是一组假设输入,用于理解数量级,不是本地压测:
“每节点等效序列”已经折算节点、容器、对象与业务指标,不能再把这些类别重复相加。容量预算应从真实样本测出这个值,不能直接照搬 5000。
Prometheus 文档给出压缩存储平均约 1–2 字节/样本的粗略参考。沿用这组假设,仅样本压缩量约 144–288 GB/天,30 天约 4.32–8.64 TB,采用十进制单位。这个估算没有替代对索引、WAL、Head、复制和查询临时空间的测量。Prometheus 存储容量估算
经典 histogram 会额外产生多个 _bucket、_sum、_count 序列。若保留 10 个 bucket、20 种路由、5 种方法、4 类状态码,一个实例理论组合可达 12 × 20 × 5 × 4 = 4800 条;实际只计算产生过的组合。把用户 ID、请求 ID 或完整 URL 放进标签后,节点数不变,序列也能快速膨胀。Prometheus 指标设计
3. 四条主流路线放在同一张表里
| 路线 | 主要优势 | 扩展方式 | 需要承担的成本 |
|---|---|---|---|
| 本地 Prometheus + kube-prometheus-stack | Kubernetes 规则与社区生态成熟,采集、查询、告警直接 | 按职责/目标分片,各片独立副本 | 本地 TSDB 不组成共享存储集群;跨片查询与规则需要额外方案 |
| Prometheus + Thanos | 保留 Prometheus,增加统一查询与对象存储长期保留 | Query、Store Gateway、Compactor、Ruler 等按职责部署 | 组件和对象存储治理;近期数据仍依赖在线采集/接收链路 |
| Prometheus/Agent/vmagent + VictoriaMetrics | 采集与存储解耦,可从单机起步;存储集群拆分写、存、查 | VMSingle,或 vminsert/vmstorage/vmselect 集群 | 复制、去重、标签治理、查询语义和故障域需要明确配置 |
| Prometheus/Alloy + Grafana Mimir | 多租户、配额、集中存储与查询治理能力完整 | 分布式组件、对象存储;新架构可引入 Kafka | 运维依赖较多,版本与部署架构影响故障模型 |
这张表比较的是系统形态,没有宣称某个产品天然快十倍或者只占十分之一内存。这样的结论必须使用同样的序列、标签、采集间隔、保留期、复制数与查询负载实测。
3.1 Prometheus:单机存储不等于只能监控小集群
Prometheus 可以通过功能分片和目标分片扩大采集范围。Prometheus Operator 支持按目标分片,副本用于高可用;增加副本不会把单实例负载平均拆开。跨分片查询和规则通常再由 Thanos 等汇总。Prometheus Operator 高可用与分片
我会先尝试按控制面、节点、Kubernetes 对象和业务指标分开。不同类别的采集间隔、标签预算和告警重要性不同,按职责分片更容易理解和排障。如果单个目标自身很大,只增加目标分片数也无法把这个响应自动拆成几份。
Prometheus 本地 TSDB 不提供跨节点复制。两台相同配置的 Prometheus 是两份独立数据,抓取时刻也可能不同,统一查询需要去重;不要让多个副本共享同一个数据目录。Prometheus 本地存储
3.2 Thanos:保留 Prometheus,扩展长期查询
Thanos Sidecar 可以提供近期数据查询,并上传 Prometheus 生成的块到对象存储。Query 汇总多个来源,Store Gateway 读取历史块,Compactor 进行压缩等维护,Ruler 提供规则计算。Thanos Sidecar、Thanos Query、Thanos Compactor
其重要边界是:对象存储已有历史块,不代表最新数据也已经安全上传。 Sidecar 模式的上传取决于块生成和上传进度,故障验证要覆盖近期数据来源失联、Store Gateway 延迟与 Compactor 积压。
已有大量 Prometheus 规则和本地告警,希望逐步统一历史查询的团队,通常适合先评估这条路线。使用 Thanos Receive 接收远程写入是另一种拓扑,不能套用 Sidecar 的全部容量和恢复假设。
3.3 VictoriaMetrics:区分单机与集群
VMSingle 用一个服务完成时序存储和查询,适合起步和隔离单元。集群版则拆成:
vminsert:接收写入,并按序列路由到存储节点;vmstorage:保存样本、维护索引;vmselect:执行查询,从存储节点读取并合并数据。
拆分后可以分别扩容,但“多个 vmstorage”默认不等于每条样本已有多个副本。复制系数、故障时重路由和查询部分结果都需要单独验证。VictoriaMetrics 集群架构
vmagent 负责发现、采集、过滤和远端写入,可以配置磁盘缓冲;vmalert 执行规则,告警交给 Alertmanager。不要因为存储部署成功就认为这条链路都已验收。vmagent、vmalert
VictoriaMetrics 使用 MetricsQL,支持大量 PromQL 用法,但对 rate、increase、隐式窗口等存在语义差异。仪表盘显示了数字,只能证明查询跑通;迁移还应比较固定时间范围下的关键查询与告警边界。MetricsQL 与 PromQL 的差异
3.4 Mimir:多租户能力与架构依赖一起评估
Mimir 适合中心化多租户场景,可以对租户写入、序列和查询设置限制,并通过对象存储保留历史数据。它也支持不同架构,不能把所有版本都描述成相同链路。
官方将 Mimir 3.0 起稳定的 ingest storage 架构作为推荐路线:写入通过 Kafka 持久化,Ingester 异步消费并生成可查询数据和存储块。写、读路径解耦,但引入了 Kafka 的容量、复制与消费延迟治理;写入确认和立即查询可见也不是同一件事。Mimir ingest storage 架构
已有 classic 架构则要按其 Distributor/Ingester、WAL 和复制模型评估。采用时记录实际版本、部署模式和数据路径,而不是只写“Mimir 高可用”。Mimir Ingester
4. 比数据库更早遇到的瓶颈:服务发现
监控不是旁观者。每个发现客户端都可能 LIST/WATCH Pod、Node、EndpointSlice 等资源,接收对象、反序列化并维护缓存。大批采集器同时重启,可能形成比稳态写入更明显的控制面压力。
尤其要区分三种过滤:
| 过滤位置 | 能减少什么 | 不能自动减少什么 |
|---|---|---|
| Kubernetes 服务发现的 namespace / label / field selector | API 返回对象与 Watch 范围,取决于 discovery role 和配置 | 已经创建的其他独立 Watch |
| target relabeling | 实际抓取目标 | 过滤发生前已收到的发现对象 |
| metric relabeling | 入库序列与样本 | 已经抓取响应和解析所付出的成本 |
因此“只保留十个目标”不一定意味着只发现十个对象。配置时检查生成后的 kubernetes_sd_configs,不要只看 ServiceMonitor 的表面数量。Prometheus Kubernetes SD 配置
kube-state-metrics 也要单独核算。它读取对象状态并生成指标,水平分片并不保证 API Server 的发现压力等比例下降:官方说明分片实例仍需要监听全部相关对象,再按分片分配处理。可以结合命名空间划分、资源白名单与标签白名单控制范围。kube-state-metrics 分片
对多集群中心,我更倾向于本地发现、本地采集,中心接收 Remote Write。中心直接 Watch 全部生产集群并非不可行,但它需要持有更多集群凭据,同时承担跨机房发现与重连风暴。
5. 序列治理与查询隔离
我的标签约定会保留 cluster、环境、区域和租户等稳定维度,禁止把请求 ID、用户 ID、随机 session 和完整动态 URL 直接做指标标签。Pod 名称、UID 等生命周期维度按诊断需要保留,并分配明确预算。
不能只把 UID 删除就算治理完成:如果原本依赖它区分不同对象,去掉后可能形成同一条序列的冲突或乱序。应从埋点、对象语义和采集配置共同减少基数。
查询侧把负载分成三类:
| 类型 | 处理方式 |
|---|---|
| 告警与核心 SLO | 固定窗口和聚合维度,独立预算,优先保障按期计算 |
| 值班排障 | 限制默认集群、时间范围和查询展开,允许逐步下钻 |
| 月度容量报表 | 预计算或降采样,控制并发,避开实时告警资源 |
SLO 是 Service Level Objective,即服务水平目标。对一小时 API 错误率告警,不应每 30 秒扫描全公司所有 Pod 的三十天原始序列。
Recording Rule(记录规则)用于预计算常见聚合;流式聚合则可以在入库前降低数据量。后者会牺牲原始细节,而且同一聚合组的数据必须正确汇聚。Histogram 的 bucket 需要先按相同边界聚合,再算分位数,不能把各节点 P99 相加或求平均。Prometheus 记录规则、VictoriaMetrics 流式聚合
6. 高可用、去重和备份是三件事
高可用(High Availability,HA)解决故障后能否继续提供服务;去重解决重复样本的查询口径;备份解决数据被删除、损坏或整个故障域丢失后的恢复。两个副本并不能代替备份。
双采集副本会增加 exporter、网络和存储成本。副本标签如何处理也必须明确:Thanos 可配置用于查询去重的 replica label;VictoriaMetrics 去重要求落入相同序列身份,并设置合适去重窗口。若两个采集副本仍带不同 replica 标签,它们就是不同序列,不能只加一个去重参数就承诺结果正确。Thanos Query 去重、VictoriaMetrics 去重
采集器本地缓冲也不是无限的数据保险箱。需要测量:
不要把数据库压缩后的“字节/样本”直接套给发送队列。队列编码、批量压缩、标签、重试和双写都会改变实际大小,上面的公式也只是磁盘预算上界,还受组件版本、WAL 保留与淘汰策略限制。恢复发送能力必须高于新增速率,否则中心恢复了,积压仍然清不完。Prometheus Remote Write 调优、vmagent 磁盘缓冲
故障评审中明确恢复点目标(Recovery Point Objective,RPO,允许丢多少数据)和恢复时间目标(Recovery Time Objective,RTO,多久恢复服务)。HTTP 写入确认、查询可见、磁盘持久化与异地备份是不同阶段,要用所选版本的实现和实测故障结果确认边界。
7. 存储:先确认故障域,再谈保留期
Prometheus 文档明确不支持 NFS/EFS 作为本地 TSDB 文件系统,并建议本地文件系统。不要为了多副本方便,给所有 Prometheus 挂一个共享目录。Prometheus 文件系统要求
生产评估重点包括磁盘吞吐、随机读、压缩期间空间、WAL 回放和恢复查询。SSD/NVMe 往往能改善这些路径,但效果仍取决于索引、查询和磁盘画像。
使用 Local PersistentVolume 时,Pod 重建通常仍受原节点约束。PVC 能保持数据,不等于原节点故障后可以立即在其他节点挂载。VictoriaMetrics 存储集群需要按存储故障域配置复制和节点布局;Thanos/Mimir 的对象存储也需要自身容量、权限、生命周期和可用性治理。
保留期应区分短期排障与长期报表。默认把所有容器级原始指标留一年,往往比改数据库更快耗尽预算。原始数据保留多久、聚合数据保留多久、删除责任归谁,都应成为平台配置的一部分。
8. 一次 VictoriaMetrics K8s Stack 的部署验证
为了检查完整链路,我在一个 Kubernetes v1.30.4、12 节点的实验集群部署了独立的 VictoriaMetrics K8s Stack,并保留原有监控。这里验证的是集成与可用性,不是 Prometheus/VM 的公平性能对比,也不是万节点容量测试。
| 项目 | 验证结果 |
|---|---|
| Helm Chart | victoria-metrics-k8s-stack 0.95.2 |
| VictoriaMetrics / Operator | v1.153.0 / v0.75.0 |
| Grafana | 13.2.3,实验入口匿名只读 |
| 存储 | VMSingle,14 天保留,20 GiB PVC;Grafana 2 GiB PVC |
| 采集间隔 | 30 秒 |
| 默认看板 | 44 个,包括 Kubernetes、控制面、etcd 与 VM 自监控 |
| 规则 | 39 组、270 条,验收时无执行错误 |
| 采集目标 | 75 个,71 个正常;4 个失败目标属于同一台既有离线节点 |
| 覆盖 | API Server、etcd、scheduler、controller-manager、kubelet、CoreDNS、对象与节点指标 |
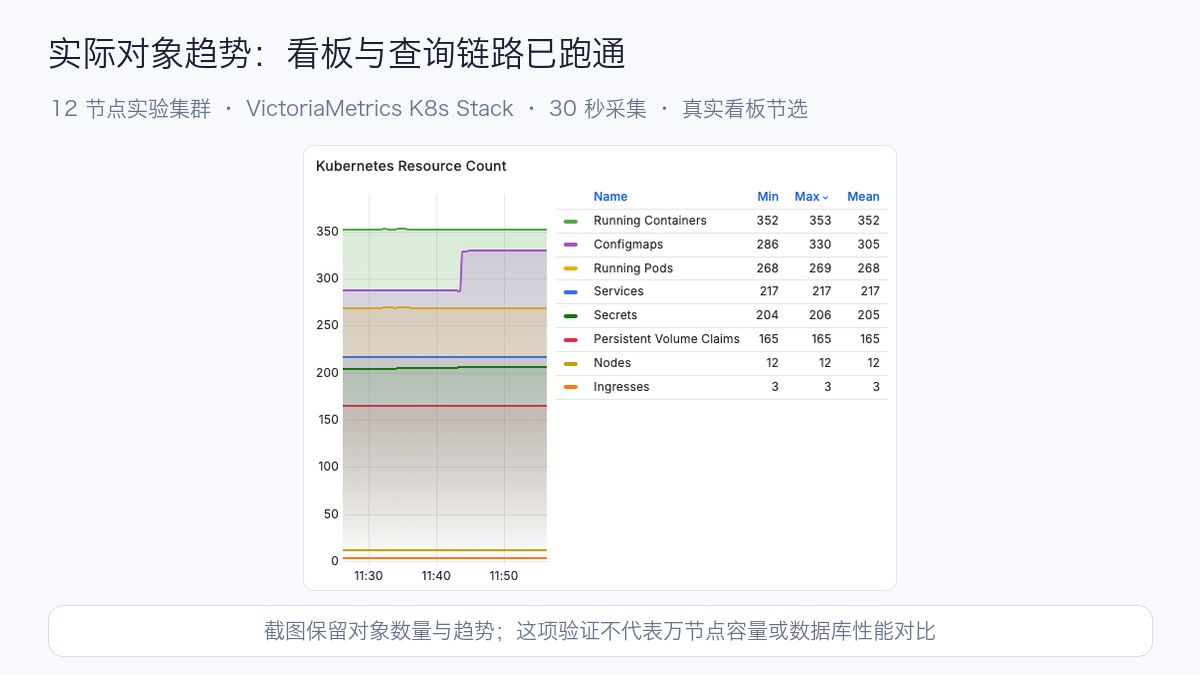
这次部署暴露了三个值得验收的细节:
第一,Dashboard 导入失败与数据库故障是两类问题。 环境能访问部分镜像仓库,但在线同步任务无法下载 GitHub 原始文件。最后在可访问网络的客户端下载来源,使用官方 sync-job 的本地输入与输出模式生成 ConfigMap 和规则,再导入集群。大型 node-exporter 看板超过客户端 apply 的注解大小限制,改用 Server-Side Apply(服务端应用)完成导入。
第二,采集 Pod Running 不代表发现范围正确。 最初 namespace 范围与权限使发现被限制在监控命名空间,控制面目标没有正确覆盖。调整独立采集器的发现与 RBAC(Role-Based Access Control,基于角色的访问控制)后,逐个核对 targets、up 和代表性查询。
第三,指标响应也有大小上限。 API Server /metrics 超过 vmagent 默认 16 MiB 限制,目标发现成功却抓取失败。按实际组件配置把该目标的 max_scrape_size 调到 64 MiB 后采集恢复。长期仍要治理指标和标签规模,不能无限增加上限。
最后实际打开免登录 Grafana 看板,确认数据源、图表和查询能工作。默认看板也需要检查分母与覆盖范围:node-exporter、kube-state-metrics 和 cAdvisor 的节点集合可能不同,不能把其中两台节点的容量当成全体十二台节点的容量。本文截图只展示已核对的对象数量面板。
默认 Alertmanager 接收器尚未接入通知渠道,因此“规则执行成功”不代表告警已送达。生产交付还要做通知验证、权限、备份恢复和配置更新验收。VictoriaMetrics K8s Stack、官方 sync-job 本地生成方式
9. 从现有 Prometheus 迁移,先双写验证
我更倾向于分阶段迁移,避免同时换采集器、标签、数据库和告警规则:
- 保留原有采集、告警与短期存储,增加向新后端的写入。
- 确认
cluster、租户、实例和 replica 标签,明确去重口径。 - 双数据源比较固定时间范围的错误率、吞吐、CPU、直方图分位数和对象数量。
- 验证 counter reset、缺失样本、staleness、原生 histogram、exemplar 与 Remote Write 协议的版本兼容;只测实际准备使用的能力。
- 做远端故障、队列满、进程重启、查询过载和备份恢复测试。
- 先迁移报表,再迁移关键规则;原链路保留回滚窗口。
Staleness 指序列失效的语义;exemplar 是指标与具体请求/Trace 关联的样本。对需要这些能力的团队,要核对两端实际版本和数据格式,不能把“Prometheus 兼容”理解成所有协议细节都完全一致。
若已用 kube-prometheus-stack 管理生产监控,新增写入或采集应基于当前线上完整 values做增量变更,保留已有 GPU、控制面、etcd 和自定义规则。升级前后比较 job、Secret 引用与 targets,而不是拿一份新的最小配置覆盖整个 release。
10. 我会怎样做选型
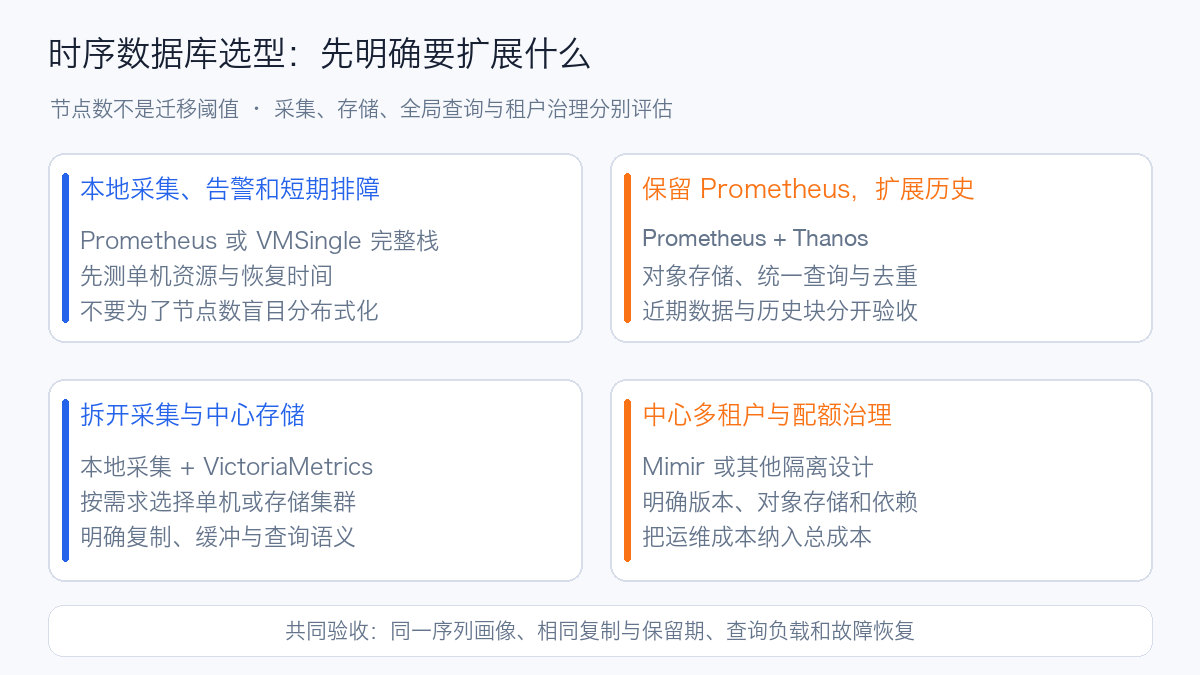
| 环境与主要需求 | 优先评估 | 决策依据 |
|---|---|---|
| 单集群、负载可控、短期告警排障 | 本地 Prometheus 或 VMSingle 完整栈 | 团队熟悉度、实际内存/磁盘与恢复时间 |
| 大量既有 Prometheus,希望长期统一查询 | Prometheus + Thanos | 复用规则、对象存储与全局查询成本 |
| 多集群中心化写入,希望渐进扩展存储 | 本地采集 + VictoriaMetrics | 同画像下写入、查询、资源、复制与维护成本 |
| 强租户隔离、中心配额与复杂查询治理 | Mimir 或经过隔离设计的其他中心方案 | 租户限额、读写架构、对象存储及依赖运维能力 |
| 集群自治、跨机房链路不可靠 | 本地关键规则 + 有限缓冲 + 中心长期数据 | 断网期间能否告警、数据损失与积压清理时间 |
选择 Prometheus,通常是选择成熟的本地采集与告警生态;选择 VictoriaMetrics,往往是为了调整存储与采集的分工,并用实测成本决定单机还是集群。Thanos 和 Mimir 则分别提供保留 Prometheus 生态与中心分布式治理的路线。
最终验收不能只看压缩率。我要的是:正常时查询和规则按时完成,中心故障时集群仍能告警,恢复后积压能清空,存储丢失后能按约定恢复,而且这套系统不会为了监控 Kubernetes 反过来压垮它的 API Server。