Koordinator Webhook 多副本证书竞态实战:从每秒 60 次 409 到共享 CA 收敛
一个千节点级、运行数万个 Pod 的生产集群,API Server 长期维持在每秒千次左右的请求量。业务没有明显增长,控制面却持续出现两组异常:
MutatingWebhookConfiguration和ValidatingWebhookConfiguration被高频读取、更新;- 更新请求不断返回 HTTP 409,五成员 etcd 同期存在较高的 Backend Commit P99 和 Slow Apply。
最终定位到 Koordinator Webhook 的证书管理:8 个 koord-manager 副本各自在本地生成一套自签 CA,同时修改全局 WebhookConfiguration。多个副本相互覆盖 caBundle,形成“配置变化 → Informer 事件 → 再次同步 → 再次更新”的循环。
这次修复没有更换 Koordinator,也没有扩容 API Server 或 etcd。我们先预置一套共享证书,把证书 Writer 显式切换为 Secret 模式,再滚动更新 8 个副本。变更后,WebhookConfiguration 的 PUT 和 409 都降为 0,直接写放大被消除。
这里有一个决定问题边界的环境背景:这个集群没有为该 Webhook 调用链提供可由 API Server 使用的 Kubernetes Service 入口。 标准 Kubernetes 部署通常在 clientConfig.service 中引用 Webhook Service,由集群内 Service 网络完成发现和转发;本环境受历史架构和网络路径限制,需要经过内部负载均衡组件访问 Webhook,因此配置了 webhook_host。这是一项环境适配,不是标准 Kubernetes Webhook 部署方式。
问题也因此不能概括成“Koordinator Webhook 多副本一定会发生证书竞态”。更准确的触发条件是:非标准的外部 Host 访问路径、本次镜像对证书 Writer 的默认选择,以及多副本共同维护全局 caBundle 三者叠加。其他环境若使用标准 Service 路径、显式共享证书,或由唯一控制器维护 CA,不会自然复现这次问题。本文的通用价值在于排查方法:从异常 API 请求定位写入对象,再核对多副本证书、对象版本、Leader 边界和全局配置所有权。
本文来自真实生产处理。集群名、域名、IP、实例名、账号和内部系统导航均已删除或替换;Grafana 图片保留原始曲线、坐标和时间关系,没有重绘数据。
1. 先看最有辨识度的指标
单看 API Server 总 QPS,很容易把问题归因于“集群规模大”。真正有辨识度的是按 resource + verb + code 拆分请求。
变更前,两类 WebhookConfiguration 合计约有:
| 请求 | 5 分钟平均 | 正常情况下应有的形态 |
|---|---|---|
| GET | 157.0 次/秒 | 配置稳定后应接近 0,仅保留低频同步 |
| PUT 尝试 | 82.4 次/秒 | 只应在证书或规则实际变化时出现 |
| PUT 409 | 60.1 次/秒 | 应为 0 |
| PUT 200 | 22.3 次/秒 | 稳定期也应接近 0 |
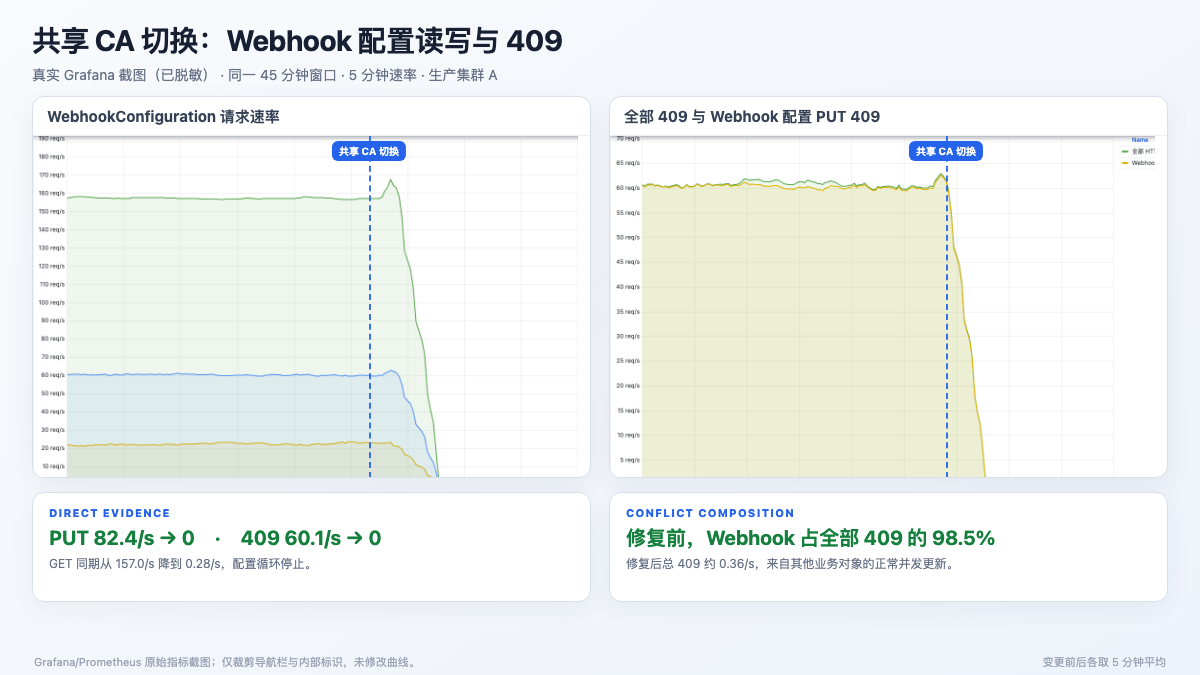
每秒 60 次 409 不是普通业务对象的偶发并发更新,而是多个控制器在争抢同一组集群级配置对象。继续增加控制器副本只会放大冲突。
右图还回答了一个关键问题:这些 409 到底是不是普通控制器冲突。修复前,Webhook 配置 PUT 409 约占全部 API Server 409 的 98.5%;修复后 Webhook 409 归零,总 409 只剩约 0.36/s。异常冲突的来源和修复对象能够直接对应起来。
下面是变更窗口内的真实 Grafana 曲线。API Server 总 QPS 从 1,071.1/s 降到 774.8/s,写请求从 501.0/s 降到 397.7/s,读请求从 570.1/s 降到 377.1/s。
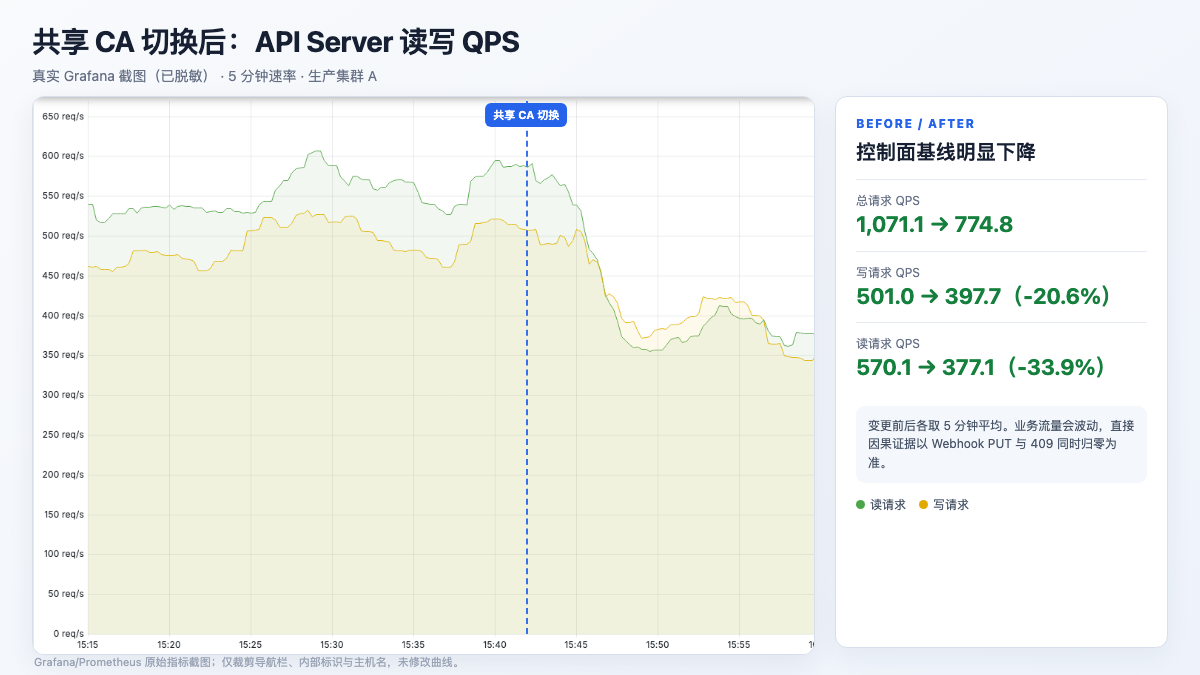
总 QPS 的下降只能作为相关证据,因为同一时间段的业务流量也可能变化。更强的因果证据是:切换后两类 WebhookConfiguration 的 PUT 和 409 同时归零,GET 降至 0.28/s,配置对象的 generation 与 resourceVersion 随后保持稳定。
2. 为什么 8 个副本会产生 8 套 CA
Koordinator 的 Webhook 不只提供 Admission HTTP 服务,还需要准备服务端证书,并把签发该证书的 CA 写入 MutatingWebhookConfiguration 和 ValidatingWebhookConfiguration 的 caBundle。
本次运行镜像存在两种证书 Writer:
| Writer | 证书保存位置 | 多副本结果 |
|---|---|---|
fs |
每个 Pod 的本地文件系统 | 每个副本可能得到不同 CA |
secret |
Kubernetes Secret | 所有副本读取同一份 CA 和服务端证书 |
本次之所以配置外部 Webhook Host,是因为该环境无法让 API Server 通过标准 Kubernetes Service 路径访问 Webhook,只能借助内部负载均衡入口完成转发。webhook_host 解决的是这个特殊环境中的可达性问题;它不应被当作通用部署模板。
在这一前提下,当部署配置了外部 Webhook Host,又没有显式指定 Writer 时,本次镜像选择了文件 Writer。8 个 Pod 的临时目录彼此隔离,于是每个副本都生成自己的 CA。与此同时,证书与 WebhookConfiguration 同步逻辑并不只在 Leader 上执行,各副本都尝试把自己的 CA 写入同一个全局对象。
koord-manager-1 ── CA-1 ─┐
koord-manager-2 ── CA-2 ─┼──> 同一个 WebhookConfiguration.caBundle
koord-manager-3 ── CA-3 ─┤
...                       │
koord-manager-8 ── CA-8 ─┘
这会同时造成三个问题:
- 写冲突。 多个副本基于旧
resourceVersion更新同一对象,API Server 返回 409。 - 信任根抖动。
caBundle最终只能保存一个有效信任根;后一次写入会覆盖前一次。 - 准入结果不稳定。 API Server 通过 VIP 或负载均衡访问随机后端时,当前
caBundle未必能验证该后端证书。
如果 Webhook 配置了 failurePolicy: Ignore,TLS 错误或调用失败时请求可能继续执行。这降低了 Webhook 故障阻塞业务的风险,却也意味着部分对象可能没有经过预期的变更或校验。Kubernetes 官方把 Ignore 定义为调用错误时放行,把 Fail 定义为调用错误时拒绝;两者都需要结合业务语义设计,而不是简单选择“可用性更高”的一项。Dynamic Admission Control · Admission Webhook Good Practices
需要强调的是,这个结论针对本次运行镜像、非标准访问路径和部署参数,不能据此认定所有 Koordinator 版本都会出现同样问题。当前社区代码仍展示了文件 Writer 与 Secret Writer 的选择逻辑,Secret Writer 会把证书保存在 Kubernetes Secret 中;实际处理时仍应核对自己镜像内的二进制、Helm Values 和源码版本。Koordinator Webhook Controller 源码 · Koordinator writer package
3. 定位时建立的证据链
3.1 按资源拆 API Server 请求
先确认异常写入来自哪个对象,而不是只看总 QPS:
sum by (resource, verb, code) (
  rate(apiserver_request_total{
    resource=~"mutatingwebhookconfigurations|validatingwebhookconfigurations"
  }[5m])
)
如果 PUT 409 长期存在,再按 client、userAgent 或审计日志定位写入者。不同 Kubernetes 版本和监控栈的标签可能不同,应先查看原始时间序列。
3.2 连续观察 generation 与 resourceVersion
kubectl get mutatingwebhookconfiguration <mutating-name> \
  -o jsonpath='{.metadata.generation}{" "}{.metadata.resourceVersion}{"\n"}'

kubectl get validatingwebhookconfiguration <validating-name> \
  -o jsonpath='{.metadata.generation}{" "}{.metadata.resourceVersion}{"\n"}'
间隔数秒执行多次。如果规则、Selector 和 CA 都没有人为变化,generation 或 resourceVersion 却持续增长,就需要找出哪个控制器在重复写入。
3.3 分别计算配置 CA 和 Pod CA 的哈希
# 配置对象中的 caBundle,实际脚本应遍历全部 webhooks
kubectl get mutatingwebhookconfiguration <mutating-name> \
  -o jsonpath='{.webhooks[0].clientConfig.caBundle}' \
  | base64 -d | sha256sum

# 每个 Pod 内的证书目录以实际镜像为准
kubectl -n <namespace> exec <manager-pod> -- \
  sha256sum <cert-dir>/ca-cert.pem <cert-dir>/cert.pem
本次检查发现 8 个 Pod 的 CA 哈希各不相同,而且配置对象中的 CA 随更新者变化。这个证据比“日志里有证书报错”更直接。
3.4 检查非 Leader 副本是否也在同步证书
kubectl -n <namespace> logs <manager-pod> --since=10m \
  | grep -E 'sync webhook certs|object has been modified|ensure configuration'
如果未持有 Leader Lease 的副本仍持续输出证书和配置同步日志,就不能假设 Leader Election 已经保护了这条路径。
3.5 不要只做一次 Pod dry-run
kubectl apply --dry-run=server 成功,只能证明那一次请求没有被拒绝。使用 failurePolicy: Ignore 时,即使 Webhook TLS 校验失败,请求也可能成功。验收还需要结合:
- Admission Webhook 调用失败、Fail-open 或拒绝指标;
- API Server 日志中的 TLS、x509、timeout;
- 通过负载均衡入口连续访问,覆盖所有后端;
- 检查业务对象是否真的得到预期 mutation 或 validation。
4. 修复:让所有副本使用同一个 Secret
我们先准备一套已经验证过 SAN、用途和密钥匹配关系的服务端证书,再写入共享 Secret。然后显式设置 Writer 类型和 Secret 名称:
本次镜像的 SecretCertWriter 通过 Kubernetes API 读取 Secret,再把证书写入容器原有的证书目录,因此不需要额外挂载 Secret Volume。这个行为不是 Kubernetes 的通用约定;其他版本或其他 Webhook 实现可能要求只读挂载。上线前必须检查当前镜像实现,不能根据变量名推断。
共享证书至少需要满足下面的检查:
# CA 能验证服务端证书
openssl verify -CAfile ca-cert.pem cert.pem

# 私钥和证书公钥一致
openssl x509 -in cert.pem -pubkey -noout | sha256sum
openssl pkey -in key.pem -pubout       | sha256sum

# 检查 SAN、用途、签发者和有效期
openssl x509 -in cert.pem -noout -text \
  | grep -A2 -E 'Subject Alternative Name|Extended Key Usage'
openssl x509 -in cert.pem -noout -subject -issuer -dates
如果 WebhookConfiguration 使用 clientConfig.service,SAN 通常需要覆盖对应 Service DNS;如果使用 clientConfig.url 指向外部 VIP 或域名,则证书必须覆盖该 URL 中的主机名或 IP。服务端证书需要 Server Authentication 用途,caBundle 必须能验证完整证书链。
滚动更新采用 maxUnavailable: 0,顺序是:
- 先创建并验证共享 Secret;
- 确认 ServiceAccount 有读取该 Secret 的最小权限;
- 更新 Deployment 的两个环境变量;
- 逐个替换 Pod,等待新副本 Ready 后再继续;
- 检查负载均衡后端已经摘除旧 Pod;
- 完成全部副本的证书哈希、配置 CA 和 TLS 验收。
5. 修复后的结果
变更前后都取 5 分钟平均值。直接与本次修复相关的指标和控制面整体指标分开列出:
| 指标 | 变更前 | 变更后 | 判断 |
|---|---|---|---|
| WebhookConfiguration GET | 157.0/s | 0.28/s | 下降 99.8% |
| WebhookConfiguration PUT 尝试 | 82.4/s | 0 | 直接写放大消失 |
| WebhookConfiguration PUT 409 | 60.1/s | 0 | 多写者冲突消失 |
| API Server 总 QPS | 1,071.1/s | 774.8/s | 下降 27.7%,含业务波动 |
| API Server 写 QPS | 501.0/s | 397.7/s | 下降 20.6%,含业务波动 |
| API Server CPU 汇总 | 10.95 核 | 8.73 核 | 下降 20.3%,含业务波动 |
| API 核心请求 P99 | 144.7 ms | 152.6 ms | 没有改善 |
| API 5xx / 429 | 0 / 0 | 0 / 0 | 服务可用性保持稳定 |
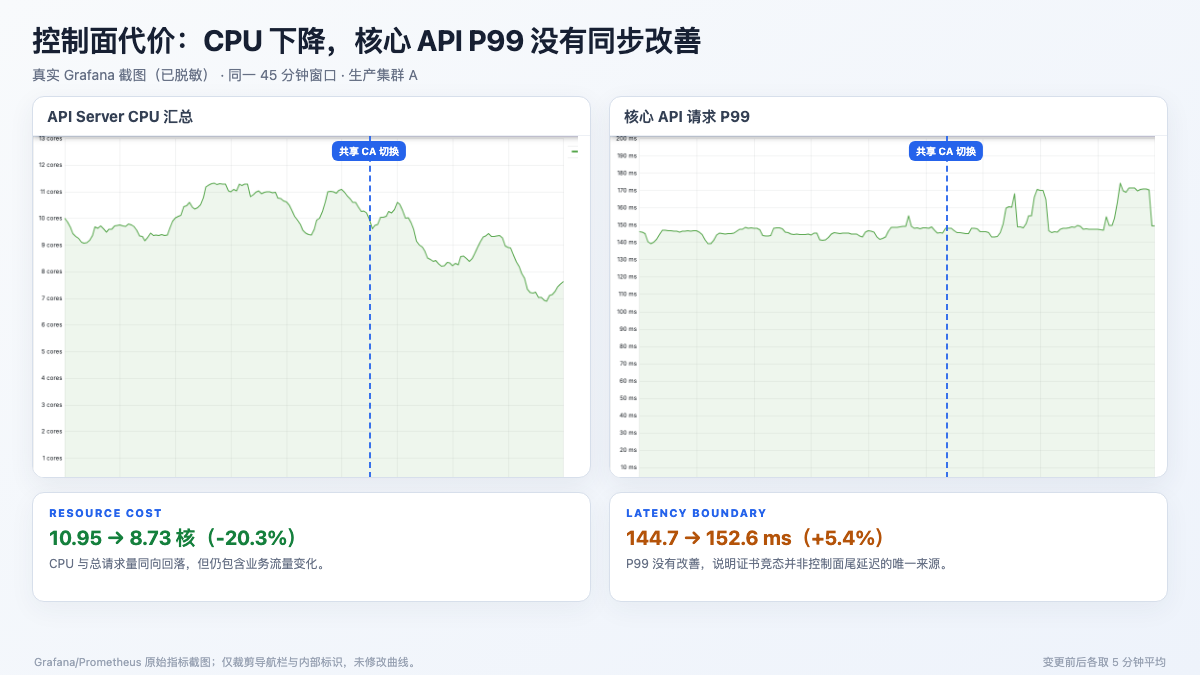
把 CPU 与 P99 放在一起看,可以避免只挑有利指标。API Server CPU 汇总下降了 20.3%,但核心请求 P99 从 144.7 ms 增至 152.6 ms。写放大确实消失了,控制面的其他延迟来源仍然存在。
Pod 和配置层面的验收结果是:
- 8/8 个副本 Ready,重启次数为 0;
- 所有 Pod 的 CA 和服务端证书哈希一致;
- 3 个 Mutating、2 个 Validating Webhook 的
caBundle均与 Secret 中的 CA 一致; - 两个 WebhookConfiguration 的
generation、resourceVersion在连续观察窗口内保持稳定; - 日志不再出现
object has been modified、证书同步失败或冲突重试; - 通过负载均衡入口连续发起 24 次 TLS 请求,全部返回 HTTP 200,客户端校验结果均为 0。
6. etcd 压力下降了,但还不能宣布问题解决
删除写放大后,etcd 成员汇总 Put 与 CPU 同时回落:
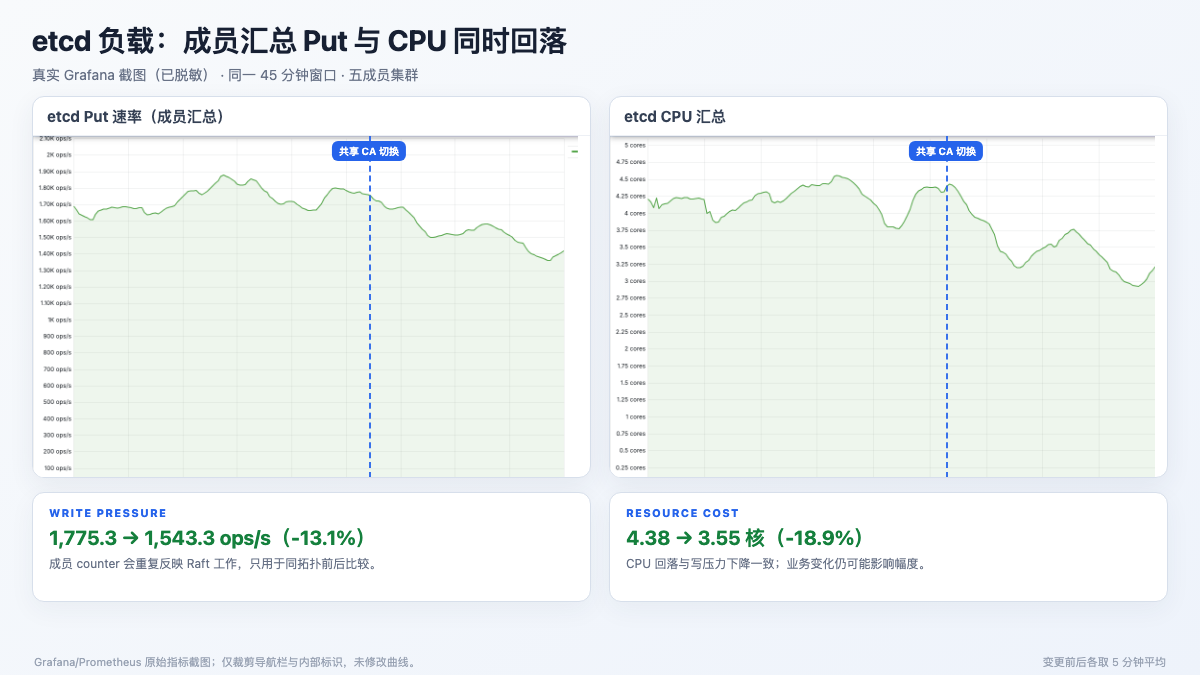
成员汇总 Put 从 1,775.3/s 降到 1,543.3/s,etcd CPU 从 4.38 核降到 3.55 核。两条曲线方向一致,但变化并非在切换点形成垂直断崖,因此只能说明压力在变更后回落,不能把全部降幅都归因于证书修复。
Slow Apply 也有所回落:
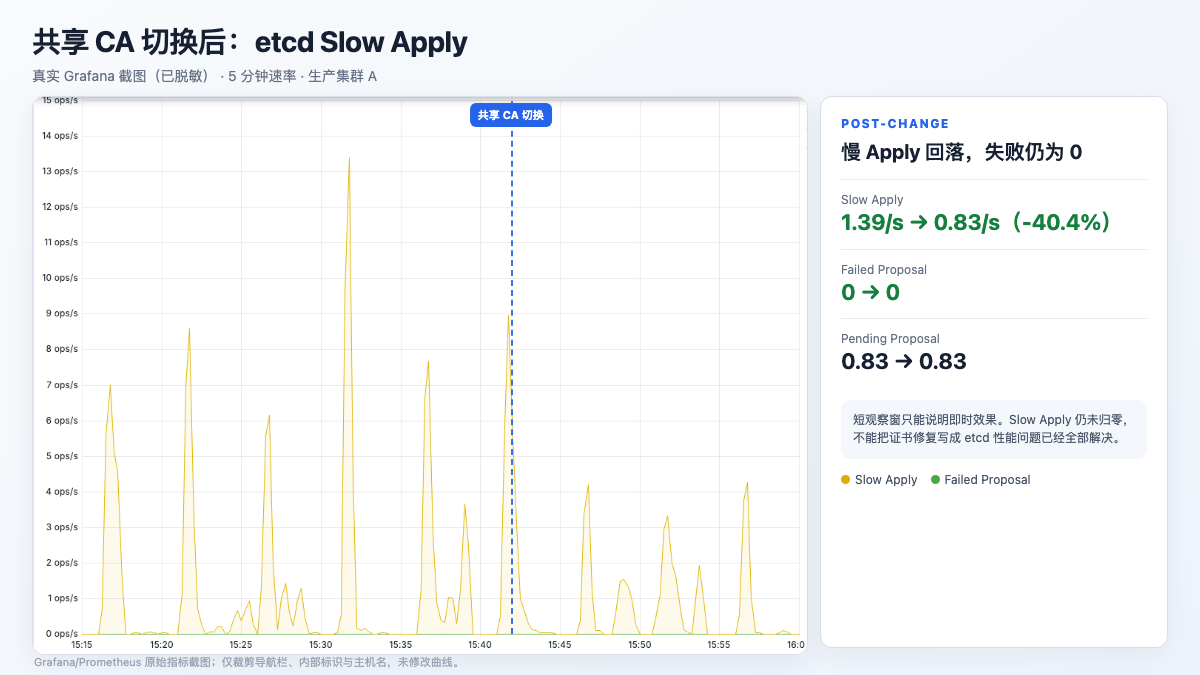
| 指标 | 变更前 | 变更后 | 判断 |
|---|---|---|---|
| etcd Slow Apply | 1.39/s | 0.83/s | 下降 40.4%,仍未归零 |
| Failed Proposal | 0 | 0 | 没有共识提交失败 |
| Pending Proposal | 0.83 | 0.83 | 基本不变 |
| etcd CPU 汇总 | 4.38 核 | 3.55 核 | 下降 18.9% |
| 最慢成员 Backend Commit P99 | 111.2 ms | 94.9 ms | 下降 14.7%,仍明显偏高 |
| WAL Fsync P99 | 约 0.99 ms | 约 0.99 ms | 基本不变 |
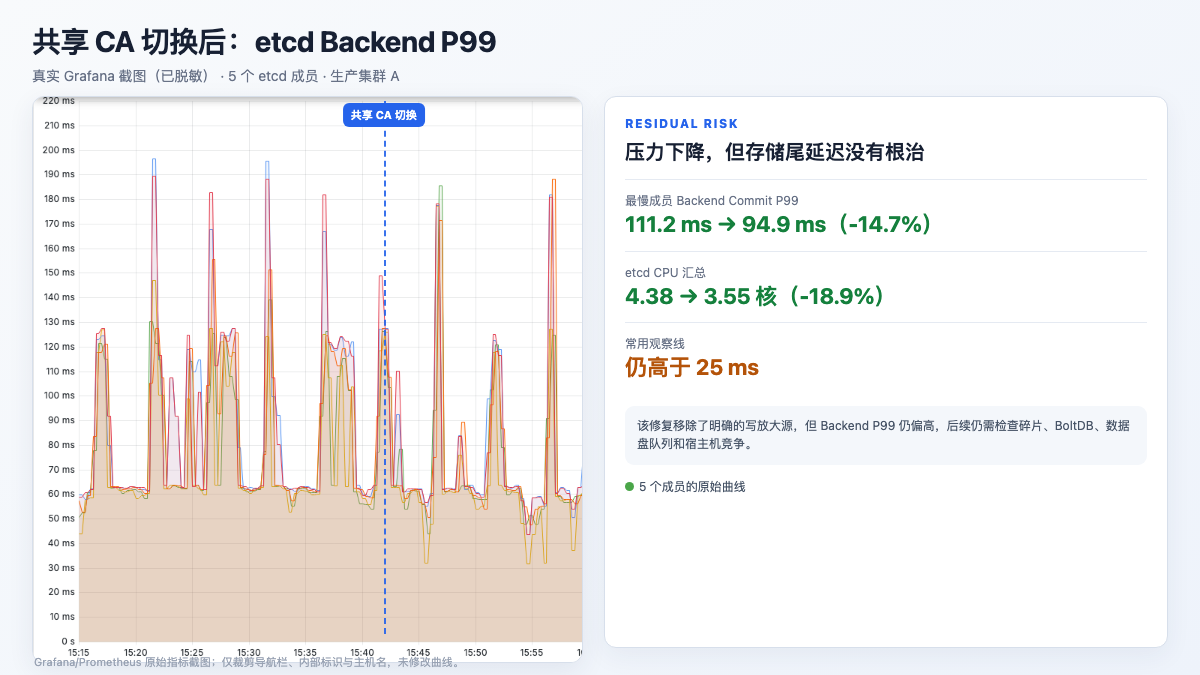
Backend Commit P99 在短窗口内下降,但依然远高于常用的 25 ms 观察线,而且曲线仍有明显尖峰。WAL Fsync 接近 1 ms,只能说明 WAL 路径没有同等程度的延迟,不能排除 BoltDB 数据文件、碎片、块设备队列、CPU 抢占或宿主机干扰。
还有一个常见口径错误:把 5 个 etcd 成员的 put_total 直接相加,会重复计算同一份 Raft 工作。本次成员汇总值从 1,775.3/s 降到 1,543.3/s,只适合在相同拓扑下比较相对变化,不能当作独立业务写入量。
因此,准确的结论是:共享 CA 修复移除了一个已经证实的控制面写放大源;它没有根治 etcd 的尾延迟。 后续仍需独立检查数据库碎片、数据盘 await 与队列、BoltDB 提交、CPU steal、NUMA 和同机进程竞争。
7. 如果改用 cert-manager
cert-manager 的可行结构是:
Certificate生成一份共享 TLS Secret;- 所有 Webhook Pod 使用同一份 Secret;
- cainjector 把同一个 CA 注入 Mutating/ValidatingWebhookConfiguration 的
caBundle。
cert-manager CA Injector支持向 MutatingWebhookConfiguration、ValidatingWebhookConfiguration、CRD Conversion Webhook 和 APIService 注入 CA。
关键不在于“有没有安装 cert-manager”,而在于证书和 caBundle 只能有一个明确的 Owner。如果 cainjector 与 Koordinator 自带控制器同时修改 caBundle,只是把原来的 8 个竞争者变成两类竞争者。采用 cert-manager 时,需要关闭内置的 CA 写入逻辑,或确保它只读取同一套证书且不会覆盖 cainjector 的结果。
8. 生产配置与告警建议
8.1 配置原则
- 多副本 Webhook 必须共享同一信任根和服务端证书来源;
- 证书生成、Secret 写入和
caBundle注入分别明确唯一 Owner; - 优先使用
clientConfig.service,让 Service DNS、Endpoint 和证书生命周期留在集群内;确需外部 URL 时,把 SAN、LB 摘流和探针协议纳入同一套变更; - 长有效期证书可以降低紧急轮换频率,但不能代替到期告警、自动轮换、双证书重叠和回滚演练;
- Webhook 不能无条件响应自身配置对象的 Update 事件;更新前应做语义比较,只在证书或规则真实变化时写入;
- 如果同步控制器支持 Leader Election,证书和全局配置协调器应只由 Leader 执行;Webhook HTTP Server 本身仍可多副本提供服务。
8.2 建议告警
# 稳定运行期出现 WebhookConfiguration PUT
sum(rate(apiserver_request_total{
  resource=~"mutatingwebhookconfigurations|validatingwebhookconfigurations",
  verb="PUT"
}[5m])) > 0

# WebhookConfiguration 更新冲突
sum(rate(apiserver_request_total{
  resource=~"mutatingwebhookconfigurations|validatingwebhookconfigurations",
  verb="PUT",
  code="409"
}[5m])) > 0
还应补充这些合成检查:
- 定期计算每个 Pod 的 CA、服务端证书哈希,发现不一致立即告警;
- 计算 Secret CA 与全部
caBundle的哈希,一处不一致就阻止继续发布; - 检查证书剩余有效期、SAN 和 EKU;
- 通过 Service 或 VIP 连续连接,确认所有后端都能通过 TLS 校验;
- 在支持对应指标的 Kubernetes 版本上,监控 Admission Webhook rejection、timeout、fail-open 和 latency;
- 为
generation或resourceVersion建立低频采样,检测无配置变更时的持续抖动。
9. 一份可执行的变更验收表
| 检查项 | 通过条件 | 失败后的动作 |
|---|---|---|
| 共享 Secret | CA、证书、私钥匹配,SAN/EKU 正确 | 不更新 Deployment |
| RBAC | ServiceAccount 能读取目标 Secret,权限不扩大 | 修正最小权限 |
| 滚动更新 | 全部副本 Ready,0 非预期重启 | 暂停 rollout,保留旧 ReplicaSet |
| Pod 证书 | 所有 CA/cert 哈希一致 | 找出仍使用文件 Writer 的副本 |
| 配置 CA | 每个 Webhook 的 caBundle 与 Secret CA 一致 |
停止接流,恢复上一版本 |
| 配置稳定性 | generation、resourceVersion 不再高频变化 |
检查其他写入者和 cainjector |
| 直接指标 | PUT、409 接近 0 | 检查 Writer、事件自激和冲突重试 |
| TLS 入口 | 连续请求覆盖全部后端,校验全部成功 | 检查 SAN、证书链和旧后端摘流 |
| Admission 语义 | Mutation/Validation 实际生效 | 不把 HTTP 200 当作成功 |
| 控制面 | 5xx、429、P99、etcd proposal 不恶化 | 回滚并保存变更窗口证据 |
这类事故最容易被误判成“etcd 性能差”或“集群规模太大”。排障顺序应该反过来:先找到谁在制造重复写入,再评估 etcd 是否仍有独立问题。否则即使扩容控制面,8 个副本争抢同一个 caBundle 的逻辑也不会改变。